Оптимізація витратРозбір
Бюджет довгого агентського проєкту: обчислення проти токенів (кейс RSA-260)
Заголовок про $400k для RSA-260 — це оренда GPU, а не токени моделі. Розділіть довгий агентський проєкт на три бюджетні рядки й оцініть частину токенів як сесії × кроки × токени.
На цій сторінці
Ця цифра ~$400k з факторизації RSA-260 від Cognition — це оренда GPU, а не рахунок за модель. У звіті взагалі не оцінюється агентська частина, тож якщо ви плануєте довгий агентський проєкт, ви самі оцінюєте рядок токенів: сесії × кроки × токени на крок, за живими цінами. Саме це робить решта цієї сторінки.
Джерело — стаття Cognition від Eric Lu, інженера Cognition (Factoring RSA-260, опублікована 9 вересня 2026, перевірена 6 листопада 2026). Її поширюють із доларовою цифрою в заголовку, і цю цифру легко прочитати неправильно.
За що насправді платять $400k#
Автор факторизував 260-значне число методом GNFS, використовуючи сильно модифікований CADO-NFS, що працює на GPU. У звіті наведено час GPU для кожної фази:
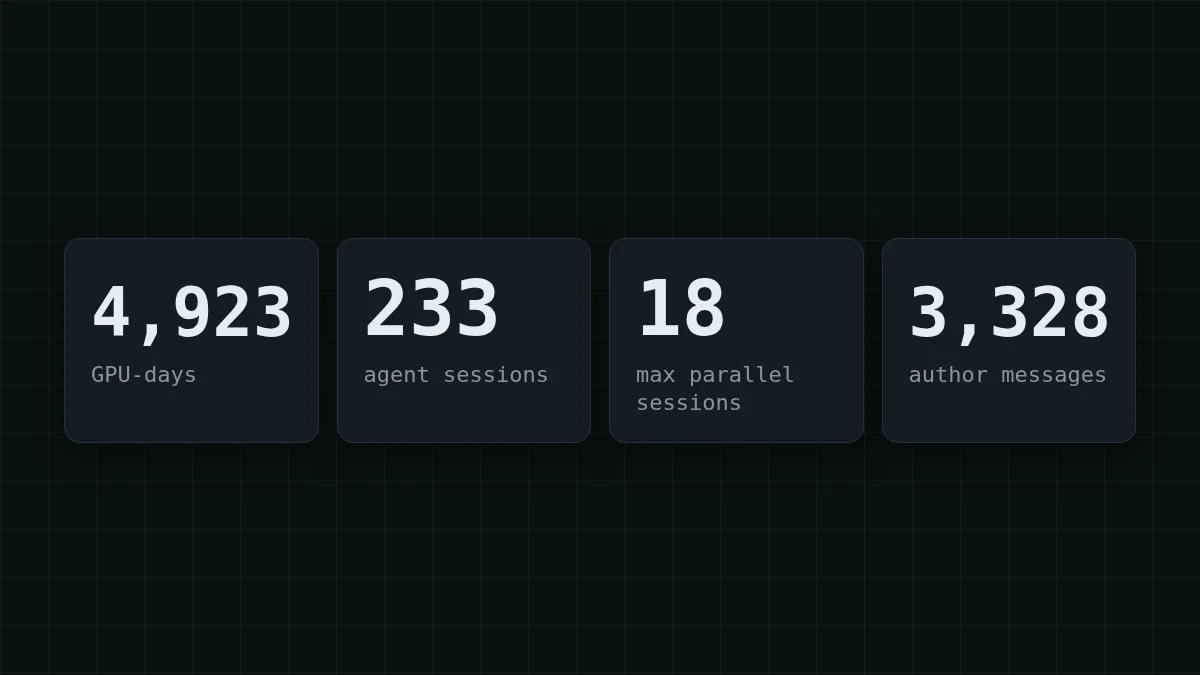
- вибір полінома: 643 GPU-дні
- просіювання: 3 813 GPU-днів
- розв'язування лінійної системи: 467 GPU-днів
Разом 643 + 3 813 + 467 = 4 923 GPU-дні, що у звіті округлено до ~4 900. За припущеною у звіті ціною $3.50 за GPU-годину:
4 923 × 24 × 3.50 = 413 532
Це збігається з цифрою $414k для GPU у додатку. Отже, заголовок — це орендоване обладнання, яке тижнями виконує обчислювальну роботу. Жодних токенів моделі в цій сумі немає.
Швидка перевірка
Що таке цифра ~$400k у звіті про RSA-260?
Показати відповідь
Відповідь: Оренда GPU за ринковою ціною для факторизації
Вона походить від GPU-днів × $3.50 за GPU-годину. У звіті не названо жодної моделі й не наведено кількості токенів для агентської частини.
Що робили агенти і про що звіт мовчить#
Агентська частина описана діяльністю, а не вартістю. Перший запит надіслано 13 серпня 2026, робота тривала близько трьох тижнів, а цифри такі:
- 233 сесії Devin для факторизації, у середньому 3 працювали паралельно, 18 на піку
- 192 з них отримали повідомлення від автора, 36 працювали без жодного втручання людини
- 101 дочірню сесію запущено іншими сесіями
- Власний облік Devin: 14 450 ACU (це одиниця Devin, а не токени)
Сесії займалися вимірюваннями, операціями з кластером, налаштуванням і налагодженням. Людина встановлювала пріоритети й будувала бенчмарки. Дві чесні деталі від автора: декомпозицію навколо CADO-NFS спроєктувала людина, і вона була критично важливою, а агенти тим більше заплутувалися, чим далі код відходив від upstream.
Бракує саме того, що потрібно для бюджету: які моделі, скільки токенів. Тож не намагайтеся вивести рахунок за токени з 14 450 ACU. Будь-що в інтернеті, що це робить, — це здогадка.
Третій рядок: людське керування#
Автор надіслав 3 328 повідомлень, загалом 82 702 слова. Це 82 702 ÷ 3 328 ≈ 25 слів на повідомлення — короткі підказки, а не есе. Ці слова майже нічого не коштують у токенах. Вони коштують уваги: хтось має читати, що зробили агенти, і вирішувати, що далі. Коли ви бюджетуєте агентський проєкт, виносьте це в окремий рядок у годинах, а не в доларах за використання API.
Отже, довгий агентський проєкт має три рядки:
Прокрутіть таблицю праворуч →
| Рядок | У звіті про RSA-260 | Що визначає його для вас |
|---|---|---|
| Обчислення | ~$414k часу GPU за ціною $3.50 за GPU-годину | Сама ваша робота: збірки, тести, тренування, симуляції |
| Токени моделі | Не вказано | Сесії × кроки × токени на крок |
| Людське керування | 3 328 повідомлень за ~3 тижні | Як часто ви переглядаєте й перенаправляєте |
Оцініть свій рядок токенів#
Ось формула і те, що люди забувають: кожен крок повторно надсилає історію. Агент не пам'ятає сесію; кожен виклик несе завдання, файли, які він прочитав, і вивід інструментів на цей момент. Саме тому вхідні токени зазвичай значно перевищують вихідні (докладніше в чому AI-агенти використовують так багато токенів).
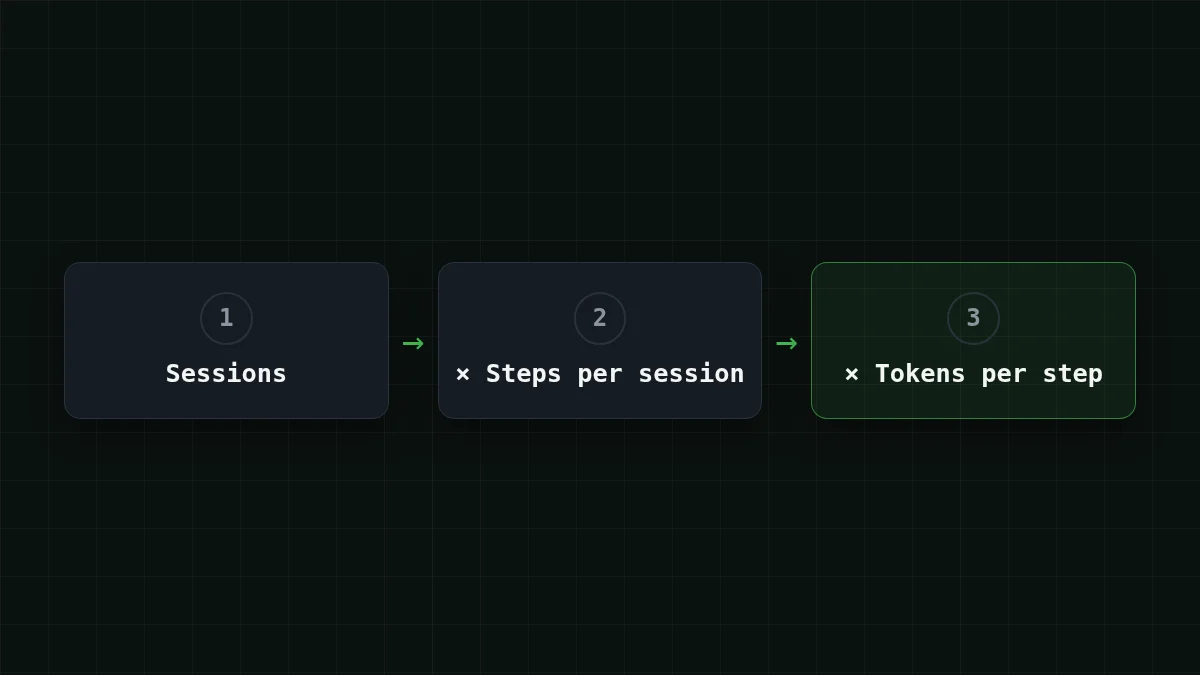
Припустімо, ви плануєте проєкт розміром як у Cognition, 233 сесії, і припускаєте 60 кроків на сесію. Ці два числа — припущення цієї сторінки, а не дані Cognition. Тоді:
233 × 60 = 13 980
це 13 980 викликів моделі. Тепер розмір одного виклику. Припустімо, середній крок надсилає 60 000 токенів на вході (завдання, історія, файл-два) і отримує 1 500 токенів назад (команда або патч). Підсумки:
60 000 × 13 980 = 838 800 000
1 500 × 13 980 = 20 970 000
Отже, близько 839 млн вхідних токенів і 21 млн вихідних. Вхід у сорок разів більший за вихід, і саме там живе ваш бюджет. На DeepSeek-V4-Flash цей проєкт коштує $14.68, а одна сесія з 60 кроків — $0.063. Ось те саме навантаження на кожній моделі, поруч із довідкою OpenRouter:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 13 980 запитів | OpenRouter, 13 980 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
60 000 вхідних і 1 500 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Якщо рахувати загалом, разом вхід і вихід, кожна з наших моделей для цього навантаження виходить дешевшою за OpenRouter. Ціни живі з сторінки цін, тож таблиця змінюється разом із тарифами.
Спробуйте саміСпробуйте: сесія з 60 кроків у середньому має 60 000 токенів на вході. Чи надсилає крок 1 стільки ж, скільки крок 60?Показати відповідь
Ні. Крок 1 надсилає мало (завдання і кілька файлів), крок 60 повторно надсилає все, зібране дорогою. Беручи 60 000 як середнє, ви припускаєте, що сесія починається малою і закінчується близько 100K або більше. Якщо ви знаєте, що ваші сесії закінчуються, скажімо, на 120K, середнє — приблизно половина цього, тож вимірюйте найбільший запит, а не лише середнє.
Отримайте власні цифри за десять хвилин#
Припущення — лише відправна точка. Запустіть одну реальну сесію вашого завдання на дешевій моделі й прочитайте об'єкт usage, який API повертає в кожній відповіді. OpenAI-сумісні ендпоінти повідомляють prompt_tokens і completion_ на кожен виклик:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
Підсумуйте usage за всю сесію, поділіть на кількість викликів і замініть 60 000 і 1 500 вище на свої середні. Деталі налаштування — у документації CheapTokens; відстеження по кроках у коді — у відстеженні вартості токенів AI-агента в Python. Для тієї ж арифметики на одній сесії з 50 кроків дивіться вартість агентської сесії на GLM, DeepSeek або MiniMax.
Для довгих циклів DeepSeek-V4-Flash має вікно контексту 380K і до 32 768 вихідних токенів на відповідь, з однією ціною в будь-яку годину. GLM-5.3-Flash має вікно 390K, а MiniMax-M2.7 — 180K, тож перевірте, що ваш найбільший запит уміщується.
Оберіть свій випадок
Який проєкт схожий на ваш?
Виберіть варіант, щоб побачити відповідь
Багато коротких сесій
Малі завдання, кожне починається з нуля: вхід на виклик залишається низьким. Помножте сесії на кроки й очікуйте, що загальна сума визначатиметься кількістю викликів, а не їхнім розміром.
Кілька дуже довгих сесій
Історія зростає протягом сесії, тож останні кроки — дорогі. Оцінюйте за найбільшим запитом, розбивайте роботу на дочірні сесії з коротким брифом кожна, і вхід перестане накопичуватися.
Важкі обчислення плюс агенти
Як RSA-260: сама робота потребує обладнання. Оцініть обладнання погодинно у вашого провайдера й тримайте рядок токенів як окрему оцінку. Вони не додаються в голові, лише в таблиці.
Звужте завдання, перш ніж підвищувати бюджет#
У звіті є ще один урок, що пасує до бюджету: чим далі код відходив від upstream, тим більше заплутувалися агенти. Заплутані агенти роблять більше кроків. Якщо ваша оцінка виглядає зависокою, спершу скоротіть кроки на сесію: чіткіший бриф, менша ділянка коду, фіксовані кроки, винесені в скрипти (див. чи потрібна агентам модель на кожному кроці). Зменшення кроків удвічі зменшує рядок токенів удвічі; це найлегший важіль, який у вас є.


