AI для початківцівПосібник
Чи потрібна агентам модель на кожному кроці? Винесіть фіксовані кроки в код
Чому кожен результат інструмента спричиняє ще один виклик моделі, які кроки агента можуть бути звичайним кодом і скільки коштує цикл із 3 кроків з і без зайвого виклику.
На цій сторінці
Ваш агент працював десять хвилин, а рахунок більший за саму задачу. Дуже часто причина банальна: після кожного результату інструмента обв'язка знову викликає модель, навіть коли наступний крок був очевидний.
Тож ні, агенту не потрібна модель на кожному кроці. Вона потрібна там, де щось треба вирішити. Крок, який завжди однаковий, як-от запуск тестів після успішного білда, може бути звичайним правилом у вашому коді.
Є грошова причина цим перейматися. Кожен зайвий виклик перечитує весь контекст як вхідні токени (стаття про довгі чати пояснює чому), тож пропущений виклик економить більше, ніж його власна коротка відповідь. Якщо сам цикл для вас новий, почніть з того, як працює AI-агент і повертайтеся.
Чому один результат інструмента означає ще один виклик моделі#
Модель нічого не запускає. Вона пише «будь ласка, запусти make build», ваша обв'язка (програма навколо моделі) запускає це, вставляє вивід у розмову і знову викликає модель з усім, що було досі. Ось і весь цикл. Модель дізнається, що повернув інструмент, лише коли ви її викликаєте.
Уявіть нового колегу, який після кожного кроку телефонує менеджеру з питанням «а тепер?», хоча в чеклісті написано «після компіляції запусти тести». Менеджер щоразу відповідає те саме, і кожен виклик коштує хвилини читання всієї історії з початку.
Ось як це виглядає в лозі агента. Скажімо, задача — «виправити тест, що падає»:
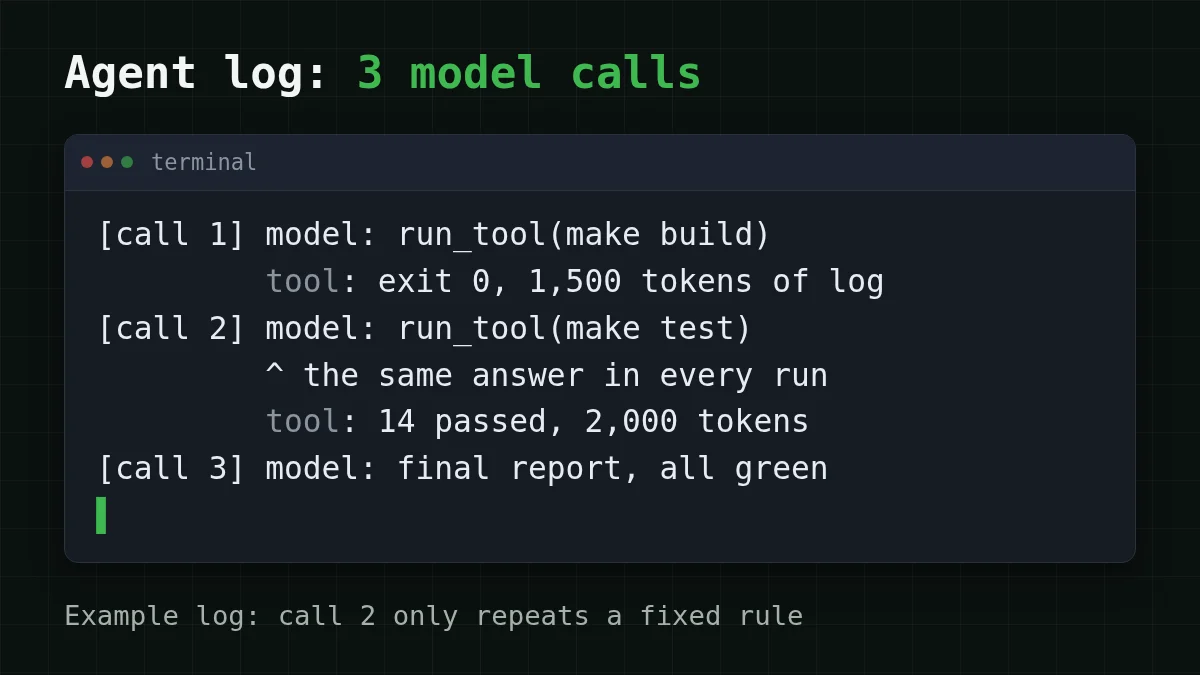
Виклик 2 — найцікавіший. Білд пройшов, наступний крок завжди тести, і модель витрачає повне читання контексту, щоб сказати «запусти тести». Виклики 1 і 3 інші: виклик 1 обирає, як почати, виклик 3 читає результати тестів і пише звіт. Це справжня робота.
Які кроки потребують рішення, а які фіксовані#
Три питання впорядковують більшість кроків:
- Чи визначається наступна дія чітким сигналом, як-от код виходу, HTTP-статус або «знайдено / не знайдено»?
- Чи це та сама дія щоразу, коли з'являється цей сигнал?
- Чи дешево відкотити помилкове припущення?
Три «так»: запишіть це як правило. Інакше модель зберігає крок.
Другий приклад, поза програмуванням. Скажімо, ви запускаєте скрипт підтримки: клієнт пише, скрипт шукає замовлення, потім відповідає. Пошук замовлення за номером — це код. Заповнення «Ваше замовлення {id} — {status}» з шаблону теж код. Читання «воно прийшло зламаним, що тепер?» і вибір між поверненням коштів, заміною та вибаченням — це судження, тож це один виклик моделі, а не три.
З'єднайте пари
Хто має обробляти кожен крок?
Торкніться елемента ліворуч, потім його пари
- Білд завершився з кодом виходу 0, і наступний крок завжди тестиКод: наступний крок фіксований
- Тести впали зі стек-трейсом; який файл потребує зміни?Модель: нове судження
- Замовлення знайдено за номером, тепер вставте його статус у шаблон відповідіКод: заповнити шаблон
- Клієнт пише «воно прийшло зламаним, що тепер?»Модель: читання вільного тексту
Один запобіжник робить це безпечним: правило охоплює лише щасливий шлях. Білд впав з кодом виходу 1? Тести червоні? Інструмент повернув щось, чого правило не очікувало? Поверніть керування моделі, точно як раніше. Ви прибираєте виклики, які мали лише одну можливу відповідь, а не виводите модель із циклу.
Цикл із 3 кроків, з і без зайвого виклику#
Поставмо цифри на лог «виправити тест, що падає». Припущення, усі наші й легко замінити на ваші:
- системний промпт плюс задача: 3 000 токенів
- лог білда: 1 500 токенів; лог тестів: 2 000 токенів
- відповідь, що лише просить інструмент: 60 токенів; фінальний звіт: 300 токенів
Вгадайте число
Якщо запуск тестів переходить у код, скільки викликів моделі робить цикл?
Ваше припущення
06
Показати відповідь
Відповідь: 2
Два: один, щоб почати білд, один, щоб прочитати обидва результати й написати звіт. Запуск тестів більше не потребує рішення.
Модель на кожному кроці. Виклик 1 читає 3 000 токенів. Виклик 2 читає 3 000 + 60 + 1 500 = 4 560. Виклик 3 читає 4 560 + 60 + 2 000 = 6 620. Вхідних усього: 3 000 + 4 560 + 6 620 = 14 180 токенів; вихідних: 60 + 60 + 300 = 420.
Запуск тестів у коді. Виклик 1 читає 3 000 токенів. Обв'язка запускає білд, потім тести за правилом, і виклик 2 читає 3 000 + 60 + 1 500 + 2 000 = 6 560. Вхідних усього: 3 000 + 6 560 = 9 560 токенів; вихідних: 60 + 300 = 360.
Різниця — 14 180 − 9 560 = 4 620 вхідних токенів, близько третини входу, плюс одна коротка відповідь. На DeepSeek-V4-Flash одна така задача коштує $0.00025 першим способом і $0.00018 другим. Одна задача — це похибка округлення. Скажімо, ваш агент робить 500 таких на день (14 180 × 500 = 7 090 000 вхідних токенів, 420 × 500 = 210 000 вихідних токенів проти 4 780 000 і 180 000):
Розрив зростає з контекстом: чим довші логи, які тягне за собою модель, тим цінніше пропущене перечитування. Ось той самий цикл поруч:
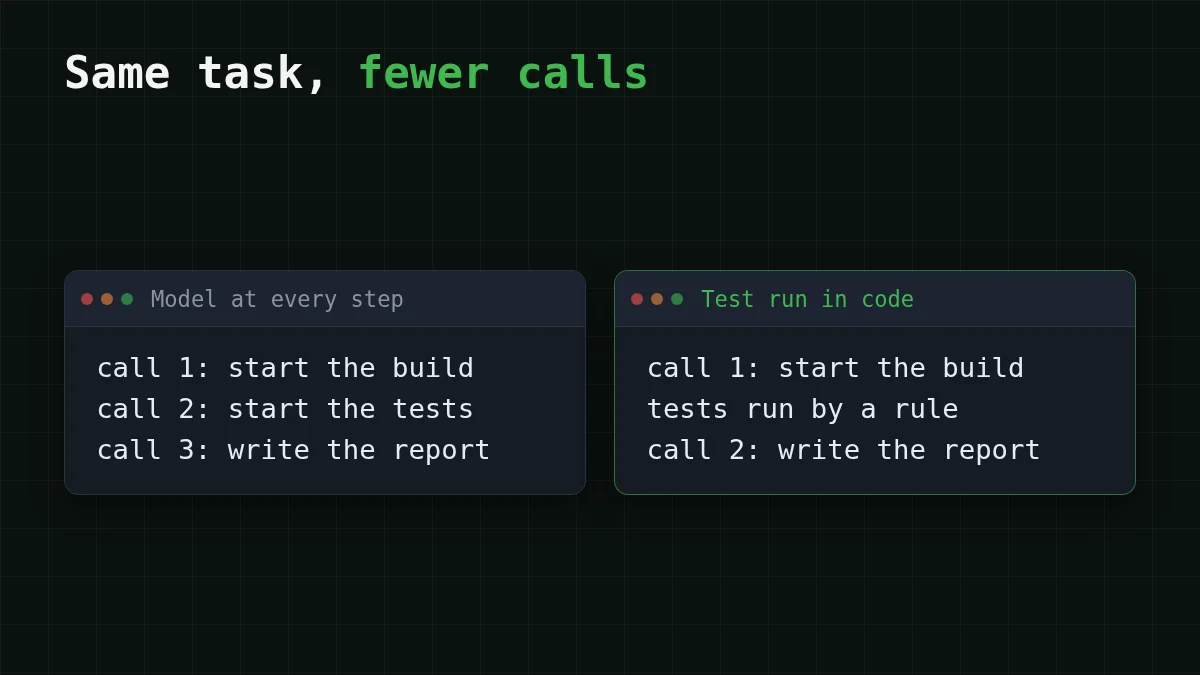
У коді правило — це кілька рядків. Це псевдокод, назви хелперів — ваші:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
Що повідомляють автори HarnessMM#
Ідея не лише наша. HarnessMM — це препринт на arXiv (arXiv:2610.32813, подано 23 жовтня 2026 року, перевірено 2 листопада 2026 року) від Yuhua Jiang, Chang Xu, Feifei Gao і Li Zhao. Їхнє спостереження: обв'язки агентів часто викликають модель знову після зворотного зв'язку від інструмента, навіть коли попередній виклик уже визначив наступну дію. Їхнє виправлення, guarded decision reuse, відтворює це рішення і повертається до оригінальної моделі, коли з'являється нове семантичне рішення, докази не підтверджують його або селектор утримується. Наведений вище if — це написана вручну версія тієї самої ідеї; як вирішує їхній запобіжник, описано в статті.
Автори повідомляють такі результати на HumanEval:
- Обв'язка Codex: 66,72k → 47,02k токенів на задачу (−29,54%), успішність без змін — 90,82%.
- DeepSeek Harness: 96,28k → 11,62k токенів на задачу (−87,93%), успішність 71,43% → 85,71%.
Читайте їх обережно. Це один бенчмарк, власна обв'язка авторів, препринт без рецензування, і на сторінці arXiv не вказано коду. У переказах ви можете побачити «88%»: це лише показник DeepSeek Harness, а показник Codex — близько 30%. Сприймайте обидва як напрямок, а не як обіцянку для вашого агента. Ваш власний лог скаже вам більше.
Перевірте власного агента за десять хвилин#
Увімкніть лог кожного виклику моделі з числами usage з кожної відповіді (відстеження вартості токенів агента в Python показує один спосіб). Потім прочитайте останні двадцять запусків і позначте кожен виклик: рішення чи фіксований. Виклик — кандидат, коли наступна дія жодного разу не змінювалася протягом цих запусків. Що показує ваш лог?
Оберіть свій випадок
Що показує ваш лог?
Виберіть варіант, щоб побачити відповідь
Та сама пара викликів у кожному запуску
Там ховається фіксоване правило. Запишіть його як if на чіткому сигналі, як-от код виходу, і залиште модель як запасний варіант, коли сигнал будь-який неочікуваний.
Виклики, що лише переформатують або копіюють вивід інструмента
Перенесіть їх у шаблон у коді. Якщо текст справді потребує моделі, це дрібна робота для дешевої моделі, а не для вашої найбільшої.
Виклики, де наступний крок змінюється залежно від вмісту
Залиште модель тут. Для цього вона й потрібна, і дешевша модель часто впорається з простим кроком класифікації та вибору; див. маршрутизація моделей: спершу дешева модель.
Кожен виклик перечитує величезний лог
Скоротіть те, що повертається в розмову: тримайте вивід інструментів поза контекстом. Та сама задача стає дешевшою без видалення жодного виклику.
Якщо хочете спробувати це на моделі з довгим контекстом, CheapTokens надає DeepSeek-V4-Flash (deepseek-) для циклів агентів: одна ціна в будь-яку годину, контекст 380K і до 32 768 вихідних токенів на відповідь. Для кроків, які все ще потребують рішення, є GLM-5.3-Flash (zai-) з контекстом 390K. Обидві працюють через API, сумісний з OpenAI та Anthropic, за адресою https:/, з одним балансом для всіх моделей. Налаштування — у документації, ціни — на сторінці цін, а сторінка моделі — дешевий DeepSeek.


