Kailangan ba ng agents ang modelo sa bawat hakbang? Ilagay sa code ang mga fixed na hakbang
Bakit ang bawat tool result ay nag-trigger ng isa pang model call, aling mga hakbang ng agent ang maaaring maging plain code, at magkano ang 3-step loop may at walang dagdag na tawag.
Sa pahinang ito
Tumakbo ang agent mo nang sampung minuto, at mas malaki pa ang bill kaysa sa gawain. Kadalasan, boring ang dahilan: pagkatapos ng bawat tool result, tinatawag muli ng harness ang modelo, kahit halata na ang susunod na hakbang.
Kaya hindi, hindi kailangan ng agent ang modelo sa bawat hakbang. Kailangan nito ang modelo kung saan may kailangang desisyunan. Ang hakbang na palaging pareho, tulad ng pagpapatakbo ng tests pagkatapos ng build na pumasa, ay maaaring maging simpleng rule sa code mo.
May dahilang pera para pansinin ito. Bawat dagdag na tawag ay muling binabasa ang buong context bilang input tokens (ipinapakita ng long-chat article kung bakit), kaya ang na-skip na tawag ay nakakatipid nang higit pa sa sarili nitong maikling sagot. Kung bago pa sa iyo ang loop mismo, magsimula sa paano gumagana ang AI agent at bumalik.
Bakit ang isang tool result ay isa pang model call#
Hindi kailanman nagpapatakbo ng kahit ano ang modelo. Nagsusulat ito ng "please run make build", pinapatakbo ito ng harness mo (ang programang nakapalibot sa modelo), ipinapasok ang output sa usapan at tinatawag muli ang modelo kasama ang lahat ng nasa ngayon. Iyon ang buong loop. Natututunan lang ng modelo kung ano ang ibinalik ng tool kapag tinawag mo ito.
Isipin ang isang bagong kasamahan na tumatawag sa manager pagkatapos ng bawat hakbang para itanong "at ngayon?", kahit nakasulat sa checklist na "pagkatapos mag-compile, patakbuhin ang tests". Pareho ang isinasagot ng manager sa bawat pagkakataon, at ang bawat tawag ay gumugugol ng isang minuto sa pagbasa ng buong kuwento mula sa simula.
Ganito iyon sa isang agent log. Sabihin nating ang gawain ay "ayusin ang failing test":
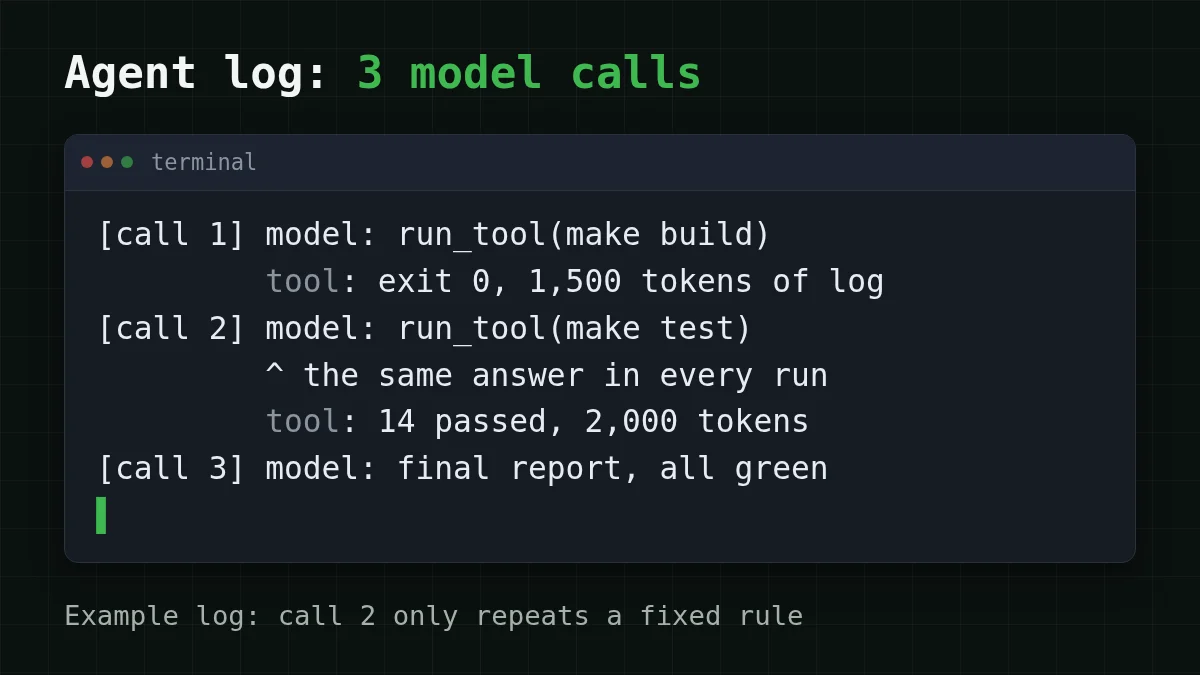
Ang call 2 ang kawili-wili. Pumasa ang build, ang susunod na hakbang ay palaging ang tests, at gumugugol ang modelo ng buong pagbasa ng context para sabihing "patakbuhin ang tests". Magkaiba ang call 1 at call 3: pinipili ng call 1 kung paano magsisimula, binabasa ng call 3 ang test results at nagsusulat ng report. Iyon ang tunay na trabaho.
Aling mga hakbang ang nangangailangan ng desisyon at alin ang fixed#
Tatlong tanong ang nag-aayos sa karamihan ng hakbang:
- Ang susunod na aksyon ba ay napagdesisyunan ng malinaw na signal, tulad ng exit code, HTTP status o "found / not found"?
- Pareho ba itong aksyon sa tuwing lumalabas ang signal na iyon?
- Mura ba itong i-undo kung mali ang hula?
Tatlong oo: isulat ito bilang rule. Kung hindi, panatilihin ng modelo ang hakbang.
Pangalawang halimbawa, sa labas ng coding. Sabihin nating nagpapatakbo ka ng support script: may sumulat na customer, hinahanap ng script ang order, tapos sumasagot. Ang paghahanap ng order sa pamamagitan ng numero nito ay code. Ang pagpuno ng "Your order {id} is {status}" mula sa template ay code din. Ang pagbasa ng "it arrived broken, what now?" at pagpili sa pagitan ng refund, replacement at apology ay judgment, kaya isang model call iyon, hindi tatlo.
Itugma ang mga pares
Sino ang dapat humawak sa bawat hakbang?
I-tap ang isang item sa kaliwa, pagkatapos ang pares nito
- Natapos ang build na may exit code 0, at ang susunod na hakbang ay palaging ang testsCode: fixed ang susunod na hakbang
- Nabigo ang tests na may stack trace; aling file ang kailangang baguhin?Model: bagong judgment
- Natagpuan ang order sa numero, ngayon ilagay ang status nito sa reply templateCode: punan ang template
- Sumulat ang customer ng "it arrived broken, what now?"Model: pagbasa ng free text
Isang guard ang nagpapaligtas dito: ang rule ay sumasaklaw lamang sa happy path. Nabigo ang build na may exit code 1? Pula ang tests? May ibinalik ang tool na hindi inaasahan ng rule? Ibalik ang kontrol sa modelo, eksaktong tulad ng dati. Tinatanggal mo ang mga tawag na may isang posibleng sagot lamang, hindi mo inaalis ang modelo sa loop.
Isang 3-step loop, may at walang dagdag na tawag#
Lagyan natin ng numero ang "fix the failing test" log. Ang mga assumption, lahat sa amin at madaling palitan ng sa iyo:
- system prompt kasama ang task: 3,000 tokens
- build log: 1,500 tokens; test log: 2,000 tokens
- isang sagot na humihingi lang ng tool: 60 tokens; ang final report: 300 tokens
Hulaan ang numero
Kung lilipat ang test run sa code, ilang model call ang gagawin ng loop?
Ang iyong hula
06
Ipakita ang sagot
Sagot: 2
Dalawa: isa para simulan ang build, isa para basahin ang parehong resulta at isulat ang report. Hindi na kailangan ng desisyon ang test run.
Modelo sa bawat hakbang. Ang call 1 ay nagbabasa ng 3,000 tokens. Ang call 2 ay nagbabasa ng 3,000 + 60 + 1,500 = 4,560. Ang call 3 ay nagbabasa ng 4,560 + 60 + 2,000 = 6,620. Kabuuang input: 3,000 + 4,560 + 6,620 = 14,180 tokens; output: 60 + 60 + 300 = 420.
Test run sa code. Ang call 1 ay nagbabasa ng 3,000 tokens. Pinapatakbo ng harness ang build, tapos ang tests ayon sa rule, at ang call 2 ay nagbabasa ng 3,000 + 60 + 1,500 + 2,000 = 6,560. Kabuuang input: 3,000 + 6,560 = 9,560 tokens; output: 60 + 300 = 360.
Ang pagkakaiba ay 14,180 − 9,560 = 4,620 input tokens, mga isang katlo ng input, dagdag pa ang isang maliit na sagot. Sa DeepSeek-V4-Flash, ang isang ganoong gawain ay nagkakahalaga ng $0.00025 sa unang paraan at $0.00018 sa pangalawa. Ang isang gawain ay rounding error lang. Sabihin nating 500 ang ginagawa ng agent mo bawat araw (14,180 × 500 = 7,090,000 input tokens, 420 × 500 = 210,000 output tokens kumpara sa 4,780,000 at 180,000):
Lumalaki ang agwat kasabay ng context: habang mas mahaba ang mga log na hinihila ng modelo, mas malaki ang halaga ng na-skip na muling pagbasa. Narito ang parehong loop nang magkatabi:
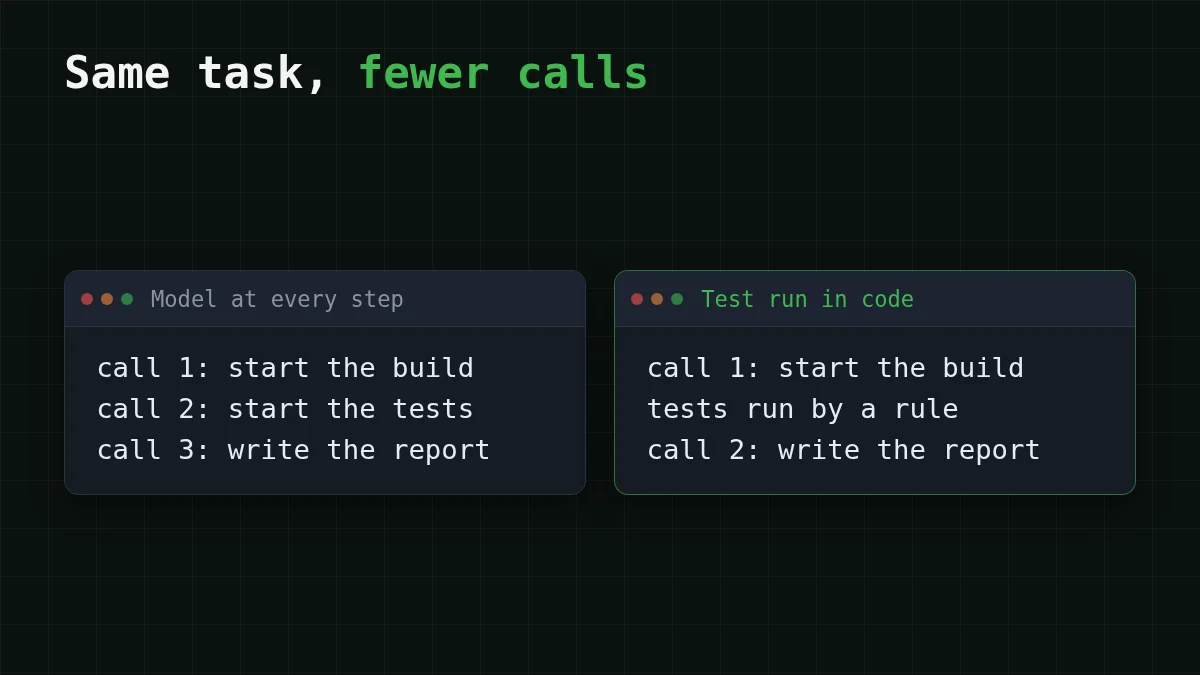
Sa code, ang rule ay ilang linya lang. Ito ay pseudo-code, sa iyo ang mga pangalan ng helper:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
Ano ang iniuulat ng mga may-akda ng HarnessMM#
Hindi lang amin ang ideya. Ang HarnessMM ay isang preprint sa arXiv (arXiv:2610.32813, isinumite noong 23 Oktubre 2026, sinuri noong 2 Nobyembre 2026) nina Yuhua Jiang, Chang Xu, Feifei Gao at Li Zhao. Ang kanilang obserbasyon: madalas na tinatawag muli ng agent harnesses ang modelo pagkatapos ng tool feedback kahit natukoy na ng naunang tawag ang susunod na aksyon. Ang kanilang solusyon, guarded decision reuse, ay inuulit ang desisyong iyon at bumabalik sa orihinal na modelo kapag may bagong semantic decision, hindi sinusuportahan ang ebidensya o nag-abstain ang selector. Ang if sa itaas ay ang kamay na isinulat na bersyon ng parehong ideya; kung paano nagpapasya ang kanilang guard ay nasa papel.
Iniuulat ng mga may-akda ang mga resultang ito sa HumanEval:
- Codex harness: 66.72k → 47.02k tokens bawat gawain (−29.54%), hindi nagbago ang success sa 90.82%.
- DeepSeek Harness: 96.28k → 11.62k tokens bawat gawain (−87.93%), success 71.43% → 85.71%.
Basahin ang mga ito nang may pag-iingat. Isang benchmark lang ito, sariling harness ng mga may-akda, isang preprint na hindi pa peer-reviewed, at walang code na nakalista sa arXiv page. Baka makita mo ang "88%" sa mga muling pagkukuwento: figure lang iyon ng DeepSeek Harness, ang sa Codex ay mga 30%. Ituring ang dalawa bilang direksyon, hindi bilang pangako para sa agent mo. Mas marami ang sinasabi ng sarili mong log.
Suriin ang sarili mong agent sa sampung minuto#
I-on ang log ng bawat model call, kasama ang usage na numero mula sa bawat response (ipinapakita ng tracking agent token cost in Python ang isang paraan). Pagkatapos, basahin ang huling dalawampung run at markahan ang bawat tawag: decision o fixed. Ang isang tawag ay kandidato kapag hindi nagbago ang susunod na aksyon sa mga run na iyon. Ano ang sinasabi ng log mo?
Piliin ang iyong kaso
Ano ang sinasabi ng log mo?
Pumili ng opsyon upang makita ang sagot
Ang parehong pares ng tawag sa bawat run
May nakatagong fixed rule doon. Isulat ito bilang if sa isang malinaw na signal, tulad ng exit code, at panatilihin ang modelo bilang fallback kapag may hindi inaasahang signal.
Mga tawag na nagre-reformat lang o kumokopya ng tool output
Ilipat ang mga ito sa template sa code. Kung talagang kailangan ng modelo ang teksto, maliit na trabaho iyon para sa murang modelo, hindi para sa pinakamalaki mo.
Mga tawag kung saan nagbabago ang susunod na hakbang ayon sa nilalaman
Panatilihin ang modelo dito. Ito ang para sa kanya, at kadalasan ay kayang hawakan ng mas murang modelo ang simpleng classify-and-pick na hakbang; tingnan ang model routing: cheap model first.
Bawat tawag ay muling nagbabasa ng malaking log
Bawasan ang ibinabalik sa usapan: keep tool output out of context. Mas mura ang parehong gawain nang hindi tinatanggal ang anumang tawag.
Kung gusto mong subukan ito sa isang modelong may mahabang context, naghahain ang CheapTokens ng DeepSeek-V4-Flash (deepseek-) para sa agent loops: isang presyo sa anumang oras, 380K context at hanggang 32,768 output tokens bawat sagot. Para sa mga hakbang na kailangan pa rin ng desisyon, may GLM-5.3-Flash (zai-) na may 390K context. Gumagana ang dalawa sa pamamagitan ng OpenAI- at Anthropic-compatible API sa https:/, na may isang balanse para sa lahat ng modelo. Nasa docs ang setup, nasa pricing page ang mga presyo, at ang model page ay cheap DeepSeek.


