AI для новичковИнструкция
Нужна ли агенту модель на каждом шаге? Фиксированное — в код
Почему после каждого ответа инструмента агент снова зовёт модель, какие шаги можно отдать обычному коду и сколько стоит цикл из трёх шагов с лишним вызовом и без него.
Содержание
Ваш агент работал десять минут, а счёт получился больше, чем сама задача. Причина часто скучная: после каждого ответа инструмента обвязка снова зовёт модель, хотя следующий шаг был очевиден.
Так что нет, модель агенту нужна не на каждом шаге. Она нужна там, где надо что-то решить. Шаг, который всегда один и тот же, например запуск тестов после удачной сборки, можно оставить обычным правилом в коде.
Заботиться об этом стоит ещё и ради денег. Каждый лишний вызов заново читает весь контекст как входные токены (статья про длинный чат объясняет почему), поэтому пропущенный вызов экономит больше, чем его короткий ответ. Если сам цикл вам незнаком, начните с того, как работает ИИ-агент и возвращайтесь.
Почему каждый ответ инструмента — это ещё один вызов модели#
Модель сама ничего не запускает. Она пишет «запусти make build», ваша обвязка (программа вокруг модели) выполняет команду, вставляет вывод в разговор и снова зовёт модель со всей накопленной историей. Вот и весь цикл. Что вернул инструмент, модель узнаёт только тогда, когда вы её вызвали.
Представьте нового сотрудника, который после каждого шага звонит начальнику: «и что теперь?», хотя в чек-листе написано «после компиляции запусти тесты». Начальник каждый раз отвечает одно и то же, а каждый звонок — это минута пересказа всей истории с начала.
Вот как это выглядит в журнале агента. Допустим, задача — «почини упавший тест»:
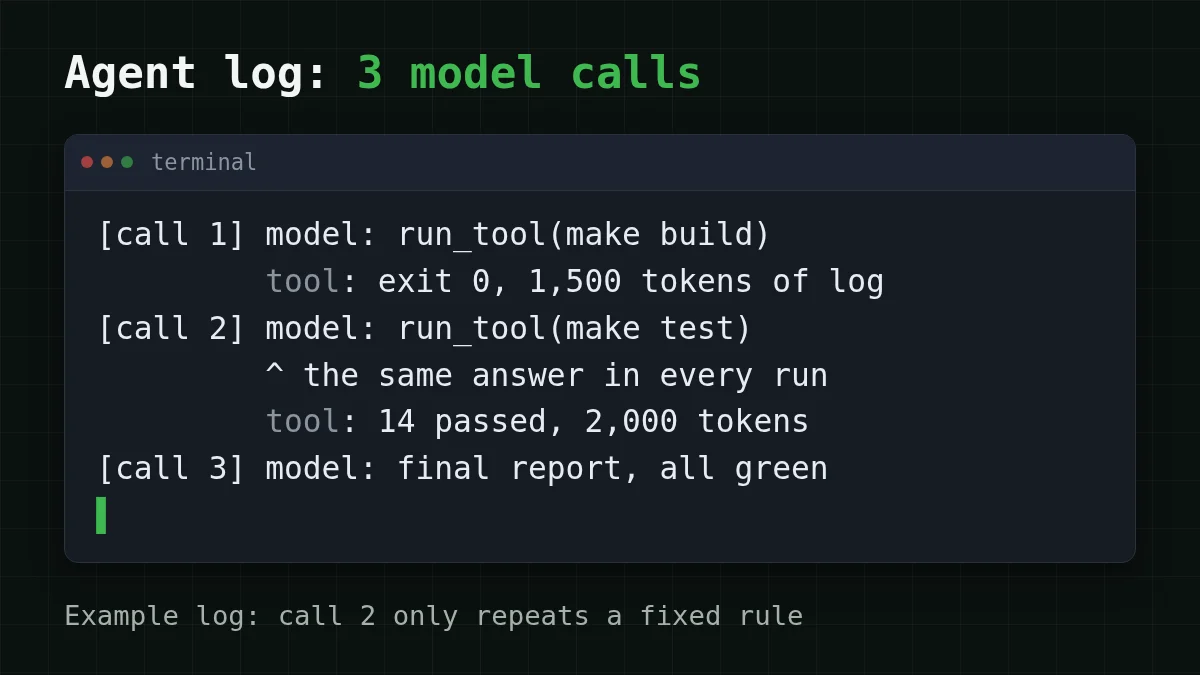
Интереснее всего вызов 2. Сборка прошла, дальше всегда тесты, а модель тратит полное чтение контекста, чтобы ответить «запусти тесты». Вызовы 1 и 3 другие: в первом модель выбирает, с чего начать, в третьем читает результаты тестов и пишет отчёт. Это настоящая работа.
Какие шаги требуют решения, а какие фиксированы#
Большинство шагов сортируют три вопроса:
- Следующее действие определяет понятный сигнал: код возврата, HTTP-статус, «нашлось / не нашлось»?
- При этом сигнале действие каждый раз одно и то же?
- Ошибку легко откатить?
Три «да» — пишите правило. Иначе шаг остаётся у модели.
Второй пример, не про код. Допустим, у вас скрипт поддержки: клиент пишет, скрипт находит заказ и отвечает. Найти заказ по номеру — это код. Подставить в шаблон «Ваш заказ {id}: {status}» — тоже код. А вот прочитать «приехало сломанным, что делать?» и выбрать между возвратом, заменой и извинением — это суждение, то есть один вызов модели, а не три.
Найдите пары
Кто должен отвечать за каждый шаг?
Нажмите на элемент слева, затем на его пару
- Сборка завершилась с кодом 0, дальше всегда тестыКод: следующий шаг фиксирован
- Тесты упали со стек-трейсом; в каком файле править?Модель: новое суждение
- Заказ найден по номеру, статус нужно вставить в шаблон ответаКод: заполнить шаблон
- Клиент пишет «приехало сломанным, что делать?»Модель: понять свободный текст
Безопасным это делает одна защита: правило покрывает только «счастливый путь». Сборка упала с кодом 1? Тесты красные? Инструмент вернул то, чего правило не ждёт? Верните управление модели, как раньше. Вы убираете вызовы, у которых был единственный возможный ответ, а не выкидываете модель из цикла.
Цикл из трёх шагов: с лишним вызовом и без него#
Посчитаем журнал «почини упавший тест». Допущения наши, подставьте свои:
- системный промпт и задача: 3000 токенов
- лог сборки: 1500 токенов, лог тестов: 2000 токенов
- ответ, который лишь просит вызвать инструмент: 60 токенов, итоговый отчёт: 300 токенов
Угадайте число
Если запуск тестов уйдёт в код, сколько вызовов модели сделает цикл?
Ваш вариант
06
Показать ответ
Ответ: 2
Два: один, чтобы запустить сборку, второй, чтобы прочитать оба результата и написать отчёт. Для запуска тестов решение больше не нужно.
Модель на каждом шаге. Вызов 1 читает 3000 токенов. Вызов 2 читает 3000 + 60 + 1500 = 4560. Вызов 3 читает 4560 + 60 + 2000 = 6620. Вход всего: 3000 + 4560 + 6620 = 14180 токенов, выход: 60 + 60 + 300 = 420.
Запуск тестов в коде. Вызов 1 читает 3000 токенов. Обвязка запускает сборку, затем тесты по правилу, и вызов 2 читает 3000 + 60 + 1500 + 2000 = 6560. Вход всего: 3000 + 6560 = 9560 токенов, выход: 60 + 300 = 360.
Разница — 14180 − 9560 = 4620 входных токенов, около трети входа, и ещё один маленький ответ. На DeepSeek-V4-Flash такая задача стоит $0.00025 в первом варианте и $0.00018 во втором. Одна задача — копейки. Допустим, ваш агент решает таких 500 в день (14180 × 500 = 7090000 входных и 420 × 500 = 210000 выходных токенов против 4780000 и 180000):
С ростом контекста разрыв увеличивается: чем длиннее логи, которые модель таскает за собой, тем дороже каждое пропущенное перечитывание. Тот же цикл рядом:
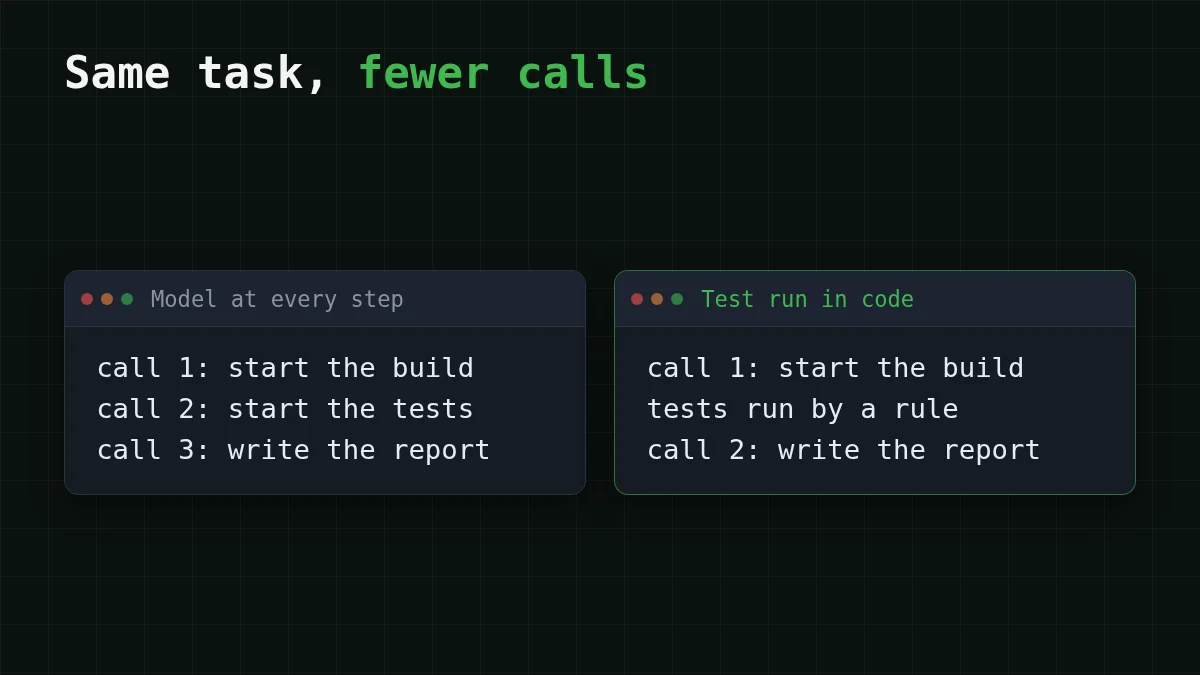
В коде правило занимает несколько строк. Это псевдокод, имена функций ваши:
result = run_tool(call)              # модель попросила: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # фиксированное правило, без вызова модели
    messages.append(tool_message(tests))
# всё остальное (сборка упала, странный вывод) возвращается модели

reply = call_model(messages)         # модель читает всё один раз
Что сообщают авторы HarnessMM#
Идея не только наша. HarnessMM — препринт на arXiv (arXiv:2610.32813, подан 23 октября 2026, проверено 2 ноября 2026), авторы Yuhua Jiang, Chang Xu, Feifei Gao и Li Zhao. Они заметили, что обвязки агентов часто снова зовут модель после ответа инструмента, хотя предыдущий вызов уже определил следующее действие. Их решение, guarded decision reuse, повторно использует это решение, а к исходной модели возвращается, когда появляется новое смысловое решение, доказательства не подтверждены или селектор воздерживается. Наш if выше — написанная вручную версия той же идеи; как решает их защита, описано в статье.
На HumanEval авторы приводят такие результаты:
- Codex harness: 66,72k → 47,02k токенов на задачу (−29,54%), успех не изменился — 90,82%.
- DeepSeek Harness: 96,28k → 11,62k токенов на задачу (−87,93%), успех 71,43% → 85,71%.
Читайте осторожно. Это один бенчмарк, собственная обвязка авторов, препринт без рецензии, а на странице arXiv нет ссылки на код. В пересказах встречается «88%»: это цифра только для DeepSeek Harness, у Codex около 30%. Считайте оба числа направлением, а не обещанием для вашего агента. Ваш собственный журнал скажет больше.
Проверьте своего агента за десять минут#
Включите журнал каждого вызова модели вместе с числами usage из ответа (учёт стоимости агента на Python показывает один способ). Затем прочитайте последние двадцать запусков и пометьте каждый вызов: решение или фиксированный шаг. Кандидат — вызов, у которого следующее действие не менялось во всех этих запусках. Что показывает ваш журнал?
Выберите свой случай
Что показывает ваш журнал?
Выберите вариант, чтобы увидеть ответ
Одна и та же пара вызовов в каждом запуске
Здесь прячется фиксированное правило. Запишите его как if по понятному сигналу, например по коду возврата, а модель оставьте запасным вариантом на любой неожиданный сигнал.
Вызовы, которые лишь переформатируют или копируют вывод инструмента
Перенесите их в шаблон в коде. Если тексту действительно нужна модель, это небольшая работа для дешёвой модели, а не для самой большой.
Вызовы, где следующий шаг зависит от содержимого
Здесь модель нужна, для этого она и есть. А простой выбор вроде «классифицировать и выбрать» часто тянет модель подешевле; см. маршрутизацию: сначала дешёвая модель.
Каждый вызов перечитывает огромный лог
Сократите то, что возвращается в разговор: не пускайте вывод инструментов в контекст. Задача станет дешевле без удаления вызовов.
Если хотите попробовать это на модели с длинным контекстом: в CheapTokens для агентных циклов есть DeepSeek-V4-Flash (deepseek-) — одна цена в любое время суток, контекст 380K и до 32 768 токенов в ответе. Для шагов, где решение всё ещё нужно, — GLM-5.3-Flash (zai-) с контекстом 390K. Обе работают через OpenAI- и Anthropic-совместимый API по адресу https:/, баланс один на все модели. Подключение описано в документации, цены — на странице цен, а все модели — в каталоге.


