نئے سیکھنے والوں کے لیے AIگائیڈ
کیا ایجنٹس کو ہر قدم پر ماڈل کی ضرورت ہے؟ مقرر قدموں کو کوڈ میں رکھیں
کیوں ہر ٹول نتیجہ ایک اور ماڈل کال شروع کرتا ہے، کون سے ایجنٹ قدم سادہ کوڈ ہو سکتے ہیں، اور 3 قدم کے لوپ کی لاگت اضافی کال کے ساتھ اور بغیر۔
اس صفحہ پر
آپ کا ایجنٹ دس منٹ تک چلا، اور بل کام سے بڑا ہے۔ اکثر وجہ بورنگ ہوتی ہے: ہر ٹول کے نتیجے کے بعد ہارنیس دوبارہ ماڈل کو کال کرتا ہے، چاہے اگلا قدم واضح ہو۔
تو نہیں، ایجنٹ کو ہر قدم پر ماڈل کی ضرورت نہیں ہوتی۔ اسے ماڈل وہاں چاہیے جہاں کچھ طے کرنا ہو۔ جو قدم ہمیشہ یکساں ہو، جیسے پاس ہونے والے بلڈ کے بعد ٹیسٹ چلانا، وہ آپ کے کوڈ میں ایک سادہ اصول ہو سکتا ہے۔
اس کی فکر کرنے کی ایک مالی وجہ ہے۔ ہر اضافی کال پورے کانٹیکسٹ کو ان پٹ ٹوکنز کے طور پر دوبارہ پڑھتی ہے (لمبی چیٹ کا مضمون بتاتا ہے کیوں)، تو چھوڑی گئی کال اپنے مختصر جواب سے زیادہ بچاتی ہے۔ اگر لوپ آپ کے لیے نیا ہے، تو AI ایجنٹ کیسے کام کرتا ہے سے شروع کریں اور واپس آئیں۔
کیوں ایک ٹول نتیجہ ایک اور ماڈل کال کا مطلب ہے#
ماڈل کبھی کچھ نہیں چلاتا۔ وہ لکھتا ہے "براہ کرم make build چلائیں"، آپ کا ہارنیس (ماڈل کے گرد پروگرام) اسے چلاتا ہے، آؤٹ پٹ گفتگو میں چسپاں کرتا ہے اور اب تک کے سب کچھ کے ساتھ ماڈل کو دوبارہ کال کرتا ہے۔ یہی پورا لوپ ہے۔ ماڈل کو تبھی پتہ چلتا ہے کہ ٹول نے کیا واپس کیا جب آپ اسے کال کرتے ہیں۔
ایک نئے ساتھی کا سوچیں جو ہر قدم کے بعد مینیجر کو فون کر کے پوچھتا ہے "اور اب؟"، حالانکہ چیک لسٹ کہتی ہے "کمپائل کرنے کے بعد ٹیسٹ چلائیں"۔ مینیجر ہر بار وہی جواب دیتا ہے، اور ہر کال پوری کہانی شروع سے پڑھنے کا ایک منٹ لیتی ہے۔
ایجنٹ لاگ میں یہ ایسا دکھتا ہے۔ فرض کریں کام ہے "ناکام ٹیسٹ ٹھیک کریں":
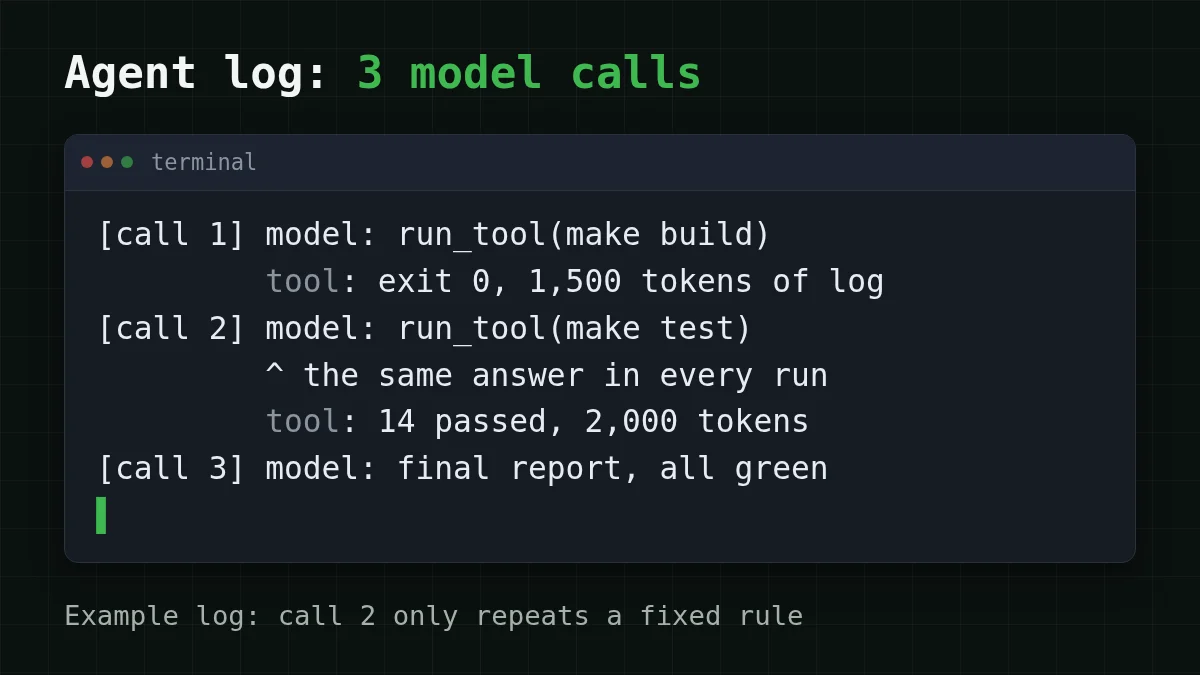
کال 2 دلچسپ ہے۔ بلڈ پاس ہو گیا، اگلا قدم ہمیشہ ٹیسٹ ہیں، اور ماڈل "ٹیسٹ چلائیں" کہنے کے لیے کانٹیکسٹ کی پوری پڑھائی خرچ کرتا ہے۔ کال 1 اور کال 3 مختلف ہیں: کال 1 منتخب کرتی ہے کہ کیسے شروع کرنا ہے، کال 3 ٹیسٹ نتائج پڑھتی ہے اور رپورٹ لکھتی ہے۔ یہ اصل کام ہیں۔
کون سے قدم فیصلہ چاہتے ہیں اور کون سے مقرر ہیں#
تین سوالات زیادہ تر قدموں کو چھانٹ دیتے ہیں:
- کیا اگلا عمل کسی واضح سگنل سے طے ہوتا ہے، جیسے ایگزٹ کوڈ، HTTP اسٹیٹس یا "ملا / نہیں ملا"؟
- کیا وہ سگنل آنے پر ہر بار وہی عمل ہوتا ہے؟
- کیا غلط اندازہ واپس لینا سستا ہے؟
تین ہاں: اسے اصول کے طور پر لکھیں۔ ورنہ ماڈل وہ قدم رکھے گا۔
کوڈنگ کے باہر دوسری مثال۔ فرض کریں آپ سپورٹ اسکرپٹ چلاتے ہیں: گاہک لکھتا ہے، اسکرپٹ آرڈر تلاش کرتا ہے، پھر جواب دیتا ہے۔ آرڈر کو اس کے نمبر سے تلاش کرنا کوڈ ہے۔ ٹیمپلیٹ سے "آپ کا آرڈر {id} ہے {status}" بھرنا بھی کوڈ ہے۔ "یہ ٹوٹا ہوا آیا، اب کیا؟" پڑھنا اور ریفنڈ، متبادل اور معافی کے درمیان انتخاب کرنا ایک فیصلہ ہے، تو یہ ایک ماڈل کال ہے، تین نہیں۔
جوڑے ملائیں
ہر قدم کون سنبھالے؟
بائیں طرف کسی آئٹم پر ٹیپ کریں، پھر اس کا جوڑا
- بلڈ ایگزٹ کوڈ 0 کے ساتھ ختم ہوا، اور اگلا قدم ہمیشہ ٹیسٹ ہیںکوڈ: اگلا قدم مقرر ہے
- ٹیسٹ اسٹیک ٹریس کے ساتھ ناکام ہوئے؛ کس فائل میں تبدیلی چاہیے؟ماڈل: ایک نیا فیصلہ
- آرڈر نمبر سے ملا، اب اس کی اسٹیٹس جواب کے ٹیمپلیٹ میں ڈالیںکوڈ: ٹیمپلیٹ بھریں
- گاہک لکھتا ہے "یہ ٹوٹا ہوا آیا، اب کیا؟"ماڈل: آزاد متن پڑھنا
ایک گارڈ اسے محفوظ بناتا ہے: اصول صرف ہیپی پاتھ کا احاطہ کرتا ہے۔ بلڈ ایگزٹ کوڈ 1 کے ساتھ ناکام؟ ٹیسٹ سرخ؟ کسی ٹول نے کچھ ایسا واپس کیا جو اصول نے توقع نہیں کیا؟ کنٹرول ماڈل کو واپس دیں، بالکل پہلے کی طرح۔ آپ وہ کالز ہٹا رہے ہیں جن کا صرف ایک ممکنہ جواب تھا، ماڈل کو لوپ سے نکال نہیں رہے۔
3 قدم کا لوپ، اضافی کال کے ساتھ اور بغیر#
"ناکام ٹیسٹ ٹھیک کریں" لاگ پر اعداد ڈالتے ہیں۔ مفروضے، سب ہمارے اور آپ کے لیے بدلنا آسان:
- سسٹم پرامپٹ جمع کام: 3,000 ٹوکنز
- بلڈ لاگ: 1,500 ٹوکنز؛ ٹیسٹ لاگ: 2,000 ٹوکنز
- صرف ٹول مانگنے والا جواب: 60 ٹوکنز؛ حتمی رپورٹ: 300 ٹوکنز
نمبر کا اندازہ لگائیں
اگر ٹیسٹ رن کوڈ میں چلا جائے، تو لوپ کتنی ماڈل کالز کرتا ہے؟
آپ کا اندازہ
06
جواب دکھائیں
جواب: 2
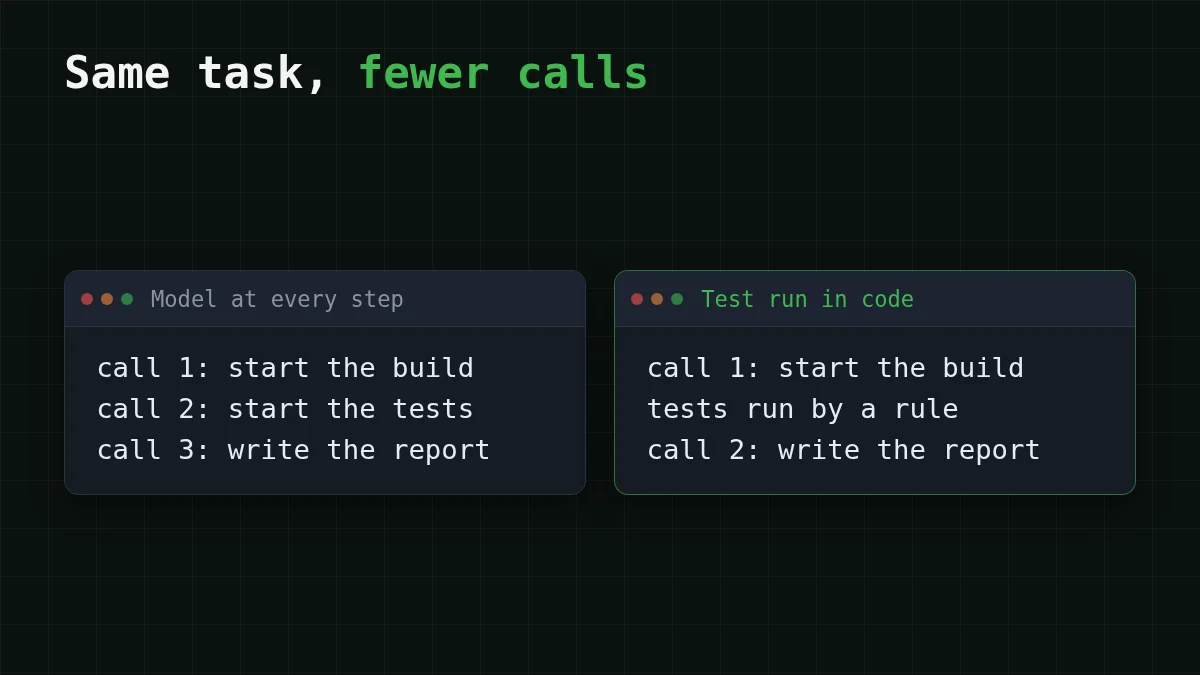
دو: ایک بلڈ شروع کرنے کے لیے، ایک دونوں نتائج پڑھنے اور رپورٹ لکھنے کے لیے۔ ٹیسٹ رن کو اب فیصلے کی ضرورت نہیں۔
ہر قدم پر ماڈل۔ کال 1 3,000 ٹوکنز پڑھتی ہے۔ کال 2 3,000 + 60 + 1,500 = 4,560 پڑھتی ہے۔ کال 3 4,560 + 60 + 2,000 = 6,620 پڑھتی ہے۔ کل ان پٹ: 3,000 + 4,560 + 6,620 = 14,180 ٹوکنز؛ آؤٹ پٹ: 60 + 60 + 300 = 420۔
ٹیسٹ رن کوڈ میں۔ کال 1 3,000 ٹوکنز پڑھتی ہے۔ ہارنیس بلڈ چلاتا ہے، پھر اصول کے مطابق ٹیسٹ، اور کال 2 3,000 + 60 + 1,500 + 2,000 = 6,560 پڑھتی ہے۔ کل ان پٹ: 3,000 + 6,560 = 9,560 ٹوکنز؛ آؤٹ پٹ: 60 + 300 = 360۔
فرق ہے 14,180 − 9,560 = 4,620 ان پٹ ٹوکنز، ان پٹ کا تقریباً ایک تہائی، جمع ایک چھوٹا جواب۔ DeepSeek-V4-Flash پر ایسا ایک کام پہلے طریقے سے $0.00025 اور دوسرے سے $0.00018 کا ہے۔ ایک کام راؤنڈنگ ایرر ہے۔ فرض کریں آپ کا ایجنٹ روزانہ 500 کرتا ہے (14,180 × 500 = 7,090,000 ان پٹ ٹوکنز، 420 × 500 = 210,000 آؤٹ پٹ ٹوکنز بمقابلہ 4,780,000 اور 180,000):
فرق کانٹیکسٹ کے ساتھ بڑھتا ہے: ماڈل جتنے لمبے لاگ ساتھ گھسیٹے، چھوڑی گئی دوبارہ پڑھائی اتنی ہی زیادہ قیمتی۔ یہی لوپ ساتھ ساتھ:
کوڈ میں، اصول چند سطریں ہے۔ یہ سیوڈو کوڈ ہے، ہیلپر نام آپ کے:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
HarnessMM کے مصنفین کیا رپورٹ کرتے ہیں#
یہ خیال صرف ہمارا نہیں۔ HarnessMM arXiv پر ایک پری پرنٹ ہے (arXiv:2610.32813، 23 اکتوبر 2026 کو جمع، 2 نومبر 2026 کو چیک کیا گیا) از Yuhua Jiang، Chang Xu، Feifei Gao اور Li Zhao۔ ان کا مشاہدہ: ایجنٹ ہارنیسز اکثر ٹول فیڈبیک کے بعد ماڈل کو دوبارہ کال کرتے ہیں چاہے پہلے کی کال اگلا عمل طے کر چکی ہو۔ ان کا حل، گارڈڈ ڈیسیژن ری یوز، وہ فیصلہ دوبارہ چلاتا ہے اور اصل ماڈل پر واپس آتا ہے جب کوئی نیا سیمنٹک فیصلہ آئے، شواہد غیر معاون ہوں یا سلیکٹر رک جائے۔ اوپر والا if اسی خیال کا ہاتھ سے لکھا ورژن ہے؛ ان کا گارڈ کیسے فیصلہ کرتا ہے وہ پیپر میں ہے۔
مصنفین HumanEval پر یہ نتائج رپورٹ کرتے ہیں:
- Codex ہارنیس: 66.72k → 47.02k ٹوکنز فی کام (−29.54%)، کامیابی 90.82% پر برقرار۔
- DeepSeek Harness: 96.28k → 11.62k ٹوکنز فی کام (−87.93%)، کامیابی 71.43% → 85.71%۔
انہیں احتیاط سے پڑھیں۔ یہ ایک بینچ مارک ہے، مصنفین کا اپنا ہارنیس، ایک پری پرنٹ جو ہم مرتبہ جائزہ شدہ نہیں، اور arXiv صفحہ کوئی کوڈ نہیں دکھاتا۔ آپ کو دوبارہ بیانات میں "88%" مل سکتا ہے: یہ صرف DeepSeek Harness کا عدد ہے، Codex والا تقریباً 30% ہے۔ دونوں کو سمت سمجھیں، اپنے ایجنٹ کے لیے وعدہ نہیں۔ آپ کا اپنا لاگ آپ کو زیادہ بتاتا ہے۔
اپنے ایجنٹ کو دس منٹ میں چیک کریں#
ہر ماڈل کال کا لاگ آن کریں، ہر جواب سے usage اعداد کے ساتھ (Python میں ایجنٹ ٹوکن لاگت ٹریک کرنا ایک طریقہ دکھاتا ہے)۔ پھر آخری بیس رنز پڑھیں اور ہر کال کو نشان زد کریں: فیصلہ یا مقرر۔ کال امیدوار ہے جب ان رنز میں اگلا عمل کبھی نہ بدلا۔ آپ کا لاگ کیا دکھاتا ہے؟
اپنا کیس منتخب کریں
آپ کا لاگ کیا دکھاتا ہے؟
جواب دیکھنے کے لیے ایک آپشن منتخب کریں
ہر رن میں کالز کا وہی جوڑا
وہاں ایک مقرر اصول چھپا ہے۔ اسے واضح سگنل پر if کے طور پر لکھیں، جیسے ایگزٹ کوڈ، اور ماڈل کو فال بیک رکھیں جب سگنل کچھ غیر متوقع ہو۔
کالز جو صرف ٹول آؤٹ پٹ کو دوبارہ فارمیٹ یا کاپی کرتی ہیں
انہیں کوڈ میں ٹیمپلیٹ میں منتقل کریں۔ اگر متن کو واقعی ماڈل چاہیے، تو یہ سستے ماڈل کا چھوٹا کام ہے، آپ کے سب سے بڑے کا نہیں۔
کالز جہاں اگلا قدم مواد کے ساتھ بدلتا ہے
ماڈل یہاں رکھیں۔ یہ اسی کے لیے ہے، اور سستا ماڈل اکثر سادہ classify-and-pick قدم سنبھال لیتا ہے؛ دیکھیں ماڈل روٹنگ: پہلے سستا ماڈل۔
ہر کال ایک بہت بڑا لاگ دوبارہ پڑھتی ہے
گفتگو میں واپس جانے والا حصہ کم کریں: ٹول آؤٹ پٹ کانٹیکسٹ سے باہر رکھیں۔ کوئی کال ہٹائے بغیر وہی کام سستا ہو جاتا ہے۔
اگر آپ یہ لمبے کانٹیکسٹ والے ماڈل پر آزمانا چاہتے ہیں، CheapTokens ایجنٹ لوپس کے لیے DeepSeek-V4-Flash (deepseek-) پیش کرتا ہے: کسی بھی وقت ایک قیمت، 380K کانٹیکسٹ اور فی جواب 32,768 آؤٹ پٹ ٹوکنز تک۔ ان قدموں کے لیے جنہیں اب بھی فیصلہ چاہیے، GLM-5.3-Flash (zai-) ہے 390K کانٹیکسٹ کے ساتھ۔ دونوں https:/ پر OpenAI- اور Anthropic-مطابق API کے ذریعے کام کرتے ہیں، تمام ماڈلز کے لیے ایک بیلنس کے ساتھ۔ سیٹ اپ ڈاکس میں ہے، قیمتیں قیمتوں کے صفحے پر، اور ماڈل صفحہ سستا DeepSeek ہے۔


