AI dla początkującychPrzewodnik
Czy agenci potrzebują modelu na każdym kroku? Przenieś stałe kroki do kodu
Dlaczego każdy wynik narzędzia wywołuje kolejne wywołanie modelu, które kroki agenta mogą być zwykłym kodem i ile kosztuje pętla 3-krokowa z dodatkowym wywołaniem i bez niego.
Na tej stronie
Twój agent działał przez dziesięć minut, a rachunek jest większy niż samo zadanie. Bardzo często powód jest nudny: po każdym wyniku narzędzia harness ponownie wywołuje model, nawet gdy następny krok był oczywisty.
Więc nie, agent nie potrzebuje modelu na każdym kroku. Potrzebuje modelu tam, gdzie coś trzeba zdecydować. Krok, który zawsze wygląda tak samo, jak uruchomienie testów po udanym buildzie, może być zwykłą regułą w twoim kodzie.
Jest powód finansowy, by się tym przejmować. Każde dodatkowe wywołanie ponownie odczytuje cały kontekst jako tokeny wejściowe (artykuł o długich rozmowach pokazuje dlaczego), więc pominięte wywołanie oszczędza więcej niż własną krótką odpowiedź. Jeśli sama pętla jest dla ciebie nowa, zacznij od jak działa agent AI i wróć.
Dlaczego jeden wynik narzędzia oznacza jedno dodatkowe wywołanie modelu#
Model nigdy niczego nie uruchamia. Pisze „proszę uruchomić make build”, twój harness (program wokół modelu) uruchamia to, wkleja wynik do rozmowy i wywołuje model ponownie z wszystkim, co dotychczas. To cała pętla. Model dowiaduje się, co zwróciło narzędzie, dopiero gdy go wywołasz.
Pomyśl o nowym współpracowniku, który po każdym kroku dzwoni do menedżera i pyta „a teraz?”, choć lista kontrolna mówi „po kompilacji uruchom testy”. Menedżer za każdym razem odpowiada to samo, a każde wywołanie kosztuje minutę czytania całej historii od początku.
Oto jak to wygląda w logu agenta. Załóżmy, że zadanie to „napraw failing test”:
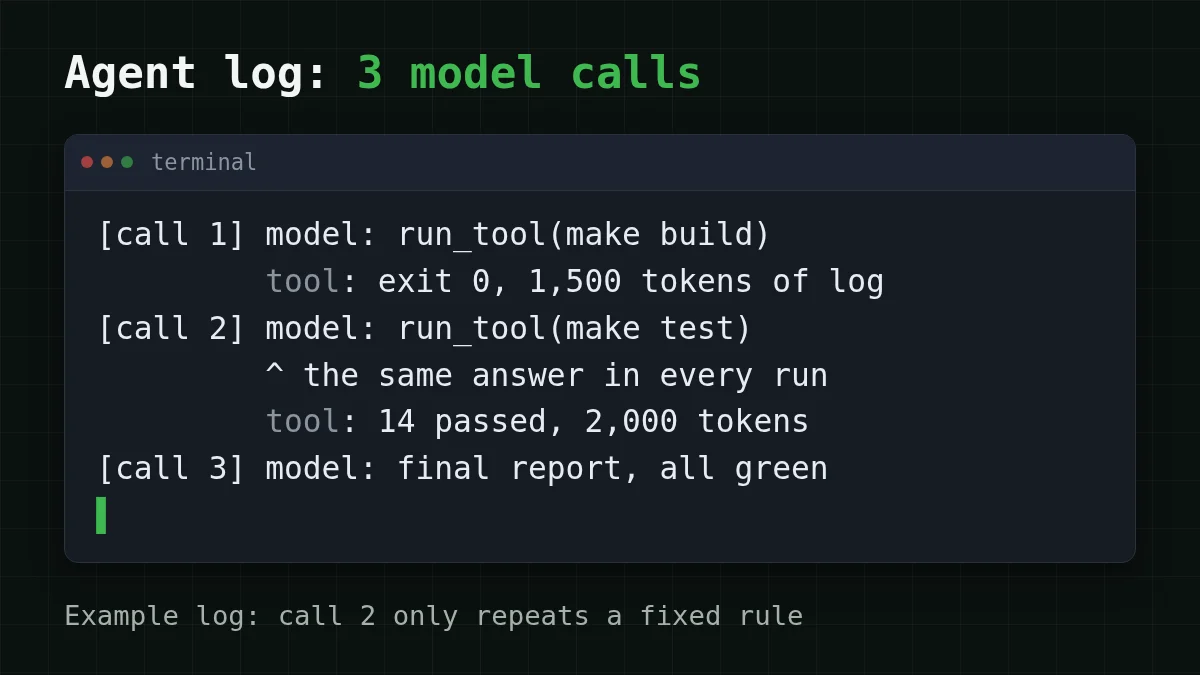
Wywołanie 2 jest ciekawe. Build przeszedł, następny krok to zawsze testy, a model zużywa pełny odczyt kontekstu, by powiedzieć „uruchom testy”. Wywołanie 1 i 3 są inne: wywołanie 1 wybiera, jak zacząć, wywołanie 3 czyta wyniki testów i pisze raport. To prawdziwa praca.
Które kroki wymagają decyzji, a które są stałe#
Trzy pytania porządkują większość kroków:
- Czy następną akcję wyznacza jasny sygnał, taki jak kod wyjścia, status HTTP lub „znaleziono / nie znaleziono”?
- Czy to ta sama akcja za każdym razem, gdy ten sygnał się pojawia?
- Czy błędne zgadnięcie jest tanie do cofnięcia?
Trzy razy tak: zapisz to jako regułę. W przeciwnym razie model zachowuje krok.
Drugi przykład, poza programowaniem. Załóżmy, że prowadzisz skrypt wsparcia: klient pisze, skrypt wyszukuje zamówienie, potem odpowiada. Wyszukanie zamówienia po numerze to kod. Wypełnienie „Twoje zamówienie {id} ma status {status}” z szablonu to też kod. Odczytanie „przyszło zepsute, co teraz?” i wybór między zwrotem, wymianą a przeprosinami to osąd, więc to jedno wywołanie modelu, nie trzy.
Dopasuj pary
Kto powinien obsłużyć każdy krok?
Dotknij element po lewej, a następnie jego parę
- Build zakończony kodem wyjścia 0, a następny krok to zawsze testyKod: następny krok jest stały
- Testy nie przeszły ze stack trace; który plik wymaga zmiany?Model: nowy osąd
- Zamówienie znalezione po numerze, teraz wstaw jego status do szablonu odpowiedziKod: wypełnij szablon
- Klient pisze „przyszło zepsute, co teraz?”Model: odczyt wolnego tekstu
Jeden strażnik czyni to bezpiecznym: reguła obejmuje tylko ścieżkę szczęśliwą. Build nie przeszedł z kodem wyjścia 1? Testy czerwone? Narzędzie zwróciło coś, czego reguła się nie spodziewała? Oddaj kontrolę modelowi, dokładnie jak wcześniej. Usuwasz wywołania, które miały tylko jedną możliwą odpowiedź, a nie wyciągasz model z pętli.
Pętla 3-krokowa, z dodatkowym wywołaniem i bez niego#
Nałóżmy liczby na log „napraw failing test”. Założenia, wszystkie nasze i łatwe do podmiany na twoje:
- prompt systemowy plus zadanie: 3 000 tokenów
- log builda: 1 500 tokenów; log testów: 2 000 tokenów
- odpowiedź, która tylko prosi o narzędzie: 60 tokenów; raport końcowy: 300 tokenów
Zgadnij liczbę
Jeśli uruchomienie testów przeniesiemy do kodu, ile wywołań modelu wykonuje pętla?
Twoje przypuszczenie
06
Pokaż odpowiedź
Odpowiedź: 2
Dwa: jedno, by zacząć build, jedno, by odczytać oba wyniki i napisać raport. Uruchomienie testów nie wymaga już decyzji.
Model na każdym kroku. Wywołanie 1 czyta 3 000 tokenów. Wywołanie 2 czyta 3 000 + 60 + 1 500 = 4 560. Wywołanie 3 czyta 4 560 + 60 + 2 000 = 6 620. Wejście łącznie: 3 000 + 4 560 + 6 620 = 14 180 tokenów; wyjście: 60 + 60 + 300 = 420.
Uruchomienie testów w kodzie. Wywołanie 1 czyta 3 000 tokenów. Harness uruchamia build, potem testy z reguły, a wywołanie 2 czyta 3 000 + 60 + 1 500 + 2 000 = 6 560. Wejście łącznie: 3 000 + 6 560 = 9 560 tokenów; wyjście: 60 + 300 = 360.
Różnica to 14 180 − 9 560 = 4 620 tokenów wejściowych, około jednej trzeciej wejścia, plus jedna mała odpowiedź. Na DeepSeek-V4-Flash jedno takie zadanie kosztuje $0.00025 pierwszym sposobem i $0.00018 drugim. Jedno zadanie to błąd zaokrąglenia. Powiedzmy, że twój agent robi ich 500 dziennie (14 180 × 500 = 7 090 000 tokenów wejściowych, 420 × 500 = 210 000 tokenów wyjściowych wobec 4 780 000 i 180 000):
Różnica rośnie z kontekstem: im dłuższe logi model wlecze za sobą, tym więcej warte jest pominięte ponowne odczytanie. Oto ta sama pętla obok siebie:
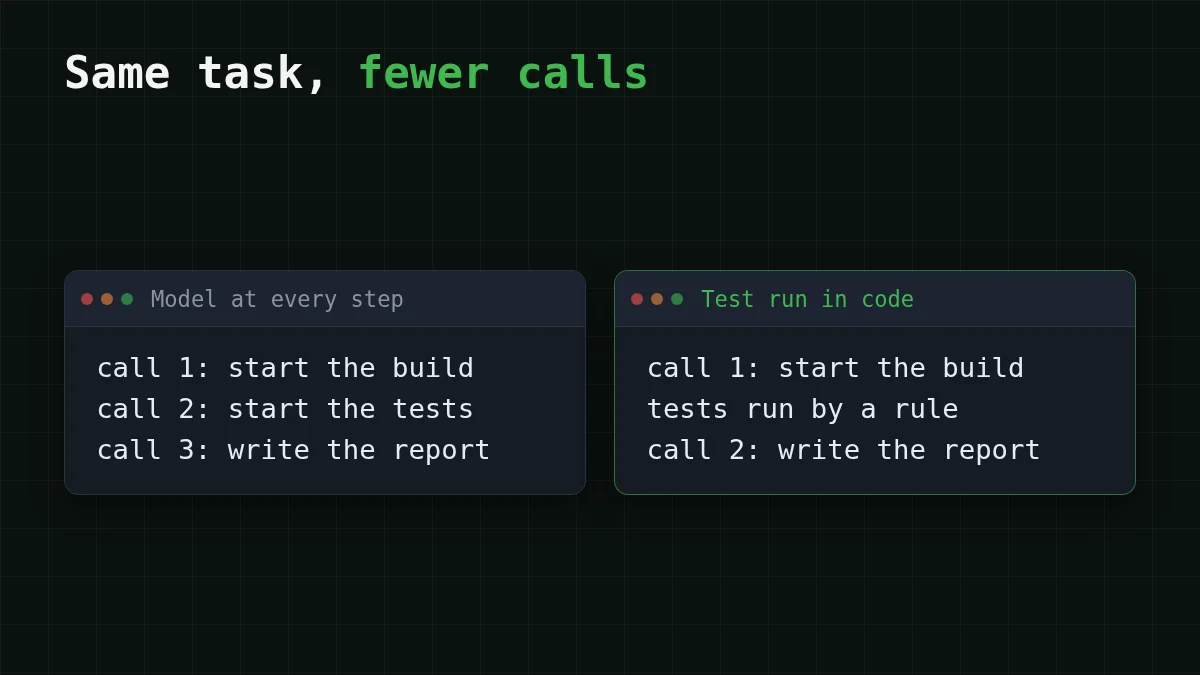
W kodzie reguła to kilka linii. To pseudokod, nazwy pomocnicze są twoje:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
Co raportują autorzy HarnessMM#
Pomysł nie jest tylko nasz. HarnessMM to preprint na arXiv (arXiv:2610.32813, przesłany 23 października 2026, sprawdzony 2 listopada 2026) autorstwa Yuhua Jiang, Chang Xu, Feifei Gao i Li Zhao. Ich obserwacja: harnessy agentów często wywołują model ponownie po informacji zwrotnej z narzędzia, nawet gdy wcześniejsze wywołanie już ustaliło następną akcję. Ich poprawka, guarded decision reuse, odtwarza tę decyzję i wraca do oryginalnego modelu, gdy pojawia się nowa decyzja semantyczna, dowody są niepoparte lub selektor się wstrzymuje. Powyższy if to ręcznie napisana wersja tego samego pomysłu; jak decyduje ich strażnik, jest w artykule.
Autorzy raportują te wyniki na HumanEval:
- Harness Codex: 66,72k → 47,02k tokenów na zadanie (−29,54%), skuteczność bez zmian na 90,82%.
- DeepSeek Harness: 96,28k → 11,62k tokenów na zadanie (−87,93%), skuteczność 71,43% → 85,71%.
Czytaj je ostrożnie. To jeden benchmark, własny harness autorów, preprint bez recenzji, a strona arXiv nie wymienia kodu. W relacjach możesz zobaczyć „88%”: to tylko liczba dla DeepSeek Harness, dla Codex to około 30%. Traktuj oba jako kierunek, nie jako obietnicę dla twojego agenta. Twój własny log powie ci więcej.
Sprawdź własnego agenta w dziesięć minut#
Włącz log każdego wywołania modelu, z liczbami usage z każdej odpowiedzi (śledzenie kosztu tokenów agenta w Pythonie pokazuje jeden sposób). Potem przejrzyj ostatnie dwadzieścia uruchomień i oznacz każde wywołanie: decyzja czy stałe. Wywołanie jest kandydatem, gdy następna akcja nigdy się nie zmieniła w tych uruchomieniach. Co pokazuje twój log?
Wybierz swój przypadek
Co pokazuje twój log?
Wybierz opcję, aby zobaczyć odpowiedź
Ta sama para wywołań w każdym uruchomieniu
Ukrywa się tam stała reguła. Zapisz ją jako if na jasnym sygnale, takim jak kod wyjścia, i zachowaj model jako fallback, gdy sygnał jest czymkolwiek nieoczekiwanym.
Wywołania, które tylko przeformatowują lub kopiują wynik narzędzia
Przenieś je do szablonu w kodzie. Jeśli tekst naprawdę wymaga modelu, to małe zadanie dla taniego modelu, nie dla twojego największego.
Wywołania, gdzie następny krok zmienia się z treścią
Zachowaj tu model. Do tego jest, a tańszy model często radzi sobie ze zwykłym krokiem klasyfikuj-i-wybierz; zobacz routing modeli: najpierw tani model.
Każde wywołanie ponownie czyta ogromny log
Przytnij to, co wraca do rozmowy: trzymaj wynik narzędzia poza kontekstem. To samo zadanie staje się tańsze bez usuwania żadnego wywołania.
Jeśli chcesz to wypróbować na modelu z długim kontekstem, CheapTokens udostępnia DeepSeek-V4-Flash (deepseek-) do pętli agentów: jedna cena o każdej porze, kontekst 380K i do 32 768 tokenów wyjściowych na odpowiedź. Dla kroków, które nadal wymagają decyzji, jest GLM-5.3-Flash (zai-) z kontekstem 390K. Oba działają przez API zgodne z OpenAI i Anthropic pod https:/, z jednym saldem dla wszystkich modeli. Konfiguracja jest w dokumentacji, ceny na stronie cen, a strona modelu to tani DeepSeek.


