এজেন্টদের কি প্রতিটা ধাপে মডেল দরকার? নির্দিষ্ট ধাপগুলো কোডে রাখুন
কেন প্রতিটা টুল রেজাল্ট আরেকটা মডেল কল ডাকে, কোন এজেন্ট ধাপগুলো সাধারণ কোড হতে পারে, এবং একটা ৩-ধাপের লুপের খরচ অতিরিক্ত কলসহ ও ছাড়া।
এই পৃষ্ঠায়
আপনার এজেন্ট দশ মিনিট ধরে চলেছে, আর বিলটা কাজের চেয়ে বড়। খুব প্রায়ই কারণটা বিরক্তিকর: প্রতিটা টুল রেজাল্টের পর হারনেস আবার মডেলকে কল করে, এমনকি যখন পরের ধাপটা স্পষ্ট ছিল।
তাই না, একটা এজেন্টের প্রতিটা ধাপে মডেলের দরকার নেই। মডেলের দরকার সেখানে যেখানে কিছু সিদ্ধান্ত নিতে হয়। যে ধাপটা সবসময় একই, যেমন পাস করা বিল্ডের পর টেস্ট চালানো, সেটা আপনার কোডে একটা সাধারণ নিয়ম হতে পারে।
এটা নিয়ে ভাববার একটা টাকার কারণ আছে। প্রতিটা অতিরিক্ত কল পুরো কনটেক্সটকে ইনপুট টোকেন হিসেবে আবার পড়ে (লং-চ্যাট আর্টিকেল দেখায় কেন), তাই একটা বাদ দেওয়া কল তার নিজের ছোট উত্তরের চেয়ে বেশি বাঁচায়। লুপটা যদি আপনার কাছে নতুন হয়, একটা AI এজেন্ট কীভাবে কাজ করে দিয়ে শুরু করুন এবং ফিরে আসুন।
কেন একটা টুল রেজাল্ট মানে আরেকটা মডেল কল#
মডেল কখনো কিছু চালায় না। সে লেখে "অনুগ্রহ করে make build চালাও", আপনার হারনেস (মডেলের চারপাশের প্রোগ্রাম) সেটা চালায়, আউটপুট কথোপকথনে পেস্ট করে এবং এখন পর্যন্ত সবকিছুসহ আবার মডেলকে কল করে। এটাই পুরো লুপ। মডেল কেবল তখনই জানে একটা টুল কী ফেরত দিয়েছে যখন আপনি তাকে কল করেন।
একজন নতুন সহকর্মীর কথা ভাবুন যে প্রতিটা ধাপের পর ম্যানেজারকে ফোন করে জিজ্ঞেস করে "এখন কী?", যদিও চেকলিস্টে লেখা "কম্পাইল করার পর, টেস্ট চালাও"। ম্যানেজার প্রতিবার একই উত্তর দেন, আর প্রতিটা কলে পুরো গল্পটা শুরু থেকে পড়তে এক মিনিট লাগে।
একটা এজেন্ট লগে এটা কেমন দেখায়। ধরুন কাজটা "ব্যর্থ টেস্টটা ঠিক করো":
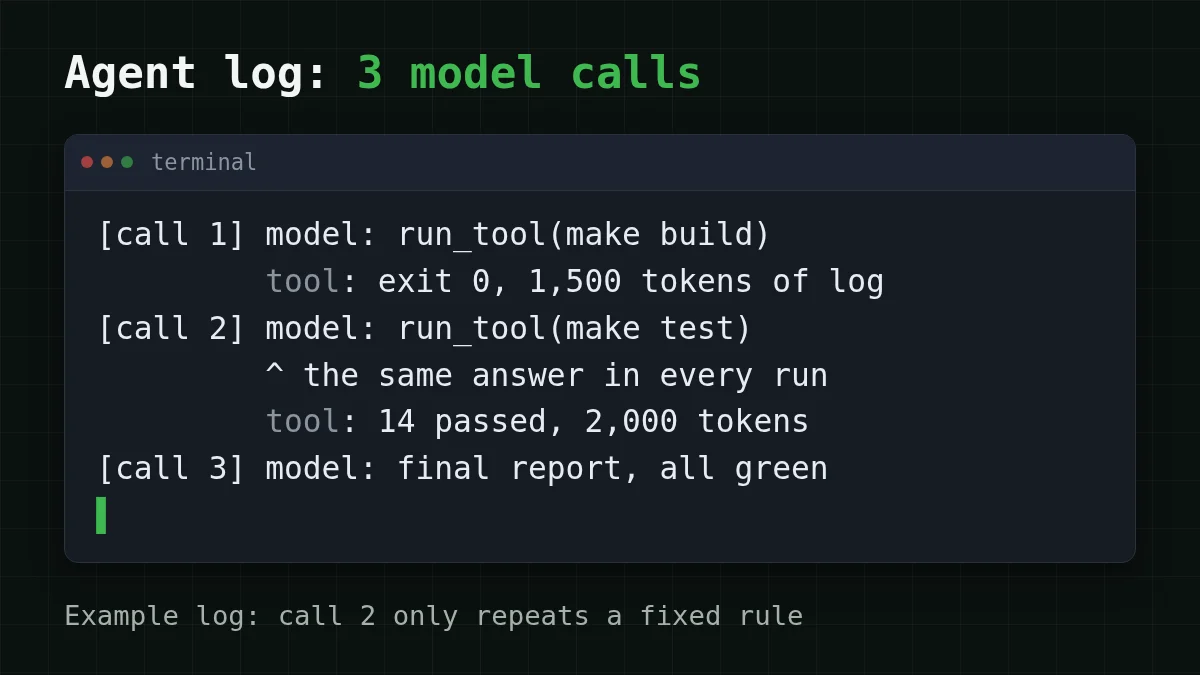
কল ২ হলো মজারটা। বিল্ড পাস করেছে, পরের ধাপ সবসময় টেস্ট, আর মডেল কনটেক্সটের পুরো একটা পাঠ খরচ করে বলে "টেস্ট চালাও"। কল ১ আর কল ৩ আলাদা: কল ১ ঠিক করে কীভাবে শুরু করবে, কল ৩ টেস্টের ফলাফল পড়ে রিপোর্ট লেখে। ওগুলো আসল কাজ।
কোন ধাপে সিদ্ধান্ত দরকার আর কোনটা নির্দিষ্ট#
তিনটা প্রশ্ন বেশিরভাগ ধাপ বাছাই করে:
- পরের কাজটা কি একটা স্পষ্ট সংকেত দিয়ে ঠিক হয়, যেমন একটা এক্সিট কোড, একটা HTTP স্ট্যাটাস বা "পাওয়া গেছে / পাওয়া যায়নি"?
- সংকেতটা এলেই কি কাজটা প্রতিবার একই?
- ভুল অনুমান কি সস্তায় ফেরানো যায়?
তিনটাই হ্যাঁ: এটা একটা নিয়ম হিসেবে লিখুন। নাহলে মডেলই ধাপটা রাখে।
কোডিংয়ের বাইরে আরেকটা উদাহরণ। ধরুন আপনি একটা সাপোর্ট স্ক্রিপ্ট চালান: একজন কাস্টমার লিখেন, স্ক্রিপ্ট অর্ডারটা খোঁজে, তারপর উত্তর দেয়। অর্ডারটা তার নম্বর দিয়ে খোঁজা কোড। একটা টেমপ্লেট থেকে "আপনার অর্ডার {id} হলো {status}" ভরা también কোড। "এটা ভাঙা অবস্থায় এসেছে, এখন কী?" পড়ে রিফান্ড, রিপ্লেসমেন্ট আর ক্ষমাপ্রার্থনার মধ্যে বাছাই করা একটা বিচার, তাই সেটা একটা মডেল কল, তিনটা নয়।
জোড়া মেলান
কোন ধাপ কে সামলাবে?
বাম দিকের একটি আইটেমে ট্যাপ করুন, তারপর তার জোড়ায়
- বিল্ড এক্সিট কোড ০ দিয়ে শেষ, আর পরের ধাপ সবসময় টেস্টকোড: পরের ধাপ নির্দিষ্ট
- টেস্ট স্ট্যাক ট্রেস দিয়ে ব্যর্থ; কোন ফাইলে পরিবর্তন দরকার?মডেল: একটা নতুন বিচার
- নম্বর দিয়ে অর্ডার পাওয়া গেছে, এখন এর স্ট্যাটাস উত্তর টেমপ্লেটে বসাওকোড: টেমপ্লেট ভরাও
- কাস্টমার লেখেন "এটা ভাঙা অবস্থায় এসেছে, এখন কী?"মডেল: মুক্ত টেক্সট পড়া
একটা গার্ড এটাকে নিরাপদ করে: নিয়মটা কেবল হ্যাপি পাথ কভার করে। বিল্ড এক্সিট কোড ১ দিয়ে ব্যর্থ? টেস্ট লাল? একটা টুল এমন কিছু ফেরত দিল যা নিয়মটা আশা করেনি? নিয়ন্ত্রণ মডেলের কাছে ফিরিয়ে দিন, ঠিক আগের মতোই। আপনি কেবল সেই কলগুলো সরাচ্ছেন যাদের একটাই সম্ভাব্য উত্তর ছিল, মডেলকে লুপ থেকে বাদ দিচ্ছেন না।
একটা ৩-ধাপের লুপ, অতিরিক্ত কলসহ ও ছাড়া#
"ব্যর্থ টেস্ট ঠিক করো" লগে সংখ্যা বসাই। অনুমানগুলো, সবই আমাদের আর আপনার দিয়ে বদলানো সহজ:
- সিস্টেম প্রম্পট প্লাস কাজ: ৩,০০০ টোকেন
- বিল্ড লগ: ১,৫০০ টোকেন; টেস্ট লগ: ২,০০০ টোকেন
- একটা উত্তর যা কেবল একটা টুল চায়: ৬০ টোকেন; চূড়ান্ত রিপোর্ট: ৩০০ টোকেন
সংখ্যা অনুমান করুন
টেস্ট রান কোডে গেলে লুপটা কতগুলো মডেল কল করে?
আপনার অনুমান
০৬
উত্তর দেখান
উত্তর: ২
দুটো: একটা বিল্ড শুরু করতে, একটা দুটো ফলাফলই পড়ে রিপোর্ট লিখতে। টেস্ট রানের আর সিদ্ধান্ত দরকার নেই।
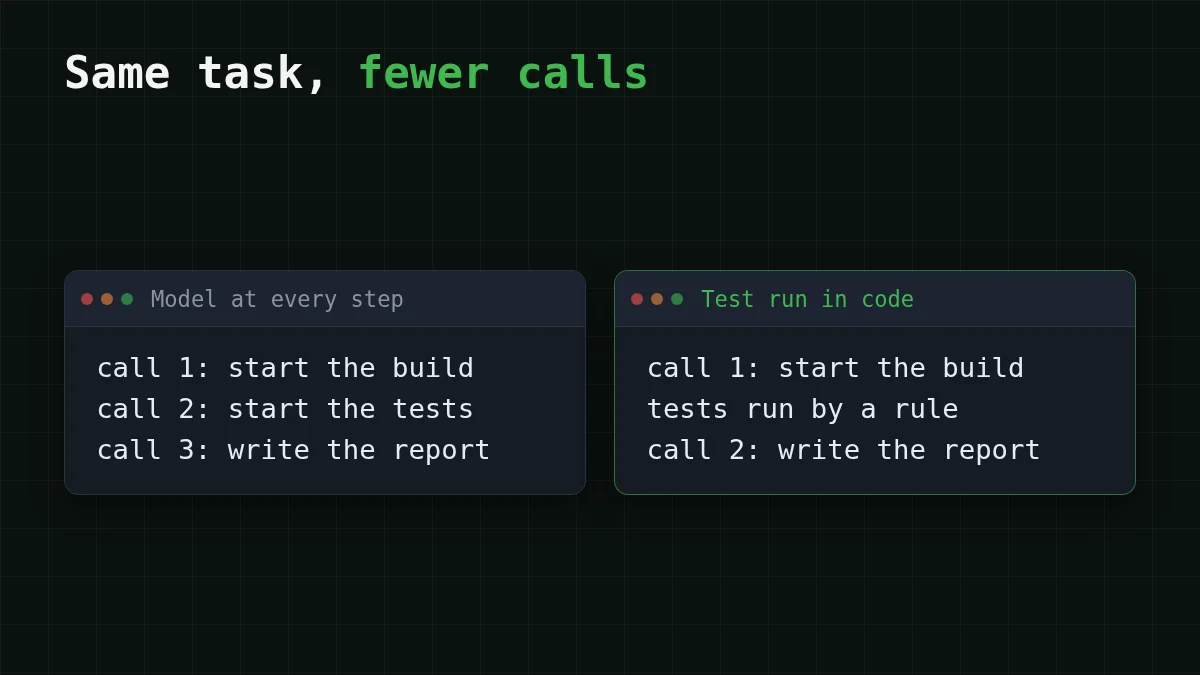
প্রতিটা ধাপে মডেল। কল ১ পড়ে ৩,০০০ টোকেন। কল ২ পড়ে ৩,০০০ + ৬০ + ১,৫০০ = ৪,৫৬০। কল ৩ পড়ে ৪,৫৬০ + ৬০ + ২,০০০ = ৬,৬২০। মোট ইনপুট: ৩,০০০ + ৪,৫৬০ + ৬,৬২০ = ১৪,১৮০ টোকেন; আউটপুট: ৬০ + ৬০ + ৩০০ = ৪২০।
টেস্ট রান কোডে। কল ১ পড়ে ৩,০০০ টোকেন। হারনেস বিল্ড চালায়, তারপর নিয়ম অনুযায়ী টেস্ট, আর কল ২ পড়ে ৩,০০০ + ৬০ + ১,৫০০ + ২,০০০ = ৬,৫৬০। মোট ইনপুট: ৩,০০০ + ৬,৫৬০ = ৯,৫৬০ টোকেন; আউটপুট: ৬০ + ৩০০ = ৩৬০।
পার্থক্য ১৪,১৮০ − ৯,৫৬০ = ৪,৬২০ ইনপুট টোকেন, ইনপুটের প্রায় এক-তৃতীয়াংশ, প্লাস একটা ছোট উত্তর। DeepSeek-V4-Flash-এ এমন একটা কাজের খরচ প্রথম উপায়ে $0.00025 আর দ্বিতীয় উপায়ে $0.00018। একটা কাজ তো রাউন্ডিং এরর। ধরুন আপনার এজেন্ট দিনে ৫০০টা করে (১৪,১৮০ × ৫০০ = ৭,০৯০,০০০ ইনপুট টোকেন, ৪২০ × ৫০০ = ২১০,০০০ আউটপুট টোকেন বনাম ৪,৭৮০,০০০ আর ১৮০,০০০):
ফাঁকটা কনটেক্সটের সাথে বাড়ে: মডেল যত লম্বা লগ টেনে নেয়, একটা বাদ দেওয়া পুনঃপাঠ তত বেশি মূল্যবান। এখানে একই লুপ পাশাপাশি:
কোডে, নিয়মটা কয়েক লাইন। এটা সিউডো-কোড, হেল্পার নামগুলো আপনার:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
HarnessMM লেখকেরা যা রিপোর্ট করেন#
ধারণাটা কেবল আমাদের নয়। HarnessMM হলো arXiv-এ একটা প্রিপ্রিন্ট (arXiv:2610.32813, ২৩ অক্টোবর ২০২৬ জমা দেওয়া, ২ নভেম্বর ২০২৬ যাচাই করা) Yuhua Jiang, Chang Xu, Feifei Gao এবং Li Zhao-এর। তাদের পর্যবেক্ষণ: এজেন্ট হারনেসগুলো প্রায়ই টুল ফিডব্যাকের পর আবার মডেলকে কল করে, এমনকি যখন আগের একটা কল ইতিমধ্যে পরের কাজটা নির্ধারণ করেছে। তাদের সমাধান, গার্ডেড ডিসিশন রিইউজ, সেই সিদ্ধান্তটা রিপ্লে করে এবং নতুন সেমান্টিক সিদ্ধান্ত দেখা দিলে, প্রমাণ অসমর্থিত হলে বা সিলেক্টর বিরত থাকলে মূল মডেলে ফিরে যায়। উপরের if একই ধারণার হাতে লেখা সংস্করণ; তাদের গার্ড কীভাবে সিদ্ধান্ত নেয় তা কাগজে আছে।
লেখকেরা HumanEval-এ এই ফলাফল রিপোর্ট করেন:
- Codex হারনেস: প্রতি কাজে ৬৬.৭২k → ৪৭.০২k টোকেন (−২৯.৫৪%), সফলতা অপরিবর্তিত ৯০.৮২%।
- DeepSeek হারনেস: প্রতি কাজে ৯৬.২৮k → ১১.৬২k টোকেন (−৮৭.৯৩%), সফলতা ৭১.৪৩% → ৮৫.৭১%।
সাবধানে পড়ুন। এটা একটা বেঞ্চমার্ক, লেখকদের নিজেদের হারনেস, একটা প্রিপ্রিন্ট যা পিয়ার-রিভিউ হয়নি, আর arXiv পেজে কোনো কোড তালিকাভুক্ত নেই। পুনর্কথনে আপনি "৮৮%" দেখতে পারেন: সেটা কেবল DeepSeek হারনেসের সংখ্যা, Codex-এরটা প্রায় ৩০%। দুটোকেই একটা দিক হিসেবে নিন, আপনার এজেন্টের জন্য প্রতিশ্রুতি হিসেবে নয়। আপনার নিজের লগ আপনাকে বেশি বলে।
দশ মিনিটে আপনার নিজের এজেন্ট যাচাই করুন#
প্রতিটা মডেল কলের একটা লগ চালু করুন, প্রতিটা রেসপন্সের usage সংখ্যাসহ (পাইথনে এজেন্ট টোকেন খরচ ট্র্যাকিং একটা উপায় দেখায়)। তারপর শেষ বিশটা রান পড়ুন এবং প্রতিটা কল চিহ্নিত করুন: সিদ্ধান্ত না নির্দিষ্ট। একটা কল প্রার্থী যখন পরের কাজটা সেই রানগুলোতে কখনো বদলায়নি। আপনার লগ কী দেখায়?
আপনার কেস বেছে নিন
আপনার লগ কী দেখায়?
উত্তর দেখতে একটি বিকল্প বেছে নিন
প্রতিটা রানে একই জোড়া কল
সেখানে একটা নির্দিষ্ট নিয়ম লুকিয়ে আছে। এটা একটা স্পষ্ট সংকেতে if হিসেবে লিখুন, যেমন এক্সিট কোড, আর সংকেত অপ্রত্যাশিত কিছু হলে মডেলকে ফলব্যাক হিসেবে রাখুন।
যে কলগুলো কেবল টুল আউটপুট রিফরম্যাট বা কপি করে
সেগুলো কোডে একটা টেমপ্লেটে সরান। টেক্সটের সত্যিই মডেল দরকার হলে, সেটা একটা সস্তা মডেলের জন্য ছোট কাজ, আপনার সবচেয়ে বড় মডেলের জন্য নয়।
যে কলগুলোতে পরের ধাপ কনটেন্টের সাথে বদলায়
এখানে মডেল রাখুন। এটাই তার কাজ, আর একটা সস্তা মডেল প্রায়ই একটা সাধারণ ক্লাসিফাই-অ্যান্ড-পিক ধাপ সামলায়; দেখুন মডেল রাউটিং: আগে সস্তা মডেল।
প্রতিটা কল একটা বিশাল লগ আবার পড়ে
কথোপকথনে যা ফিরে যায় তা ছাঁটুন: টুল আউটপুট কনটেক্সটের বাইরে রাখুন। কোনো কল না সরিয়েই একই কাজ সস্তা হয়।
আপনি যদি লম্বা কনটেক্সটের একটা মডেলে এটা চেষ্টা করতে চান, CheapTokens এজেন্ট লুপের জন্য DeepSeek-V4-Flash (deepseek-) পরিবেশন করে: যেকোনো সময়ে এক দাম, ৩৮০K কনটেক্সট এবং প্রতি উত্তরে ৩২,৭৬৮ পর্যন্ত আউটপুট টোকেন। যে ধাপগুলোতে এখনো সিদ্ধান্ত দরকার সেগুলোর জন্য আছে GLM-5.3-Flash (zai-) ৩৯০K কনটেক্সটসহ। দুটোই https:/-এ OpenAI- ও Anthropic-সামঞ্জস্যপূর্ণ API দিয়ে কাজ করে, সব মডেলের জন্য এক ব্যালেন্স। সেটআপ ডকসে, দাম প্রাইসিং পেজে, আর মডেল পেজ সস্তা DeepSeek।


