AI per principiantiGuida
Gli agenti hanno bisogno del modello a ogni passo? Metti i passi fissi nel codice
Perché ogni risultato di un tool innesca un'altra chiamata al modello, quali passi di un agente possono essere semplice codice, e quanto costa un loop a 3 passi con e senza la chiamata extra.
In questa pagina
Il tuo agente ha girato per dieci minuti e il conto è più grande del task. Molto spesso il motivo è banale: dopo ogni risultato di un tool l'harness richiama il modello, anche quando il passo successivo era ovvio.
Quindi no, un agente non ha bisogno del modello a ogni passo. Ha bisogno del modello dove qualcosa va deciso. Un passo che è sempre uguale, come eseguire i test dopo una build andata a buon fine, può essere una semplice regola nel tuo codice.
C'è un motivo economico per interessarsene. Ogni chiamata extra rilegge l'intero contesto come token di input (l'articolo sulle chat lunghe spiega perché), quindi una chiamata saltata fa risparmiare più della sua stessa risposta breve. Se il loop è nuovo per te, parti da come funziona un agente AI e poi torna qui.
Perché un risultato di un tool significa una chiamata in più al modello#
Il modello non esegue mai nulla. Scrive "per favore esegui make build", il tuo harness (il programma attorno al modello) lo esegue, incolla l'output nella conversazione e richiama il modello con tutto quanto finora. Questo è l'intero loop. Il modello scopre cosa ha restituito un tool solo quando lo chiami.
Pensa a un nuovo collega che telefona al manager dopo ogni singolo passo per chiedere "e adesso?", anche se la checklist dice "dopo la compilazione, esegui i test". Il manager risponde sempre la stessa cosa, e ogni chiamata costa un minuto per rileggere tutta la storia dall'inizio.
Ecco come appare in un log di un agente. Diciamo che il task è "correggi il test che fallisce":
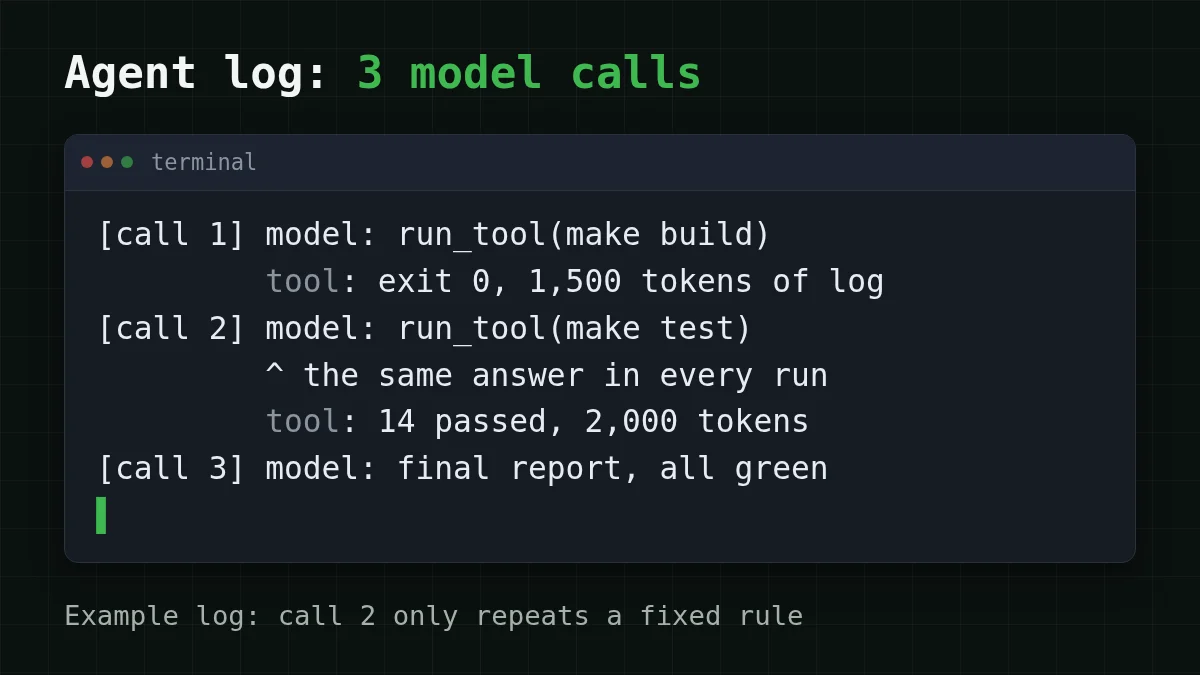
La chiamata 2 è quella interessante. La build è passata, il passo successivo sono sempre i test, e il modello spende una lettura completa del contesto per dire "esegui i test". La chiamata 1 e la chiamata 3 sono diverse: la chiamata 1 sceglie come iniziare, la chiamata 3 legge i risultati dei test e scrive il report. Quello è lavoro vero.
Quali passi richiedono una decisione e quali sono fissi#
Tre domande classificano la maggior parte dei passi:
- L'azione successiva è decisa da un segnale chiaro, come un exit code, uno stato HTTP o "trovato / non trovato"?
- È la stessa azione ogni volta che compare quel segnale?
- Un'ipotesi sbagliata è economica da annullare?
Tre sì: scrivilo come regola. Altrimenti il modello mantiene il passo.
Un secondo esempio, fuori dal coding. Diciamo che gestisci uno script di supporto: un cliente scrive, lo script cerca l'ordine, poi risponde. Cercare l'ordine per numero è codice. Riempire "Il tuo ordine {id} è {status}" da un template è anch'esso codice. Leggere "è arrivato rotto, e adesso?" e scegliere tra un rimborso, una sostituzione e delle scuse è un giudizio, quindi è una chiamata al modello, non tre.
Abbina le coppie
Chi dovrebbe gestire ogni passo?
Tocca un elemento a sinistra, poi il suo abbinamento
- Build terminata con exit code 0, e il passo successivo sono sempre i testCodice: il passo successivo è fisso
- Test falliti con uno stack trace; quale file va modificato?Modello: un nuovo giudizio
- Ordine trovato per numero, ora inserisci il suo stato nel template di rispostaCodice: riempi il template
- Il cliente scrive "è arrivato rotto, e adesso?"Modello: leggere testo libero
Una protezione rende tutto questo sicuro: la regola copre solo il percorso felice. Build fallita con exit code 1? Test rossi? Un tool ha restituito qualcosa che la regola non si aspettava? Riporta il controllo al modello, esattamente come prima. Stai rimuovendo chiamate che avevano una sola risposta possibile, non stai togliendo il modello dal loop.
Un loop a 3 passi, con e senza la chiamata extra#
Mettiamo dei numeri sul log "correggi il test che fallisce". Le ipotesi, tutte nostre e facili da sostituire con le tue:
- system prompt più task: 3.000 token
- log della build: 1.500 token; log dei test: 2.000 token
- una risposta che chiede solo un tool: 60 token; il report finale: 300 token
Indovina il numero
Se l'esecuzione dei test passa nel codice, quante chiamate al modello fa il loop?
La tua risposta
06
Mostra risposta
Risposta: 2
Due: una per avviare la build, una per leggere entrambi i risultati e scrivere il report. L'esecuzione dei test non richiede più una decisione.
Modello a ogni passo. La chiamata 1 legge 3.000 token. La chiamata 2 legge 3.000 + 60 + 1.500 = 4.560. La chiamata 3 legge 4.560 + 60 + 2.000 = 6.620. Input totale: 3.000 + 4.560 + 6.620 = 14.180 token; output: 60 + 60 + 300 = 420.
Esecuzione dei test nel codice. La chiamata 1 legge 3.000 token. L'harness esegue la build, poi i test per regola, e la chiamata 2 legge 3.000 + 60 + 1.500 + 2.000 = 6.560. Input totale: 3.000 + 6.560 = 9.560 token; output: 60 + 300 = 360.
La differenza è 14.180 − 9.560 = 4.620 token di input, circa un terzo dell'input, più una piccola risposta. Su DeepSeek-V4-Flash un task così costa $0.00025 nel primo modo e $0.00018 nel secondo. Un task è un errore di arrotondamento. Diciamo che il tuo agente ne fa 500 al giorno (14.180 × 500 = 7.090.000 token di input, 420 × 500 = 210.000 token di output contro 4.780.000 e 180.000):
Il divario cresce con il contesto: più lunghi sono i log che il modello si trascina, più vale una rilettura saltata. Ecco lo stesso loop affiancato:
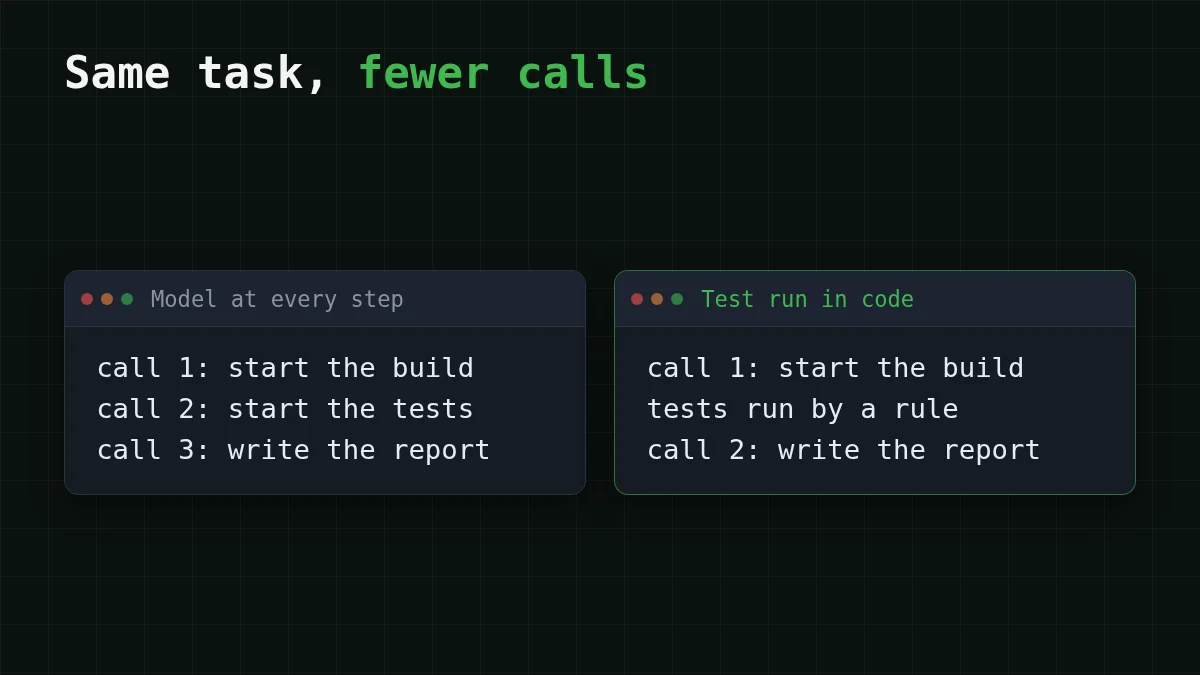
Nel codice, la regola è di poche righe. Questo è pseudo-codice, i nomi degli helper sono i tuoi:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
Cosa riportano gli autori di HarnessMM#
L'idea non è solo nostra. HarnessMM è un preprint su arXiv (arXiv:2610.32813, inviato il 23 ottobre 2026, verificato il 2 novembre 2026) di Yuhua Jiang, Chang Xu, Feifei Gao e Li Zhao. La loro osservazione: gli harness degli agenti spesso richiamano il modello dopo il feedback di un tool anche quando una chiamata precedente aveva già determinato l'azione successiva. La loro soluzione, il riuso delle decisioni con protezione, ripete quella decisione e ricade sul modello originale quando compare una nuova decisione semantica, le prove non sono supportate o il selettore si astiene. Il if qui sopra è la versione scritta a mano della stessa idea; come decide la loro protezione è nel paper.
Gli autori riportano questi risultati su HumanEval:
- Harness Codex: da 66,72k a 47,02k token per task (−29,54%), successo invariato al 90,82%.
- DeepSeek Harness: da 96,28k a 11,62k token per task (−87,93%), successo dal 71,43% all'85,71%.
Leggili con attenzione. È un solo benchmark, l'harness degli stessi autori, un preprint non peer-reviewed, e la pagina arXiv non elenca codice. Potresti vedere "88%" nei racconti: è solo il dato di DeepSeek Harness, quello di Codex è circa il 30%. Tratta entrambi come una direzione, non come una promessa per il tuo agente. Il tuo log ti dice di più.
Controlla il tuo agente in dieci minuti#
Attiva un log di ogni chiamata al modello, con i numeri usage di ogni risposta (tracciare il costo in token di un agente in Python mostra un modo). Poi leggi le ultime venti esecuzioni e contrassegna ogni chiamata: decisione o fissa. Una chiamata è candidata quando l'azione successiva non è mai cambiata in quelle esecuzioni. Cosa mostra il tuo log?
Scegli il tuo caso
Cosa mostra il tuo log?
Scegli un'opzione per vedere la risposta
La stessa coppia di chiamate in ogni esecuzione
Lì si nasconde una regola fissa. Scrivila come un if su un segnale chiaro, come l'exit code, e mantieni il modello come fallback quando il segnale è qualcosa di inatteso.
Chiamate che riformattano o copiano solo l'output di un tool
Spostale in un template nel codice. Se il testo ha davvero bisogno di un modello, è un lavoro piccolo per un modello economico, non per il tuo più grande.
Chiamate in cui il passo successivo cambia con il contenuto
Tieni qui il modello. È a questo che serve, e un modello più economico spesso gestisce un semplice passo di classifica-e-scelta; vedi routing dei modelli: prima il modello economico.
Ogni chiamata rilegge un log enorme
Riduci ciò che torna nella conversazione: tieni l'output dei tool fuori dal contesto. Lo stesso task diventa più economico senza rimuovere nessuna chiamata.
Se vuoi provarlo su un modello con contesto lungo, CheapTokens serve DeepSeek-V4-Flash (deepseek-) per i loop degli agenti: un prezzo a qualsiasi ora, contesto da 380K e fino a 32.768 token di output per risposta. Per i passi che richiedono ancora una decisione c'è GLM-5.3-Flash (zai-) con un contesto da 390K. Entrambi funzionano tramite l'API compatibile con OpenAI e Anthropic su https:/, con un unico saldo per tutti i modelli. La configurazione è nella documentazione, i prezzi sono nella pagina dei prezzi, e la pagina del modello è DeepSeek economico.


