AI入門ガイド
エージェントはすべてのステップでモデルを必要とするか?固定ステップはコードに置く
ツール結果のたびに別のモデル呼び出しが発生する理由、どのエージェントステップが単純なコードで済むか、3ステップのループが余分な呼び出しありとなしでいくらかかるか。
このページの内容
エージェントが10分間動いただけで、タスクそのものより請求額が大きくなることがある。多くの場合、理由は単純だ。ツールの結果が返るたびに、次のステップが明らかでもハーネスがモデルを再度呼び出しているのだ。
つまり、エージェントはすべてのステップでモデルを必要とするわけではない。モデルが必要なのは、何かを判断しなければならない箇所だ。ビルドが通った後にテストを実行するような、常に同じステップは、コード内の単純なルールで済む。
気にするべき金銭的な理由がある。余分な呼び出しはそれぞれ、これまでのコンテキスト全体を入力トークンとして再読み込みする(長いチャットの記事で理由を説明している)ため、呼び出しを1回スキップすれば、その短い回答分以上を節約できる。ループ自体が初めてなら、AIエージェントの仕組みから始めて戻ってきてほしい。
ツール結果1つがモデル呼び出し1回になる理由#
モデルは何も実行しない。モデルは「make buildを実行してください」と書き、ハーネス(モデルの周囲のプログラム)がそれを実行し、出力を会話に貼り付け、これまでのすべてを添えてモデルを再度呼び出す。これがループの全体だ。モデルは、呼び出されたときにだけツールが返した内容を知る。
チェックリストに「コンパイル後にテストを実行する」と書いてあるのに、一歩ごとにマネージャーに電話して「次は?」と尋ねる新人同僚を想像してほしい。マネージャーは毎回同じことを答え、呼び出しのたびに物語全体を最初から読む時間がかかる。
エージェントのログではこうなる。タスクが「失敗しているテストを修正する」だとしよう。
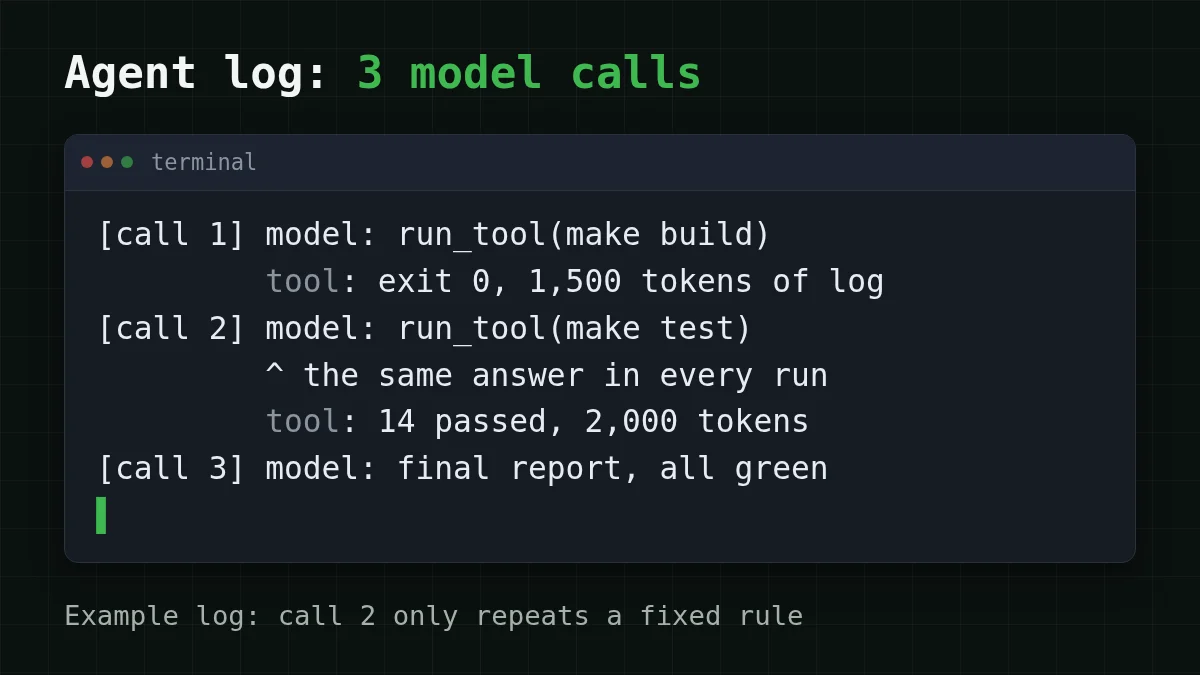
興味深いのは呼び出し2だ。ビルドは通り、次のステップは常にテストであり、モデルは「テストを実行する」と言うためにコンテキスト全体を読み込む。呼び出し1と呼び出し3は異なる。呼び出し1は開始方法を選び、呼び出し3はテスト結果を読んでレポートを書く。これらは実際の作業だ。
どのステップに判断が必要で、どれが固定か#
3つの質問でほとんどのステップを分類できる。
- 次のアクションは、終了コード、HTTPステータス、「見つかった/見つからない」のような明確なシグナルで決まるか?
- そのシグナルが現れたとき、常に同じアクションか?
- 間違った推測を取り消すのは安価か?
3つとも「はい」なら、ルールとして書く。そうでなければ、モデルにそのステップを任せる。
コーディング以外の2つ目の例。サポートスクリプトを動かすとする。顧客が書き込み、スクリプトが注文を検索し、返信する。注文番号で注文を検索するのはコードだ。「Your order {id} is {status}」をテンプレートから埋めるのもコードだ。「壊れて届いた、どうすれば?」を読み、返金、交換、謝罪のどれかを選ぶのは判断なので、モデル呼び出しは1回であり、3回ではない。
ペアを合わせる
各ステップは誰が担当すべきか?
左の項目をタップしてから、そのペアをタップ
- ビルドが終了コード0で完了し、次のステップは常にテストコード: 次のステップは固定
- テストがスタックトレース付きで失敗。どのファイルを変更する必要があるか?モデル: 新たな判断
- 注文が番号で見つかり、そのステータスを返信テンプレートに入れるコード: テンプレートを埋める
- 顧客が「壊れて届いた、どうすれば?」と書くモデル: 自由テキストを読む
これを安全にするガードが1つある。ルールはハッピーパスだけをカバーする。ビルドが終了コード1で失敗した?テストが赤い?ツールがルールの想定外のものを返した?その場合は、これまで通りモデルに制御を戻す。あなたは答えが1つしかない呼び出しを削除しているのであって、モデルをループから外しているのではない。
3ステップのループ、余分な呼び出しありとなし#
「失敗しているテストを修正する」ログに数字を入れてみよう。仮定はすべてこちら側のもので、あなたのものに簡単に置き換えられる。
- システムプロンプトとタスク: 3,000トークン
- ビルドログ: 1,500トークン、テストログ: 2,000トークン
- ツールだけを要求する返信: 60トークン、最終レポート: 300トークン
数字を当てる
テスト実行をコードに移すと、ループはモデルを何回呼び出すか?
あなたの予想
06
答えを表示
答え: 2
2回。1回はビルドを開始するため、もう1回は両方の結果を読んでレポートを書くため。テスト実行には判断が不要になる。
すべてのステップでモデル。 呼び出し1は3,000トークンを読む。呼び出し2は3,000 + 60 + 1,500 = 4,560を読む。呼び出し3は4,560 + 60 + 2,000 = 6,620を読む。入力合計: 3,000 + 4,560 + 6,620 = 14,180トークン、出力: 60 + 60 + 300 = 420。
テスト実行をコードで。 呼び出し1は3,000トークンを読む。ハーネスはビルドを実行し、次にルールに従ってテストを実行し、呼び出し2は3,000 + 60 + 1,500 + 2,000 = 6,560を読む。入力合計: 3,000 + 6,560 = 9,560トークン、出力: 60 + 300 = 360。
差は14,180 − 9,560 = 4,620入力トークンで、入力の約3分の1に加えて小さな回答1つ分だ。DeepSeek-V4-Flashでは、そのようなタスク1つは前者で$0.00025、後者で$0.00018かかる。1タスクは誤差の範囲だ。エージェントが1日に500タスクこなすとしよう(14,180 × 500 = 7,090,000入力トークン、420 × 500 = 210,000出力トークンに対し、4,780,000と180,000)。
差はコンテキストとともに大きくなる。モデルが引きずるログが長いほど、スキップした再読み込みの価値が高まる。同じループを並べて示す。
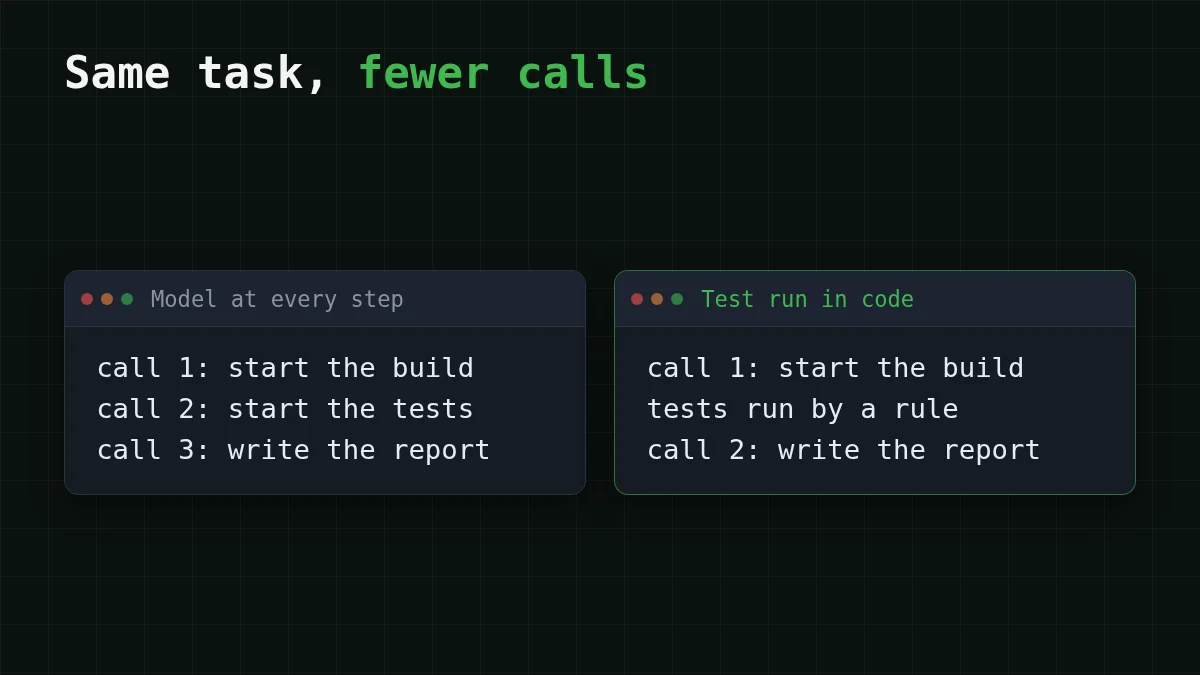
コードでは、ルールは数行だ。これは疑似コードで、ヘルパー名はあなたのものだ。
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages) # the model reads everything onceHarnessMMの著者が報告していること#
このアイデアは我々だけのものではない。HarnessMMはarXivのプレプリント(arXiv:2610.32813、2026年10月23日提出、2026年11月2日確認)で、Yuhua Jiang、Chang Xu、Feifei Gao、Li Zhaoによるものだ。彼らの観察: エージェントハーネスは、以前の呼び出しがすでに次のアクションを決定していたとしても、ツールフィードバックの後にモデルを再度呼び出すことがよくある。彼らの修正であるガード付き決定再利用は、その決定を再生し、新しい意味論的な決定が現れた場合、証拠がサポートされていない場合、またはセレクタが棄権した場合に元のモデルにフォールバックする。上記のifは同じアイデアの手書き版であり、彼らのガードがどのように決定するかは論文にある。
著者らはHumanEvalでこれらの結果を報告している。
- Codexハーネス: タスクあたり66.72k → 47.02kトークン(−29.54%)、成功率は90.82%で変わらず。
- DeepSeek Harness: タスクあたり96.28k → 11.62kトークン(−87.93%)、成功率71.43% → 85.71%。
注意して読んでほしい。1つのベンチマークであり、著者自身のハーネスであり、査読されていないプレプリントであり、arXivページにはコードが掲載されていない。再話で「88%」を見るかもしれないが、それはDeepSeek Harnessの数字だけで、Codexのものは約30%だ。どちらも方向性として扱い、あなたのエージェントへの約束として扱わないこと。あなた自身のログの方が多くを語る。
自分のエージェントを10分でチェックする#
すべてのモデル呼び出しのログをオンにし、各応答からusageの数字を記録する(Pythonでエージェントのトークンコストを追跡するに1つの方法がある)。次に直近20回の実行を読み、各呼び出しを判断か固定かでマークする。それらの実行を通じて次のアクションが一度も変わらなかった呼び出しは候補だ。あなたのログは何を示しているか?
ケースを選ぶ
あなたのログは何を示しているか?
オプションを選択して答えを表示
毎回同じ呼び出しのペア
そこには固定ルールが隠れている。終了コードのような明確なシグナルに対するifとして書き、シグナルが予期しないものである場合はモデルをフォールバックとして残す。
ツール出力を再フォーマットまたはコピーするだけの呼び出し
それらをコード内のテンプレートに移す。テキストに本当にモデルが必要なら、それは安価なモデル向けの小さな仕事であり、最大のモデル向けではない。
次のステップが内容によって変わる呼び出し
ここではモデルを残す。これがモデルの目的であり、安価なモデルが単純な分類と選択のステップを処理できることが多い。モデルルーティング: 安価なモデルを最初にを参照。
すべての呼び出しが巨大なログを再読み込みする
会話に戻すものを削減する: ツール出力をコンテキストから除外する。同じタスクが、呼び出しを削除せずに安くなる。
長いコンテキストを持つモデルでこれを試したいなら、CheapTokensはエージェントループ向けにDeepSeek-V4-Flash(deepseek-)を提供している。時間帯を問わず1つの価格で、380Kコンテキストと回答あたり最大32,768出力トークン。まだ判断が必要なステップには、390KコンテキストのGLM-5.3-Flash(zai-)がある。どちらもhttps:/のOpenAIおよびAnthropic互換APIを通じて動作し、すべてのモデルで1つの残高を使う。セットアップはドキュメントに、価格は価格ページに、モデルページは安価なDeepSeekにある。


