AI cho người mớiHướng dẫn
Agent có cần model ở mọi bước không? Đưa các bước cố định vào code
Tại sao mỗi kết quả công cụ lại kích hoạt một lần gọi model nữa, bước nào của agent có thể là code thuần, và một vòng lặp 3 bước tốn bao nhiêu khi có và không có lần gọi thêm.
Trên trang này
Agent của bạn chạy mười phút, và hóa đơn còn lớn hơn cả công việc. Rất thường xuyên, lý do thật nhàm chán: sau mỗi kết quả công cụ, harness lại gọi model một lần nữa, kể cả khi bước tiếp theo đã quá rõ ràng.
Vậy nên không, một agent không cần model ở mọi bước. Nó cần model ở những nơi phải quyết định điều gì đó. Một bước luôn giống hệt nhau, như chạy test sau một bản build đã pass, có thể chỉ là một quy tắc đơn giản trong code của bạn.
Có một lý do về tiền để bạn quan tâm. Mỗi lần gọi thêm sẽ đọc lại toàn bộ ngữ cảnh như input token (bài viết về hội thoại dài giải thích tại sao), nên một lần gọi bị bỏ qua tiết kiệm nhiều hơn cả câu trả lời ngắn của chính nó. Nếu vòng lặp này còn mới với bạn, hãy bắt đầu với cách một AI agent hoạt động rồi quay lại.
Tại sao một kết quả công cụ lại kéo theo một lần gọi model nữa#
Model không bao giờ tự chạy bất cứ thứ gì. Nó viết "làm ơn chạy make build", harness của bạn (chương trình bao quanh model) chạy lệnh đó, dán kết quả vào cuộc hội thoại và gọi model lại với toàn bộ nội dung đến lúc đó. Đó là toàn bộ vòng lặp. Model chỉ biết công cụ trả về gì khi bạn gọi nó.
Hãy nghĩ đến một đồng nghiệp mới, người gọi điện cho quản lý sau từng bước một để hỏi "giờ làm gì?", dù danh sách kiểm tra đã ghi rõ "sau khi biên dịch, chạy test". Quản lý trả lời y hệt mỗi lần, và mỗi cuộc gọi tốn một phút đọc lại toàn bộ câu chuyện từ đầu.
Đây là những gì trông như thế trong log của một agent. Giả sử nhiệm vụ là "sửa test đang fail":
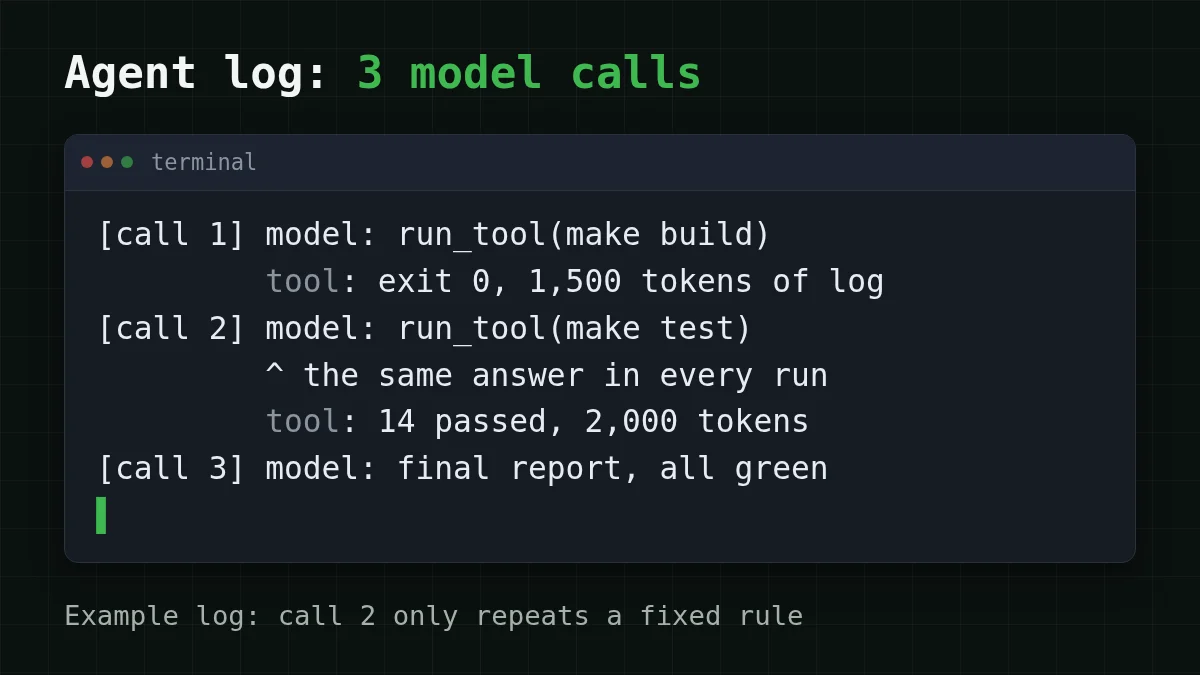
Lần gọi 2 là lần thú vị. Build đã pass, bước tiếp theo luôn là chạy test, và model tốn một lần đọc toàn bộ ngữ cảnh chỉ để nói "chạy test". Lần gọi 1 và lần gọi 3 thì khác: lần gọi 1 chọn cách bắt đầu, lần gọi 3 đọc kết quả test và viết báo cáo. Đó là công việc thật.
Bước nào cần quyết định và bước nào cố định#
Ba câu hỏi phân loại được hầu hết các bước:
- Hành động tiếp theo có được quyết định bởi một tín hiệu rõ ràng không, như mã thoát, mã trạng thái HTTP hay "tìm thấy / không tìm thấy"?
- Có phải mỗi khi tín hiệu đó xuất hiện thì luôn là cùng một hành động không?
- Nếu đoán sai thì có dễ sửa không?
Ba câu trả lời "có": hãy viết nó thành một quy tắc. Nếu không, model giữ bước đó.
Một ví dụ thứ hai, ngoài lĩnh vực lập trình. Giả sử bạn chạy một script hỗ trợ: khách hàng viết vào, script tra cứu đơn hàng, rồi trả lời. Tra cứu đơn hàng theo số là code. Điền "Đơn hàng {id} của bạn đang ở trạng thái {status}" từ một template cũng là code. Đọc "hàng đến bị vỡ, giờ sao?" và chọn giữa hoàn tiền, đổi hàng và xin lỗi là một phán đoán, nên đó là một lần gọi model, không phải ba.
Ghép cặp
Ai nên xử lý từng bước?
Nhấn vào một mục bên trái, rồi đến cặp của nó
- Build xong với mã thoát 0, và bước tiếp theo luôn là chạy testCode: bước tiếp theo là cố định
- Test fail với stack trace; file nào cần sửa?Model: một phán đoán mới
- Tìm thấy đơn hàng theo số, giờ đưa trạng thái của nó vào template trả lờiCode: điền template
- Khách hàng viết "hàng đến bị vỡ, giờ sao?"Model: đọc văn bản tự do
Một chốt chặn khiến điều này an toàn: quy tắc chỉ bao phủ happy path. Build fail với mã thoát 1? Test đỏ? Một công cụ trả về thứ mà quy tắc không lường trước? Hãy trả quyền điều khiển lại cho model, y như trước. Bạn đang loại bỏ những lần gọi chỉ có một câu trả lời duy nhất, chứ không đưa model ra khỏi vòng lặp.
Một vòng lặp 3 bước, có và không có lần gọi thêm#
Hãy đặt con số cho log "sửa test đang fail". Các giả định, đều là của chúng tôi và dễ thay bằng của bạn:
- system prompt cộng nhiệm vụ: 3.000 token
- log build: 1.500 token; log test: 2.000 token
- một câu trả lời chỉ yêu cầu gọi công cụ: 60 token; báo cáo cuối: 300 token
Đoán số
Nếu lần chạy test chuyển vào code, vòng lặp thực hiện bao nhiêu lần gọi model?
Dự đoán của bạn
06
Hiện đáp án
Trả lời: 2
Hai: một để bắt đầu build, một để đọc cả hai kết quả và viết báo cáo. Lần chạy test không còn cần quyết định nữa.
Model ở mọi bước. Lần gọi 1 đọc 3.000 token. Lần gọi 2 đọc 3.000 + 60 + 1.500 = 4.560. Lần gọi 3 đọc 4.560 + 60 + 2.000 = 6.620. Tổng input: 3.000 + 4.560 + 6.620 = 14.180 token; output: 60 + 60 + 300 = 420.
Chạy test trong code. Lần gọi 1 đọc 3.000 token. Harness chạy build, rồi chạy test theo quy tắc, và lần gọi 2 đọc 3.000 + 60 + 1.500 + 2.000 = 6.560. Tổng input: 3.000 + 6.560 = 9.560 token; output: 60 + 300 = 360.
Chênh lệch là 14.180 − 9.560 = 4.620 input token, khoảng một phần ba lượng input, cộng thêm một câu trả lời nhỏ. Trên DeepSeek-V4-Flash, một nhiệm vụ như vậy tốn $0.00025 theo cách thứ nhất và $0.00018 theo cách thứ hai. Một nhiệm vụ chỉ là sai số làm tròn. Giả sử agent của bạn làm 500 nhiệm vụ mỗi ngày (14.180 × 500 = 7.090.000 input token, 420 × 500 = 210.000 output token so với 4.780.000 và 180.000):
Khoảng cách tăng theo ngữ cảnh: log càng dài mà model phải kéo theo, thì một lần đọc lại bị bỏ qua càng đáng giá. Đây là cùng một vòng lặp đặt cạnh nhau:
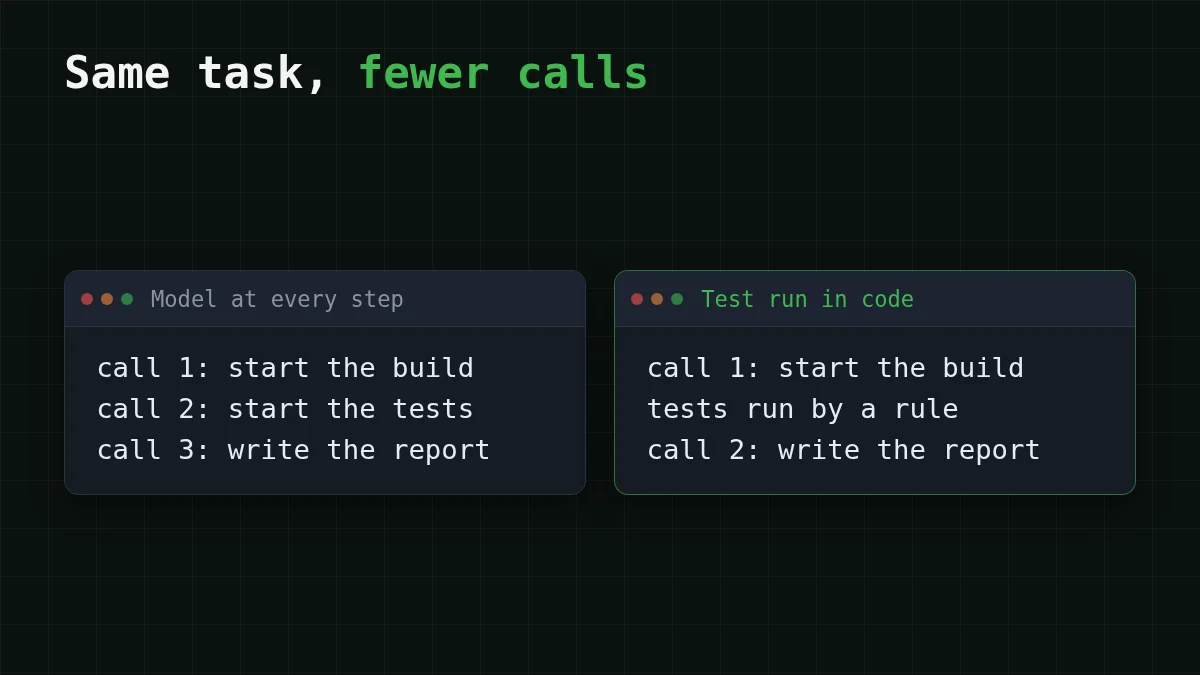
Trong code, quy tắc chỉ là vài dòng. Đây là pseudo-code, tên các hàm phụ là của bạn:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
Những gì các tác giả HarnessMM báo cáo#
Ý tưởng này không chỉ của chúng tôi. HarnessMM là một preprint trên arXiv (arXiv:2610.32813, nộp ngày 23 tháng 10 năm 2026, kiểm tra ngày 2 tháng 11 năm 2026) của Yuhua Jiang, Chang Xu, Feifei Gao và Li Zhao. Quan sát của họ: các harness agent thường gọi model lại sau phản hồi công cụ kể cả khi một lần gọi trước đó đã xác định hành động tiếp theo. Cách khắc phục của họ, tái sử dụng quyết định có chốt chặn, phát lại quyết định đó và quay về model gốc khi xuất hiện một quyết định ngữ nghĩa mới, khi bằng chứng không được hỗ trợ hoặc khi bộ chọn từ chối. Đoạn if ở trên là phiên bản viết tay của cùng ý tưởng đó; cách chốt chặn của họ quyết định ra sao thì nằm trong bài báo.
Các tác giả báo cáo những kết quả này trên HumanEval:
- Harness Codex: 66,72k → 47,02k token mỗi nhiệm vụ (−29,54%), tỉ lệ thành công không đổi ở 90,82%.
- DeepSeek Harness: 96,28k → 11,62k token mỗi nhiệm vụ (−87,93%), tỉ lệ thành công 71,43% → 85,71%.
Hãy đọc chúng một cách thận trọng. Đó là một benchmark, harness của chính các tác giả, một preprint chưa qua bình duyệt, và trang arXiv không liệt kê code. Bạn có thể thấy "88%" trong các bài kể lại: đó chỉ là con số của DeepSeek Harness, còn con số của Codex khoảng 30%. Hãy coi cả hai như một hướng đi, không phải lời hứa cho agent của bạn. Log của chính bạn nói cho bạn nhiều hơn.
Kiểm tra agent của bạn trong mười phút#
Bật log mọi lần gọi model, kèm các con số usage từ mỗi phản hồi (theo dõi chi phí token của agent bằng Python chỉ ra một cách). Sau đó đọc hai mươi lần chạy gần nhất và đánh dấu từng lần gọi: quyết định hay cố định. Một lần gọi là ứng viên khi hành động tiếp theo không bao giờ thay đổi qua những lần chạy đó. Log của bạn cho thấy gì?
Chọn trường hợp của bạn
Log của bạn cho thấy gì?
Chọn một tùy chọn để xem đáp án
Cùng một cặp lần gọi trong mọi lần chạy
Một quy tắc cố định đang ẩn ở đó. Hãy viết nó thành một if trên một tín hiệu rõ ràng, như mã thoát, và giữ model làm phương án dự phòng khi tín hiệu là bất cứ điều gì bất thường.
Những lần gọi chỉ định dạng lại hoặc sao chép kết quả công cụ
Hãy chuyển chúng vào một template trong code. Nếu văn bản thực sự cần model, đó là việc nhỏ cho một model rẻ, không phải model lớn nhất của bạn.
Những lần gọi mà bước tiếp theo thay đổi theo nội dung
Giữ model ở đây. Đây chính là việc của nó, và một model rẻ hơn thường xử lý được một bước phân loại và chọn đơn giản; xem định tuyến model: model rẻ trước.
Mỗi lần gọi đều đọc lại một log khổng lồ
Hãy cắt bớt những gì quay lại cuộc hội thoại: giữ kết quả công cụ ra khỏi ngữ cảnh. Cùng một nhiệm vụ trở nên rẻ hơn mà không cần bỏ lần gọi nào.
Nếu bạn muốn thử điều này trên một model có ngữ cảnh dài, CheapTokens cung cấp DeepSeek-V4-Flash (deepseek-) cho các vòng lặp agent: một mức giá ở mọi thời điểm, ngữ cảnh 380K và tối đa 32.768 output token mỗi câu trả lời. Cho những bước vẫn cần quyết định, có GLM-5.3-Flash (zai-) với ngữ cảnh 390K. Cả hai hoạt động qua API tương thích OpenAI và Anthropic tại https:/, với một số dư cho mọi model. Cách thiết lập có trong tài liệu, giá có trên trang giá, và trang model là DeepSeek giá rẻ.


