Tối ưu chi phíPhân tích
Lập ngân sách cho dự án agent dài hơi: tính toán so với token (trường hợp RSA-260)
Tiêu đề $400k của RSA-260 là tiền thuê GPU, không phải token mô hình. Chia dự án agent dài hơi thành ba dòng ngân sách và ước tính phần token bằng số phiên × số bước × token.
Trên trang này
Con số ~$400k từ việc phân tích RSA-260 của Cognition là tiền thuê GPU, không phải hóa đơn mô hình. Báo cáo không định giá phần agent chút nào, vì vậy nếu bạn dự định một dự án agent dài hơi, bạn tự ước tính phần token: số phiên × số bước × token mỗi bước, theo giá hiện hành. Đó là những gì phần còn lại của trang này làm.
Nguồn là bài viết của Eric Lu, kỹ sư tại Cognition (Factoring RSA-260, xuất bản ngày 9 tháng 9 năm 2026, kiểm tra ngày 6 tháng 11 năm 2026). Bài viết đang được chia sẻ lại với con số đô-la trên tiêu đề, và con số này rất dễ bị hiểu nhầm.
$400k thực sự trả cho cái gì#
Tác giả đã phân tích một số 260 chữ số bằng GNFS, sử dụng CADO-NFS được sửa đổi nhiều để chạy trên GPU. Báo cáo đưa ra thời gian GPU cho từng giai đoạn:
- chọn đa thức: 643 ngày GPU
- sàng: 3.813 ngày GPU
- giải hệ tuyến tính: 467 ngày GPU
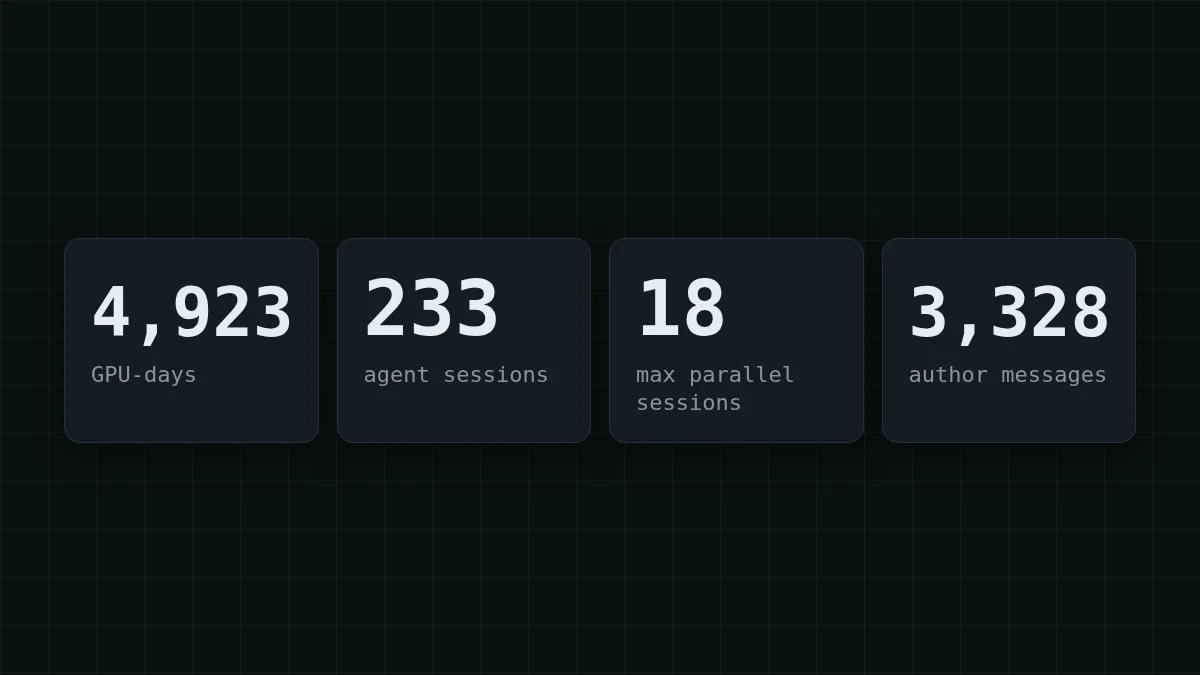
Tổng cộng 643 + 3.813 + 467 = 4.923 ngày GPU, báo cáo làm tròn thành ~4.900. Với mức $3,50 mỗi giờ GPU mà báo cáo giả định:
4.923 × 24 × 3,50 = 413.532
Con số này khớp với con số $414k GPU trong phụ lục. Vậy tiêu đề nói về phần cứng thuê chạy một công việc tính toán số học trong nhiều tuần. Không có token mô hình nào trong tổng đó.
Kiểm tra nhanh
Con số ~$400k trong báo cáo RSA-260 là gì?
Hiện đáp án
Trả lời: Thuê GPU theo giá thị trường cho quá trình phân tích
Nó đến từ số ngày GPU × $3,50 mỗi giờ GPU. Báo cáo không nêu tên mô hình nào và không đưa ra số lượng token cho phần agent.
Các agent đã làm gì, và báo cáo không nói gì#
Phần agent được mô tả bằng hoạt động, không phải bằng chi phí. Lời nhắc đầu tiên được gửi vào ngày 13 tháng 8 năm 2026, công việc mất khoảng ba tuần, và các con số là:
- 233 phiên Devin cho việc phân tích, trung bình 3 phiên chạy song song và cao nhất 18 phiên
- 192 phiên nhận tin nhắn từ tác giả, 36 phiên chạy hoàn toàn không có can thiệp của con người
- 101 phiên con được khởi tạo bởi các phiên khác
- Tính toán của chính Devin: 14.450 ACU (đơn vị của Devin, không phải token)
Các phiên xử lý việc đo đạc, vận hành cụm, tinh chỉnh và gỡ lỗi. Con người đặt ra các ưu tiên và xây dựng các bài kiểm tra chuẩn. Hai chi tiết trung thực từ tác giả: việc phân rã xung quanh CADO-NFS do con người thiết kế và rất quan trọng, và các agent càng bối rối khi mã càng lệch khỏi bản gốc.
Điều còn thiếu chính là thứ mà một ngân sách cần: mô hình nào, bao nhiêu token. Vì vậy đừng cố suy ra hóa đơn token từ 14.450 ACU. Bất cứ điều gì bạn đọc trên mạng làm vậy đều là phỏng đoán.
Dòng thứ ba: con người điều hướng#
Tác giả đã gửi 3.328 tin nhắn, tổng cộng 82.702 từ. Tức là 82.702 ÷ 3.328 ≈ 25 từ mỗi tin nhắn, những lời nhắc ngắn gọn chứ không phải bài luận. Những từ đó tốn gần như không đáng kể token. Chúng tốn sự chú ý: ai đó phải đọc những gì agent đã làm và quyết định bước tiếp theo. Khi lập ngân sách cho một dự án agent, hãy đưa nó vào một dòng riêng tính bằng giờ, không phải đô-la sử dụng API.
Vậy một dự án agent dài hơi có ba dòng:
Cuộn bảng sang phải →
| Dòng | Trong báo cáo RSA-260 | Điều gì quyết định nó cho bạn |
|---|---|---|
| Tính toán | ~$414k thời gian GPU, giá $3,50 mỗi giờ GPU | Công việc của chính bạn: build, test, huấn luyện, mô phỏng |
| Token mô hình | Không được báo cáo | Số phiên × số bước × token mỗi bước |
| Con người điều hướng | 3.328 tin nhắn trong ~3 tuần | Bạn xem xét và chuyển hướng bao lâu một lần |
Ước tính dòng token của bạn#
Đây là công thức, và điều mọi người hay quên: mỗi bước gửi lại toàn bộ lịch sử. Một agent không nhớ một phiên; mỗi lần gọi mang theo nhiệm vụ, các tệp nó đã đọc và đầu ra công cụ cho đến nay. Đó là lý do token đầu vào thường lớn hơn nhiều so với token đầu ra (xem thêm trong tại sao AI agent dùng nhiều token đến vậy).
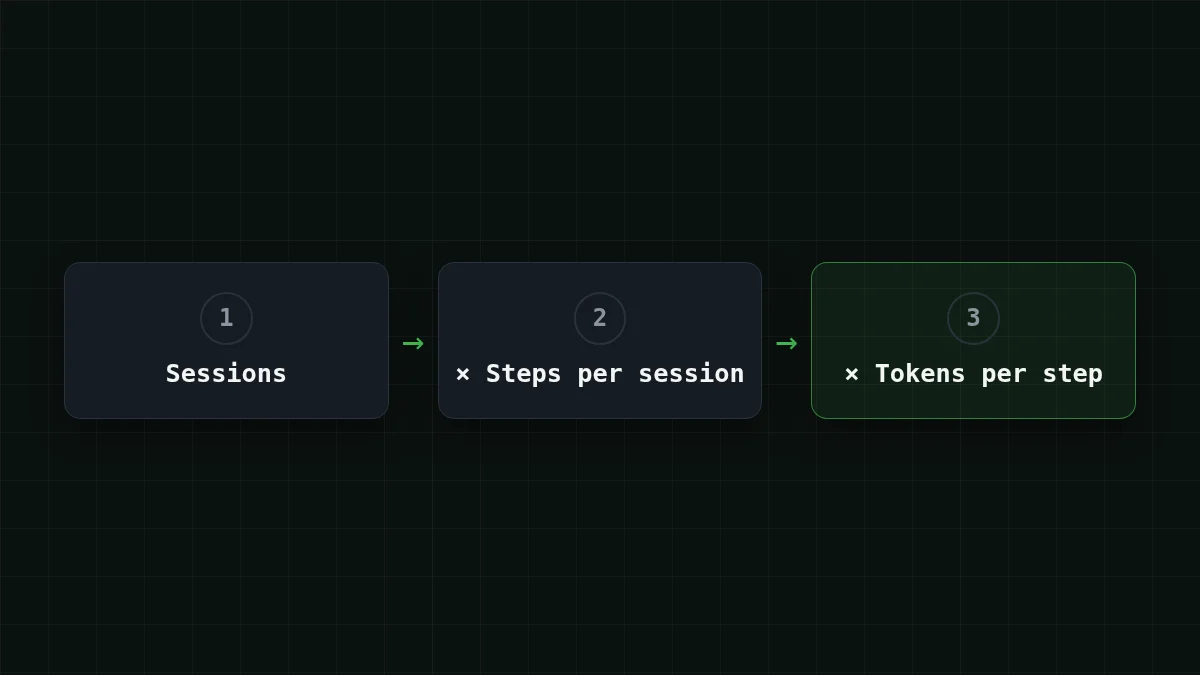
Giả sử bạn lên kế hoạch một dự án cỡ của Cognition, 233 phiên, và bạn giả định 60 bước mỗi phiên. Hai con số này là giả định của trang này, không phải dữ liệu của Cognition. Khi đó:
233 × 60 = 13.980
tức là 13.980 lần gọi mô hình. Giờ đến kích thước một lần gọi. Giả sử một bước trung bình gửi 60.000 token vào (nhiệm vụ, lịch sử, một hai tệp) và nhận về 1.500 token (một lệnh hoặc một bản vá). Tổng:
60.000 × 13.980 = 838.800.000
1.500 × 13.980 = 20.970.000
Vậy khoảng 839 triệu token đầu vào và 21 triệu token đầu ra. Đầu vào gấp bốn mươi lần đầu ra, và đó là phía mà ngân sách của bạn nằm. Trên DeepSeek-V4-Flash, dự án đó tốn $14.68, và một phiên 60 bước tốn $0.063. Đây là cùng khối lượng trên mọi mô hình, với tham chiếu OpenRouter bên cạnh:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 13.980 yêu cầu | OpenRouter, 13.980 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
60.000 token đầu vào và 1.500 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Tính tổng, gồm cả đầu vào và đầu ra, mỗi mô hình của chúng tôi đều rẻ hơn OpenRouter cho khối lượng này. Giá được lấy trực tiếp từ trang giá, nên bảng sẽ thay đổi khi giá thay đổi.
Tự mình thử xemThử xem: phiên 60 bước trung bình gửi 60.000 token vào. Bước 1 có gửi nhiều như bước 60 không?Hiện đáp án
Không. Bước 1 gửi ít (nhiệm vụ và vài tệp), bước 60 gửi lại mọi thứ đã thu thập dọc đường. Lấy 60.000 làm trung bình giả định phiên bắt đầu nhỏ và kết thúc gần 100K hoặc hơn. Nếu bạn biết phiên của mình kết thúc ở, ví dụ, 120K, thì trung bình khoảng một nửa con số đó, vì vậy hãy đo yêu cầu lớn nhất, không chỉ trung bình.
Có được con số của riêng bạn trong mười phút#
Giả định chỉ là điểm khởi đầu. Chạy một phiên thực tế của nhiệm vụ bạn trên một mô hình rẻ và đọc đối tượng usage mà API trả về trên mỗi phản hồi. Các endpoint tương thích OpenAI báo cáo prompt_tokens và completion_ mỗi lần gọi:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
Cộng usage trên toàn bộ phiên, chia cho số lần gọi, và thay 60.000 và 1.500 ở trên bằng giá trị trung bình của bạn. Chi tiết thiết lập có trong tài liệu CheapTokens; theo dõi từng bước trong mã có trong theo dõi chi phí token của AI agent bằng Python. Với phép tính tương tự trên một phiên 50 bước, xem chi phí phiên agent trên GLM, DeepSeek hoặc MiniMax.
Với các vòng lặp dài, DeepSeek-V4-Flash có cửa sổ ngữ cảnh 380K và tối đa 32.768 token đầu ra mỗi câu trả lời, với một mức giá bất kể giờ nào. GLM-5.3-Flash có cửa sổ 390K và MiniMax-M2.7 có 180K, vì vậy hãy kiểm tra rằng yêu cầu lớn nhất của bạn vừa.
Chọn trường hợp của bạn
Dự án của bạn giống trường hợp nào?
Chọn một tùy chọn để xem đáp án
Nhiều phiên ngắn
Nhiệm vụ nhỏ, mỗi phiên bắt đầu mới: token đầu vào mỗi lần gọi vẫn thấp. Nhân số phiên với số bước, và dự kiến tổng sẽ bị chi phối bởi số lần gọi, không phải kích thước của chúng.
Vài phiên rất dài
Lịch sử tăng dần trong phiên, nên các bước cuối là những bước tốn kém. Ước tính với yêu cầu lớn nhất, chia công việc thành các phiên con với bản tóm tắt ngắn mỗi phiên, và đầu vào không còn tăng dồn.
Tính toán nặng cộng với agent
Giống RSA-260: công việc tự nó cần phần cứng. Định giá phần cứng theo giờ từ nhà cung cấp của bạn, và giữ dòng token như một ước tính riêng. Chúng không cộng lại trong đầu bạn, chỉ trong bảng tính.
Thu hẹp nhiệm vụ trước khi tăng ngân sách#
Báo cáo có thêm một bài học phù hợp với ngân sách: mã càng lệch khỏi bản gốc, các agent càng bối rối. Agent bối rối mất nhiều bước hơn. Nếu ước tính của bạn có vẻ quá cao, hãy giảm số bước mỗi phiên trước: bản tóm tắt rõ ràng hơn, phạm vi mã nhỏ hơn, các bước cố định chuyển vào script (xem agent có cần mô hình ở mọi bước không). Giảm một nửa số bước là giảm một nửa dòng token; đó là đòn bẩy dễ nhất bạn có.


