การลดต้นทุนการวิเคราะห์เจาะลึก
ตั้งงบโปรเจกต์เอเจนต์ระยะยาว: คอมพิวต์ vs token (กรณี RSA-260)
พาดหัว $400k ของ RSA-260 คือค่าเช่า GPU ไม่ใช่ token ของโมเดล แยกโปรเจกต์เอเจนต์ระยะยาวเป็นสามบรรทัดงบประมาณ และประเมินส่วน token ด้วยเซสชัน × สเต็ป × token
ในหน้านี้
ตัวเลข ~$400k จากงานแยกตัวประกอบ RSA-260 ของ Cognition คือค่าเช่า GPU ไม่ใช่ค่าโมเดล รายงานไม่ได้ประเมินฝั่งเอเจนต์เลย ดังนั้นถ้าคุณวางแผนโปรเจกต์เอเจนต์ระยะยาว คุณต้องประมาณค่า token เอง: จำนวนเซสชัน × จำนวนสเต็ป × token ต่อสเต็ป ด้วยราคาจริง ส่วนที่เหลือของหน้านี้จะทำแบบนั้น
แหล่งข้อมูลคือบทความของ Eric Lu วิศวกรที่ Cognition (Factoring RSA-260, เผยแพร่ 9 กันยายน 2026, ตรวจสอบ 6 พฤศจิกายน 2026) มีการแชร์ซ้ำโดยยกตัวเลขดอลลาร์ขึ้นพาดหัว และตัวเลขนั้นอ่านผิดได้ง่าย
$400k จ่ายค่าอะไรจริง ๆ#
ผู้เขียนแยกตัวประกอบตัวเลข 260 หลักด้วย GNFS โดยใช้ CADO-NFS ที่ดัดแปลงอย่างหนักให้รันบน GPU รายงานระบุเวลา GPU ของแต่ละเฟส:
- การเลือกพหุนาม: 643 GPU-day
- การกรอง (sieving): 3,813 GPU-day
- การแก้ระบบเชิงเส้น: 467 GPU-day
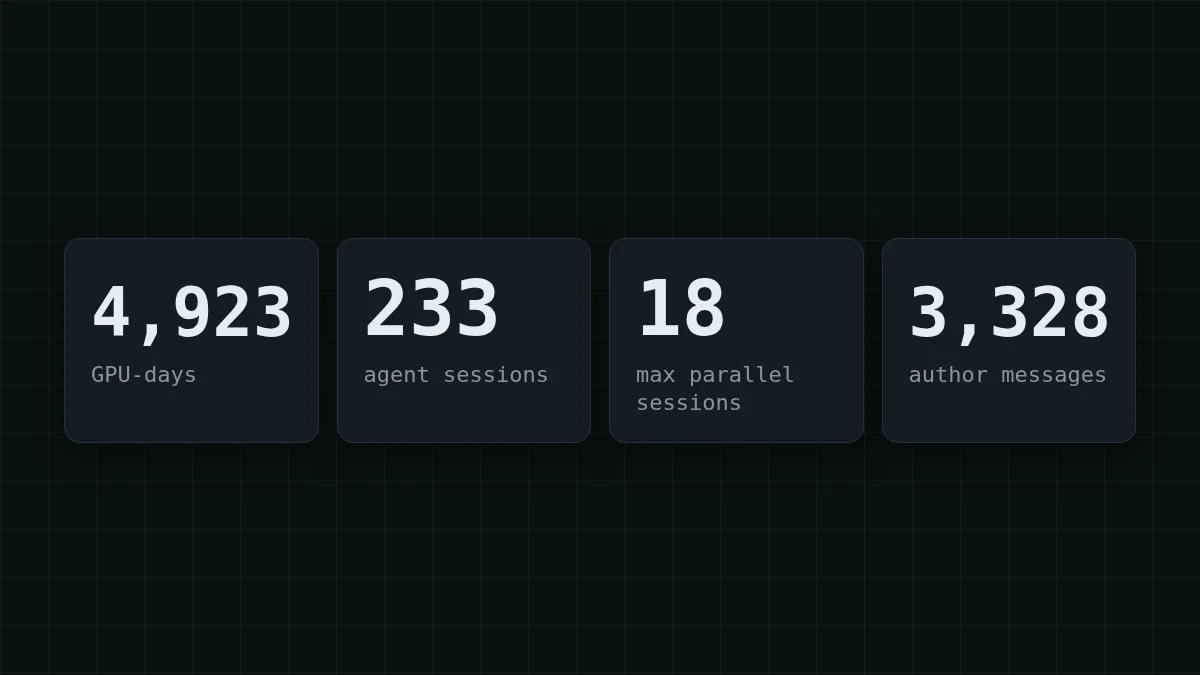
รวม 643 + 3,813 + 467 = 4,923 GPU-day ซึ่งรายงานปัดเป็น ~4,900 ที่ราคาสมมติ $3.50 ต่อ GPU-hour:
4,923 × 24 × 3.50 = 413,532
ตรงกับตัวเลข GPU $414k ในภาคผนวก ดังนั้นพาดหัวคือฮาร์ดแวร์เช่าที่รันงานคำนวณหนักหลายสัปดาห์ ไม่มี token ของโมเดลอยู่ในผลรวมนั้น
เช็กด่วน
ตัวเลข ~$400k ในรายงาน RSA-260 คืออะไร?
แสดงคำตอบ
คำตอบ: ค่าเช่า GPU ในราคาตลาดสำหรับการรันแยกตัวประกอบ
มาจาก GPU-day × $3.50 ต่อ GPU-hour รายงานไม่ได้ระบุชื่อโมเดลและไม่ได้ให้จำนวน token ของส่วนเอเจนต์
เอเจนต์ทำอะไร และรายงานไม่ได้บอกอะไร#
ฝั่งเอเจนต์อธิบายด้วยกิจกรรม ไม่ใช่ด้วยค่าใช้จ่าย พรอมป์แรกส่งออกไปเมื่อ 13 สิงหาคม 2026 งานใช้เวลาประมาณสามสัปดาห์ และตัวเลขคือ:
- 233 เซสชัน Devin สำหรับการแยกตัวประกอบ โดยเฉลี่ยรันขนานกัน 3 เซสชัน และสูงสุด 18
- 192 เซสชันได้รับข้อความจากผู้เขียน 36 เซสชันรันโดยไม่มีมนุษย์แทรกแซงเลย
- 101 เซสชันลูกถูกเริ่มโดยเซสชันอื่น
- การบัญชีของ Devin เอง: 14,450 ACU (เป็นหน่วยของ Devin ไม่ใช่ token)
เซสชันจัดการการวัด การดำเนินงานคลัสเตอร์ การปรับแต่ง และการดีบัก มนุษย์กำหนดลำดับความสำคัญและสร้าง benchmark รายละเอียดตรงไปตรงมาสองข้อจากผู้เขียน: การแยกส่วนรอบ CADO-NFS ถูกออกแบบโดยมนุษย์และเป็นสิ่งจำเป็น และเอเจนต์สับสนมากขึ้นเมื่อโค้ดเบี่ยงเบนจาก upstream มากขึ้น
สิ่งที่ขาดไปคือสิ่งที่งบประมาณต้องการพอดี: โมเดลไหน จำนวน token เท่าไร ดังนั้นอย่าพยายามย้อนหาค่า token จาก 14,450 ACU อะไรก็ตามที่คุณอ่านเจอออนไลน์ที่ทำแบบนั้นคือการเดา
บรรทัดที่สาม: การกำกับโดยมนุษย์#
ผู้เขียนส่ง 3,328 ข้อความ รวม 82,702 คำ นั่นคือ 82,702 ÷ 3,328 ≈ 25 คำต่อข้อความ เป็นการสะกิดสั้น ๆ ไม่ใช่เรียงความ คำเหล่านั้นแทบไม่มีค่า token แต่มีค่าเรื่องความสนใจ: ต้องมีคนอ่านว่าเอเจนต์ทำอะไรและตัดสินใจว่าต่อไปทำอะไร เมื่อคุณตั้งงบโปรเจกต์เอเจนต์ ให้ใส่บรรทัดนี้แยกเป็นชั่วโมง ไม่ใช่ดอลลาร์ของการใช้ API
ดังนั้นโปรเจกต์เอเจนต์ระยะยาวมีสามบรรทัด:
เลื่อนตารางไปทางขวา →
| บรรทัด | ในรายงาน RSA-260 | อะไรกำหนดมันสำหรับคุณ |
|---|---|---|
| คอมพิวต์ | เวลา GPU ~$414k ที่ราคา $3.50 ต่อ GPU-hour | งานของคุณเอง: build, test, training, simulation |
| Token ของโมเดล | ไม่ได้รายงาน | เซสชัน × สเต็ป × token ต่อสเต็ป |
| การกำกับโดยมนุษย์ | 3,328 ข้อความใน ~3 สัปดาห์ | คุณรีวิวและเปลี่ยนทิศทางบ่อยแค่ไหน |
ประมาณค่า token ของคุณ#
นี่คือสูตร และสิ่งหนึ่งที่คนมักลืม: ทุกสเต็ปส่งประวัติซ้ำใหม่ เอเจนต์ไม่จำเซสชันได้เอง แต่ละครั้งที่เรียกจะพา task ไฟล์ที่อ่าน และผลลัพธ์เครื่องมือที่ผ่านมาทั้งหมดไปด้วย นั่นคือเหตุผลที่ input token มักมากกว่า output token หลายเท่า (เพิ่มเติมใน why AI agents use so many tokens)
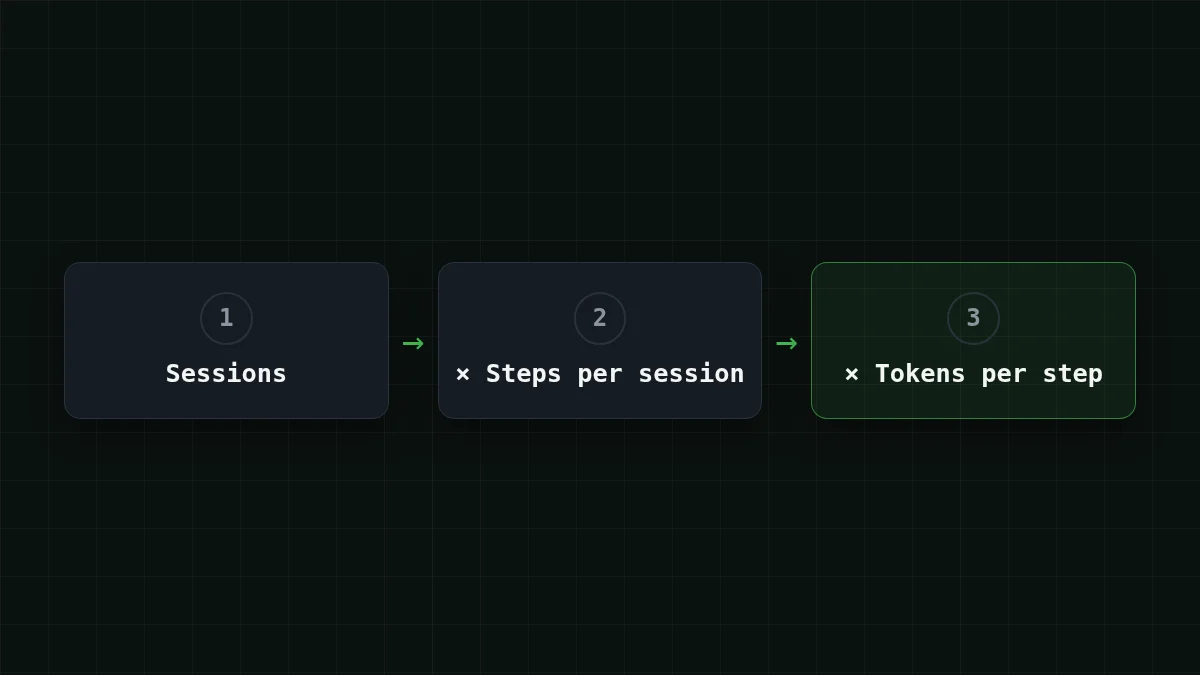
สมมติคุณวางแผนโปรเจกต์ขนาดเท่าของ Cognition คือ 233 เซสชัน และสมมติ 60 สเต็ปต่อเซสชัน สองตัวเลขนี้เป็นสมมติฐานของหน้านี้ ไม่ใช่ข้อมูลของ Cognition จากนั้น:
233 × 60 = 13,980
นั่นคือ 13,980 การเรียกโมเดล ตอนนี้ดูขนาดของการเรียกหนึ่งครั้ง สมมติสเต็ปเฉลี่ยส่ง 60,000 token เข้า (task, ประวัติ, ไฟล์หนึ่งหรือสองไฟล์) และได้ 1,500 token กลับ (คำสั่งหรือแพตช์) รวม:
60,000 × 13,980 = 838,800,000
1,500 × 13,980 = 20,970,000
ดังนั้นประมาณ 839M input token และ 21M output token input มากกว่า output สี่สิบเท่า และนั่นคือฝั่งที่งบประมาณของคุณอยู่ บน DeepSeek-V4-Flash โปรเจกต์นั้นมีค่าใช้จ่าย $14.68 และหนึ่งเซสชัน 60 สเต็ปคือ $0.063 นี่คือโหลดเดียวกันบนทุกโมเดล พร้อมราคาอ้างอิง OpenRouter เทียบข้าง ๆ:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 13,980 คำขอ | OpenRouter, 13,980 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
60,000 โทเค็นอินพุตและ 1,500 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
เมื่อนับรวมทั้งหมด ทั้ง input และ output ทุกโมเดลของเราถูกกว่า OpenRouter สำหรับโหลดนี้ ราคาเป็นแบบเรียลไทม์จาก the pricing page ดังนั้นตารางจะเปลี่ยนเมื่ออัตราเปลี่ยน
ลองด้วยตัวเองลองดู: เซสชัน 60 สเต็ปเฉลี่ยส่ง 60,000 token เข้า สเต็ป 1 ส่งมากเท่าสเต็ป 60 ไหม?แสดงคำตอบ
ไม่ สเต็ป 1 ส่งน้อย (task กับไฟล์ไม่กี่ไฟล์) สเต็ป 60 ส่งทุกอย่างที่สะสมมาระหว่างทางซ้ำ การใช้ 60,000 เป็นค่าเฉลี่ยสมมติว่าเซสชันเริ่มเล็กและจบที่ราว 100K หรือมากกว่า ถ้าคุณรู้ว่าเซสชันจบที่ เช่น 120K ค่าเฉลี่ยจะประมาณครึ่งหนึ่งของค่านั้น ดังนั้นวัดคำขอที่ใหญ่ที่สุด ไม่ใช่แค่ค่าเฉลี่ย
ได้ตัวเลขของคุณเองในสิบนาที#
สมมติฐานเป็นเพียงจุดเริ่มต้น รันเซสชันจริงหนึ่งเซสชันของงานคุณบนโมเดลราคาถูกและอ่านออบเจกต์ usage ที่ API ส่งกลับในทุกคำตอบ endpoint ที่เข้ากันได้กับ OpenAI รายงาน prompt_tokens และ completion_ ต่อการเรียก:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
รวม usage ตลอดทั้งเซสชัน หารด้วยจำนวนการเรียก แล้วแทนที่ 60,000 และ 1,500 ข้างต้นด้วยค่าเฉลี่ยของคุณ รายละเอียดการตั้งค่าอยู่ใน CheapTokens docs; การติดตามต่อสเต็ปในโค้ดอยู่ใน track AI agent token cost in Python สำหรับการคำนวณเดียวกันบนเซสชัน 50 สเต็ปเดียว ดู agent session cost on GLM, DeepSeek or MiniMax
สำหรับลูปยาว DeepSeek-V4-Flash มี context window 380K และ output สูงสุด 32,768 token ต่อคำตอบ ด้วยราคาเดียวทุกชั่วโมง GLM-5.3-Flash มี window 390K และ MiniMax-M2.7 มี 180K ดังนั้นตรวจสอบว่าคำขอที่ใหญ่ที่สุดของคุณพอดี
เลือกกรณีของคุณ
โปรเจกต์ไหนดูเหมือนของคุณ?
เลือกตัวเลือกเพื่อดูคำตอบ
เซสชันสั้นจำนวนมาก
งานเล็ก แต่ละงานเริ่มใหม่: input ต่อการเรียกต่ำ คูณเซสชันด้วยสเต็ป และคาดว่ายอดรวมจะถูกกำหนดโดยจำนวนการเรียก ไม่ใช่ขนาด
เซสชันยาวมากไม่กี่เซสชัน
ประวัติโตขึ้นตลอดเซสชัน ดังนั้นสเต็ปท้าย ๆ แพงที่สุด ประเมินด้วยคำขอที่ใหญ่ที่สุด แยกงานเป็นเซสชันลูกที่มีบรีฟสั้น ๆ แล้ว input จะไม่บานปลาย
คอมพิวต์หนักบวกเอเจนต์
เหมือน RSA-260: งานเองต้องใช้ฮาร์ดแวร์ คิดราคาฮาร์ดแวร์ต่อชั่วโมงจากผู้ให้บริการ และเก็บบรรทัด token เป็นการประมาณแยกกัน มันไม่บวกกันในหัวคุณ แต่บวกกันในสเปรดชีต
แคบงานก่อนเพิ่มงบประมาณ#
รายงานมีบทเรียนอีกข้อที่เข้ากับงบประมาณ: ยิ่งโค้ดเบี่ยงเบนจาก upstream มาก เอเจนต์ยิ่งสับสน เอเจนต์ที่สับสนใช้สเต็ปมากขึ้น ถ้าการประมาณของคุณดูสูงเกินไป ให้ลดสเต็ปต่อเซสชันก่อน: บรีฟที่ชัดขึ้น พื้นที่โค้ดที่เล็กลง ย้ายสเต็ปที่แน่นอนไปเป็นสคริปต์ (ดู do agents need the model at every step) ลดสเต็ปครึ่งหนึ่งก็ลดบรรทัด token ครึ่งหนึ่ง นั่นคือคันโยกที่ง่ายที่สุดที่คุณมี


