Pag-optimize ng gastosPagsusuri
I-budget ang mahabang agent project: compute vs tokens (RSA-260 case)
Ang $400k na RSA-260 headline ay GPU rental, hindi model tokens. Hatiin ang mahabang agent project sa tatlong budget lines at sukatin ang token part gamit ang sessions × steps × tokens.
Sa pahinang ito
Ang ~$400k na figure mula sa RSA-260 factoring ng Cognition ay GPU rental, hindi model bill. Hindi binibigyan ng presyo ng report ang agent side, kaya kung nagpaplano ka ng mahabang agent project, ikaw mismo ang mag-e-estimate ng token line: sessions × steps × tokens per step, sa live na presyo. Iyon ang ginagawa ng natitirang bahagi ng page na ito.
Ang source ay ang write-up ng Cognition ni Eric Lu, isang engineer sa Cognition (Factoring RSA-260, na-publish 9 September 2026, sinuri 6 November 2026). Muli itong ibinabahagi kasama ang dollar figure sa headline, at madaling mabasa nang mali ang figure.
Ano talaga ang binabayaran ng $400k#
In-factor ng author ang isang 260-digit na numero gamit ang GNFS, gamit ang isang matinding binagong CADO-NFS na tumatakbo sa GPUs. Ibinibigay ng report ang GPU time para sa bawat phase:
- polynomial selection: 643 GPU-days
- sieving: 3,813 GPU-days
- linear system solving: 467 GPU-days
Iyon ay 643 + 3,813 + 467 = 4,923 GPU-days, na ini-round ng report sa ~4,900. Sa inaasahang $3.50 per GPU-hour ng report:
4,923 × 24 × 3.50 = 413,532
Tumutugma iyon sa $414k GPU figure sa appendix nito. Kaya ang headline ay rentadong hardware na nagpapatakbo ng number-crunching job nang ilang linggo. Walang model tokens sa sum na iyon.
Mabilisang pagsusuri
Ano ang ~$400k na figure sa RSA-260 report?
Ipakita ang sagot
Sagot: Market-rate rental ng GPUs para sa factoring run
Galing ito sa GPU-days × $3.50 per GPU-hour. Walang pinangalanang models ang report at walang token counts para sa agent part.
Ano ang ginawa ng agents, at ano ang hindi sinasabi ng report#
Ang agent side ay inilalarawan sa pamamagitan ng activity, hindi ng cost. Ang unang prompt ay ipinadala noong 13 August 2026, tumagal ang trabaho ng mga tatlong linggo, at ang mga numero ay:
- 233 Devin sessions para sa factoring, sa average 3 ang tumatakbo nang parallel at 18 sa peak
- 192 sa kanila ay nakatanggap ng messages mula sa author, 36 ang tumakbo nang walang human intervention
- 101 child sessions ang sinimulan ng ibang sessions
- Sariling accounting ng Devin: 14,450 ACUs (iyon ang unit ng Devin, hindi tokens)
Hinawakan ng sessions ang measurement, cluster operations, tuning at debugging. Ang tao ang nagtakda ng priorities at gumawa ng benchmarks. Dalawang tapat na detalye mula sa author: ang decomposition sa paligid ng CADO-NFS ay dinisenyo ng isang tao at essential ito, at lalong nalito ang agents habang lumalayo ang code sa upstream.
Ang kulang ay eksaktong kailangan ng budget: aling models, ilang tokens. Kaya huwag subukang i-back out ang token bill mula sa 14,450 ACUs. Anumang mabasa mo online na gumagawa nito ay hula lang.
Ang ikatlong line: human steering#
Nagpadala ang author ng 3,328 messages, 82,702 words sa kabuuan. Iyon ay 82,702 ÷ 3,328 ≈ 25 words per message, maiikling nudges kaysa essays. Halos walang gastos ang mga salitang iyon sa tokens. Ang gastos ay attention: may kailangang magbasa ng ginawa ng agents at magdesisyon kung ano ang susunod. Kapag nagba-budget ka ng agent project, ilagay iyon sa sarili nitong line sa oras, hindi sa dollars ng API usage.
Kaya may tatlong line ang isang mahabang agent project:
I-scroll ang table pakanan →
| Line | Sa RSA-260 report | Ano ang nagtatakda nito para sa iyo |
|---|---|---|
| Compute | ~$414k ng GPU time, priced at $3.50 per GPU-hour | Ang job mo mismo: builds, tests, training, simulations |
| Model tokens | Hindi ini-report | Sessions × steps × tokens per step |
| Human steering | 3,328 messages sa loob ng ~3 linggo | Gaano kadalas ka nagre-review at nagre-redirect |
I-estimate ang token line mo#
Narito ang formula, at ang isang bagay na nakakalimutan ng mga tao: bawat step ay muling nagpapadala ng history. Hindi nakaalala ang agent ng isang session; dala ng bawat call ang task, ang mga file na nabasa nito at ang tool output hanggang ngayon. Kaya kadalasan mas malaki nang todo ang input tokens kaysa output tokens (higit pa diyan sa why AI agents use so many tokens).
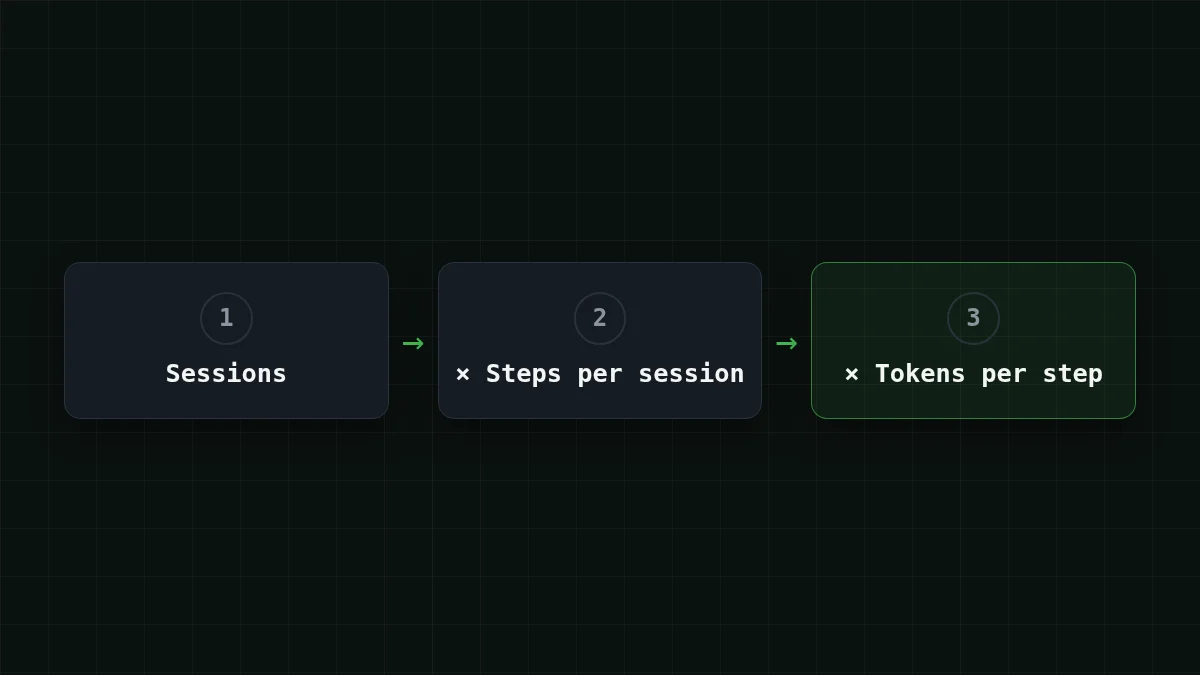
Sabihin nating nagpaplano ka ng project na kasinglaki ng sa Cognition, 233 sessions, at ipagpalagay mong 60 steps per session. Ang dalawang numerong ito ay assumptions ng page na ito, hindi Cognition data. Kung gayon:
233 × 60 = 13,980
iyon ay 13,980 model calls. Ngayon ang laki ng isang call. Ipagpalagay na ang average na step ay nagpapadala ng 60,000 tokens in (task, history, isa o dalawang file) at nakakakuha ng 1,500 tokens back (isang command o patch). Mga total:
60,000 × 13,980 = 838,800,000
1,500 × 13,980 = 20,970,000
Kaya mga 839M input tokens at 21M output tokens. Apatnapung beses ang input kaysa output, at doon nakatira ang budget mo. Sa DeepSeek-V4-Flash, ang project na iyon ay nagkakahalaga ng $14.68, at ang isang session na 60 steps ay $0.063. Narito ang parehong load sa bawat model, kasama ang OpenRouter reference sa tabi nito:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 13,980 mga kahilingan | OpenRouter, 13,980 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
60,000 input at 1,500 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Kung bibilangin sa total, kasama ang input at output, mas mura ang bawat isa sa aming models kaysa OpenRouter para sa load na ito. Live ang prices mula sa the pricing page, kaya gumagalaw ang table kapag nagbago ang tariffs.
Subukan mo mismoSubukan: ang 60-step session ay may average na 60,000 tokens in. Nagpapadala ba ang step 1 ng kasing dami ng step 60?Ipakita ang sagot
Hindi. Kaunti lang ang ipinapadala ng step 1 (ang task at ilang file), muling ipinapadala ng step 60 ang lahat ng naipon sa daan. Ang pagkuha ng 60,000 bilang average ay nagpapalagay na maliit ang simula ng session at nagtatapos malapit sa 100K o higit pa. Kung alam mong nagtatapos ang sessions mo sa, sabihin nating, 120K, ang average ay mga kalahati niyon, kaya sukatin ang pinakamalaking request, hindi lang ang average.
Kunin ang sarili mong numero sa sampung minuto#
Starting point lang ang assumptions. Magpatakbo ng isang tunay na session ng task mo sa murang model at basahin ang usage object na ibinabalik ng API sa bawat response. Nagre-report ang OpenAI-compatible endpoints ng prompt_tokens at completion_ per call:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
I-sum ang usage sa buong session, hatiin sa bilang ng calls, at palitan ang 60,000 at 1,500 sa itaas ng iyong averages. Nasa CheapTokens docs ang setup details; nasa track AI agent token cost in Python ang per-step tracking sa code. Para sa parehong arithmetic sa isang 50-step session, tingnan ang agent session cost on GLM, DeepSeek or MiniMax.
Para sa mahabang loops, may 380K context window ang DeepSeek-V4-Flash at hanggang 32,768 output tokens per answer, na may isang presyo sa kahit anong oras. May 390K window ang GLM-5.3-Flash at 180K ang MiniMax-M2.7, kaya tiyakin na kasya ang pinakamalaking request mo.
Piliin ang iyong kaso
Aling project ang kamukha ng sa iyo?
Pumili ng opsyon upang makita ang sagot
Maraming maiikling session
Maliliit na task, bawat isa ay nagsisimula nang bago: nananatiling mababa ang input per call. I-multiply ang sessions sa steps, at asahan na ang total ay dominado ng bilang ng calls, hindi ng laki nila.
Ilang napakahabang session
Lumalaki ang history sa buong session, kaya ang huling steps ang magastos. I-estimate gamit ang pinakamalaking request, hatiin ang trabaho sa child sessions na may maiikling brief bawat isa, at titigil ang pag-snowball ng input.
Mabigat na compute kasama ang agents
Tulad ng RSA-260: kailangan ng hardware ng job mismo. I-price ang hardware per hour mula sa provider mo, at panatilihing hiwalay na estimate ang token line. Hindi sila nagdadagdag sa isip mo, sa spreadsheet lang.
Paliitin ang task bago taasan ang budget#
May isa pang aral ang report na bagay sa budget: habang lumalayo ang code sa upstream, lalong nalito ang agents. Mas maraming steps ang kinukuha ng nalilitong agents. Kung masyadong mataas ang estimate mo, bawasan muna ang steps per session: mas malinaw na brief, mas maliit na bahagi ng code, ilipat ang fixed steps sa scripts (tingnan ang do agents need the model at every step). Ang paghati sa steps ay naghahati sa token line; iyon ang pinakamadaling lever mo.


