Maliyet optimizasyonuAnaliz
Uzun bir ajan projesini bütçeleyin: hesaplama vs token'lar (RSA-260 örneği)
$400k'lık RSA-260 başlığı GPU kiralamasıdır, model token'ı değil. Uzun bir ajan projesini üç bütçe satırına ayırın ve token kısmını oturumlar × adımlar × token'lar ile boyutlandırın.
Bu sayfada
Cognition'ın RSA-260 çarpanlarına ayırma işlemindeki ~$400k rakamı GPU kiralama bedelidir, model faturası değil. Rapor, ajan tarafını hiç fiyatlandırmıyor; dolayısıyla uzun bir ajan projesi planlıyorsanız token satırını kendiniz tahmin edersiniz: oturumlar × adımlar × adım başına token, güncel fiyatlarla. Bu sayfanın geri kalanı da tam olarak bunu yapıyor.
Kaynak, Cognition'da mühendis olan Eric Lu'nun yazısı (Factoring RSA-260, 9 Eylül 2026'da yayımlandı, 6 Kasım 2026'da kontrol edildi). Başlıktaki dolar rakamıyla yeniden paylaşılıyor ve bu rakam kolayca yanlış okunabiliyor.
$400k aslında neyin karşılığı#
Yazar, GPU'larda çalışan yoğun biçimde değiştirilmiş bir CADO-NFS kullanarak GNFS ile 260 basamaklı bir sayıyı çarpanlarına ayırdı. Rapor her aşama için GPU süresini veriyor:
- polinom seçimi: 643 GPU-günü
- eleme: 3.813 GPU-günü
- doğrusal denklem sistemi çözümü: 467 GPU-günü
Bu, 643 + 3.813 + 467 = 4.923 GPU-günü eder; rapor bunu ~4.900'e yuvarlıyor. Raporun varsaydığı GPU-saati başına $3.50 ile:
4.923 × 24 × 3.50 = 413.532
Bu, ekteki $414k GPU rakamıyla örtüşüyor. Yani başlıktaki rakam, haftalarca sayı kırma işi çalıştıran kiralık donanım. Bu toplamın içinde hiç model token'ı yok.
Hızlı kontrol
RSA-260 raporundaki ~$400k rakamı nedir?
Cevabı göster
Cevap: Çarpanlarına ayırma işi için piyasa fiyatından GPU kiralama
Rakam, GPU-günü × GPU-saati başına $3.50'den geliyor. Rapor hiçbir model adı vermiyor ve ajan kısmı için token sayısı sunmuyor.
Ajanlar ne yaptı ve rapor ne söylemiyor#
Ajan tarafı maliyetle değil, etkinlikle anlatılıyor. İlk istem 13 Ağustos 2026'da gönderildi, iş yaklaşık üç hafta sürdü ve rakamlar şöyle:
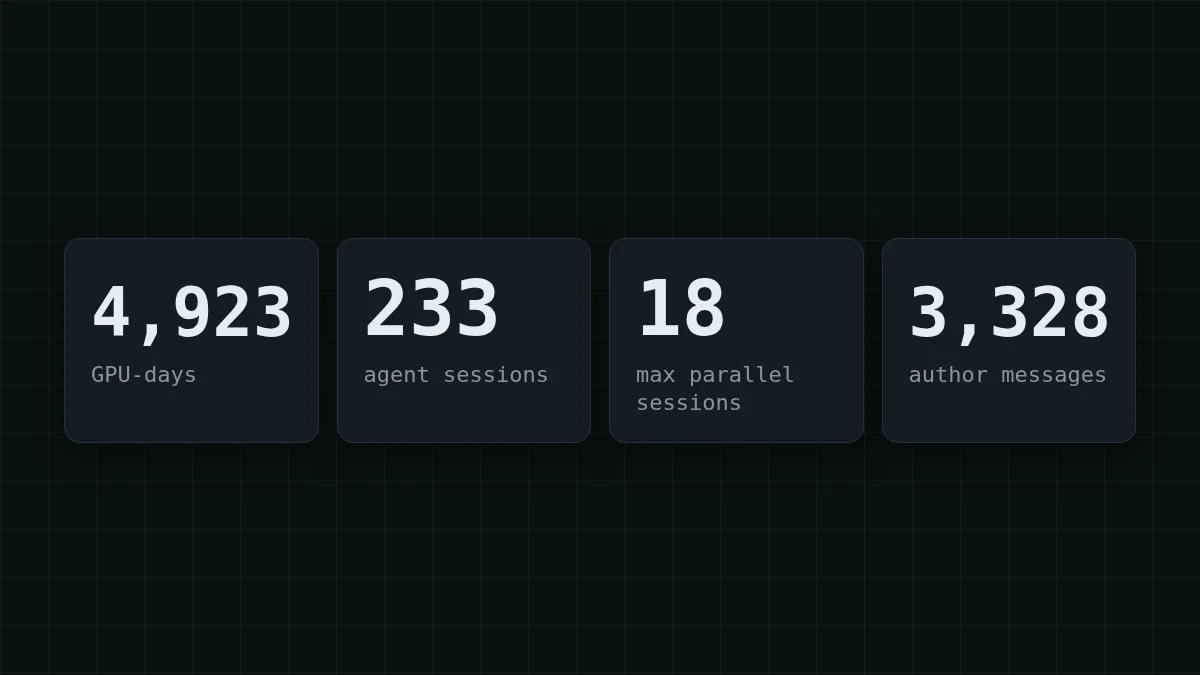
- Çarpanlarına ayırma için 233 Devin oturumu, ortalama 3'ü paralel çalıştı, zirvede 18
- Bunlardan 192'si yazardan mesaj aldı, 36'sı hiç insan müdahalesi olmadan çalıştı
- 101 alt oturum başka oturumlar tarafından başlatıldı
- Devin'in kendi muhasebesi: 14.450 ACU (bu Devin'in birimi, token değil)
Oturumlar ölçüm, küme operasyonları, ayarlama ve hata ayıklama işlerini yürüttü. İnsan öncelikleri belirledi ve kıyaslamaları kurdu. Yazarın iki dürüst detayı: CADO-NFS etrafındaki ayrıştırma bir insan tarafından tasarlandı ve hayati önemdeydi; ajanlar ise kod upstream'den uzaklaştıkça daha çok kafası karıştı.
Eksik olan tam da bir bütçenin ihtiyaç duyduğu şey: hangi modeller, kaç token. Dolayısıyla 14.450 ACU'dan token faturası çıkarmaya çalışmayın. İnternette bunu yapan ne varsa tahmindir.
Üçüncü satır: insan yönlendirmesi#
Yazar 3.328 mesaj gönderdi, toplam 82.702 kelime. Bu, mesaj başına 82.702 ÷ 3.328 ≈ 25 kelime eder; denemeler değil, kısa dürtmeler. Bu kelimeler token olarak neredeyse hiçbir şeye mal olmuyor. Maliyeti dikkat: birinin ajanların ne yaptığını okuyup sırada ne olduğuna karar vermesi gerekiyor. Bir ajan projesini bütçelerken bunu API kullanımının doları olarak değil, saat olarak ayrı bir satıra koyun.
Yani uzun bir ajan projesinin üç satırı var:
Tabloyu sağa kaydırın →
| Satır | RSA-260 raporunda | Sizde neyin belirlediği |
|---|---|---|
| Hesaplama | GPU-saati başına $3.50'den ~$414k GPU süresi | İşinizin kendisi: derlemeler, testler, eğitim, simülasyonlar |
| Model token'ları | Raporlanmıyor | Oturumlar × adımlar × adım başına token |
| İnsan yönlendirmesi | ~3 haftada 3.328 mesaj | Ne sıklıkla gözden geçirip yönlendirdiğiniz |
Token satırınızı tahmin edin#
İşte formül ve insanların unuttuğu tek şey: her adım geçmişi yeniden gönderir. Bir ajan oturumu hatırlamaz; her çağrı görevi, okuduğu dosyaları ve o ana kadarki araç çıktısını taşır. Bu yüzden giriş token'ları genellikle çıkış token'larını gölgede bırakır (bunun ayrıntısı AI ajanları neden bu kadar çok token kullanır yazısında).
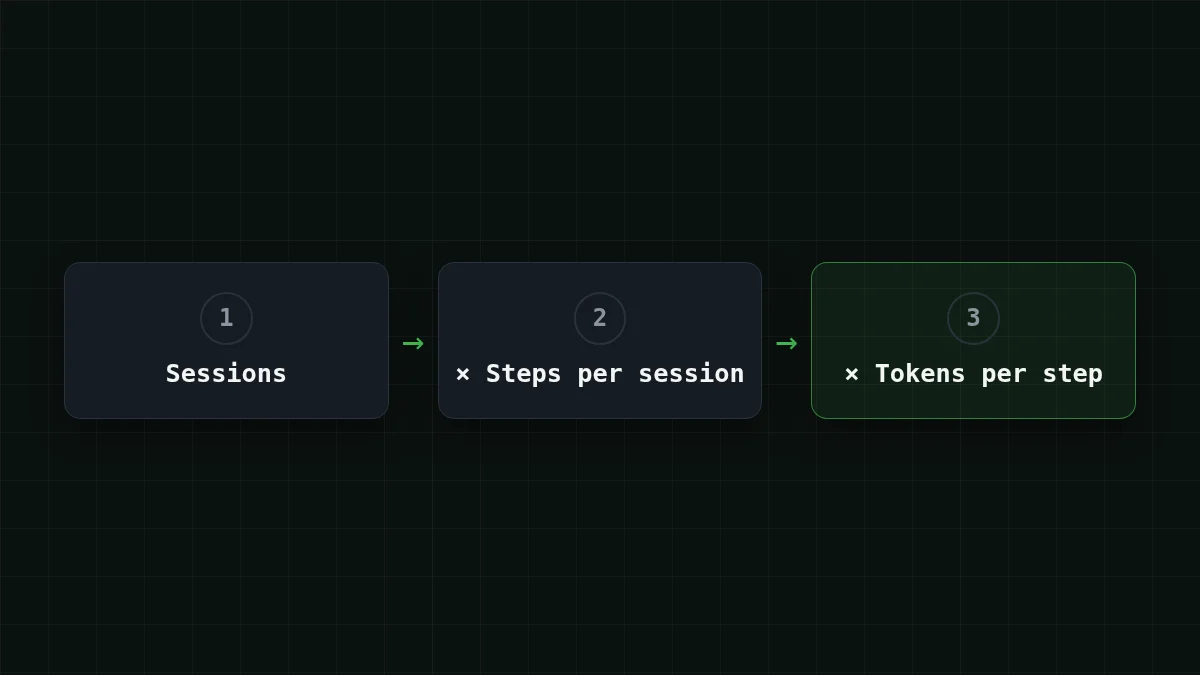
Diyelim ki Cognition'ınki boyutunda bir proje planlıyorsunuz, 233 oturum, ve oturum başına 60 adım varsayıyorsunuz. Bu iki sayı bu sayfanın varsayımları, Cognition verisi değil. O zaman:
233 × 60 = 13.980
yani 13.980 model çağrısı. Şimdi tek bir çağrının boyutu. Diyelim ki ortalama bir adım 60.000 token giriş gönderiyor (görev, geçmiş, bir iki dosya) ve 1.500 token geri alıyor (bir komut ya da bir yama). Toplamlar:
60.000 × 13.980 = 838.800.000
1.500 × 13.980 = 20.970.000
Yani yaklaşık 839M giriş token'ı ve 21M çıkış token'ı. Giriş, çıkışın kırk katı ve bütçenizin yaşadığı taraf da burası. DeepSeek-V4-Flash'te bu proje $14.68 tutuyor, 60 adımlık bir oturum ise $0.063. İşte aynı yük her modelde, yanında OpenRouter referansıyla:
| Model | Giriş $/1M | Çıkış $/1M | İstek başına | 13.980 istek | OpenRouter, 13.980 istek |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
İstek başına 60.000 giriş ve 1.500 çıkış token'ı. 1M token başına fiyatlar günceldir ve tarifelerimizle birlikte değişir; OpenRouter sütunu aynı iş yükü için referans fiyatları gösterir.
Giriş ve çıkış birlikte toplam olarak sayıldığında, bu yük için modellerimizin her biri OpenRouter'dan daha ucuza geliyor. Fiyatlar fiyatlandırma sayfasından canlı geliyor, yani tarifeler değişince tablo da değişiyor.
Kendin deneDeneyin: 60 adımlık oturum ortalama 60.000 token giriş yapıyor. 1. adım 60. adım kadar mı gönderiyor?Cevabı göster
Hayır. 1. adım az gönderir (görev ve birkaç dosya), 60. adım ise yol boyunca toplanan her şeyi yeniden gönderir. 60.000'i ortalama almak, oturumun küçük başlayıp 100K ya da daha fazlasına yakın bittiğini varsayar. Oturumlarınızın örneğin 120K'da bittiğini biliyorsanız ortalama bunun yaklaşık yarısıdır; o yüzden yalnızca ortalamayı değil, en büyük isteği de ölçün.
Kendi rakamlarınızı on dakikada alın#
Varsayımlar yalnızca bir başlangıç noktasıdır. Görevinizin gerçek bir oturumunu ucuz bir modelde çalıştırın ve API'nin her yanıtta döndürdüğü usage nesnesini okuyun. OpenAI uyumlu uç noktalar çağrı başına prompt_tokens ve completion_ bildirir:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
usage değerini tüm oturum boyunca toplayın, çağrı sayısına bölün ve yukarıdaki 60.000 ile 1.500'ü kendi ortalamalarınızla değiştirin. Kurulum ayrıntıları CheapTokens dokümanlarında; kodda adım başına izleme Python'da AI ajan token maliyetini izle yazısında. Tek bir 50 adımlık oturumda aynı aritmetik için GLM, DeepSeek veya MiniMax'te ajan oturumu maliyeti yazısına bakın.
Uzun döngüler için DeepSeek-V4-Flash 380K bağlam penceresine ve yanıt başına en fazla 32.768 çıkış token'ına sahip, her saatte tek fiyatla. GLM-5.3-Flash 390K pencereye, MiniMax-M2.7 ise 180K'ya sahip; en büyük isteğinizin sığdığını kontrol edin.
Durumunu seç
Hangi proje sizinkine benziyor?
Cevabı görmek için bir seçenek seçin
Çok sayıda kısa oturum
Küçük görevler, her biri sıfırdan başlıyor: çağrı başına giriş düşük kalır. Oturumları adımlarla çarpın ve toplamın çağrıların boyutundan değil sayısından belirleneceğini bekleyin.
Birkaç çok uzun oturum
Geçmiş oturum boyunca büyür, yani son adımlar pahalı olanlardır. En büyük istekle tahmin yapın, işi her birine kısa bir özet verilen alt oturumlara bölün; giriş kartopu gibi büyümeyi bırakır.
Yoğun hesaplama artı ajanlar
RSA-260 gibi: işin kendisi donanım gerektirir. Donanımı sağlayıcınızdan saat başına fiyatlandırın ve token satırını ayrı bir tahmin olarak tutun. Bunlar kafanızda değil, yalnızca bir elektronik tabloda toplanır.
Bütçeyi artırmadan önce görevi daraltın#
Raporun bütçeye uyan bir dersi daha var: kod upstream'den uzaklaştıkça ajanlar daha çok kafası karıştı. Kafası karışan ajanlar daha çok adım atar. Tahmininiz çok yüksek görünüyorsa önce oturum başına adımları küçültün: daha net bir özet, daha küçük bir kod alanı, betiklere taşınmış sabit adımlar (ajanlar her adımda modele ihtiyaç duyar mı yazısına bakın). Adımları yarıya indirmek token satırını yarıya indirir; elinizdeki en kolay kaldıraç budur.


