Оптимизация расходовРазбор
Бюджет долгого проекта с агентами: вычисления и токены (RSA-260)
Цифра в $400k за RSA-260 — это аренда GPU, а не токены модели. Разделите проект с агентами на три статьи расходов и оцените токены по формуле «сессии × шаги × токены».
Содержание
Цифра ~$400k из истории Cognition про разложение RSA-260 — это аренда GPU, а не счёт за модель. Расходы на агентов в отчёте не посчитаны вовсе, поэтому статью про токены в бюджете долгого проекта вы оцениваете сами: сессии × шаги × токены на шаг, по живым ценам. Дальше именно это и сделаем.
Источник — отчёт Эрика Лу, инженера Cognition (Factoring RSA-260, опубликован 9 сентября 2026, проверено 6 ноября 2026). Его сейчас пересказывают с долларовой цифрой в заголовке, и прочитать её легко неправильно.
За что на самом деле заплатили $400k#
Автор разложил 260-значное число методом GNFS на сильно доработанном CADO-NFS, который считает на GPU. Время GPU по этапам:
- подбор полинома: 643 GPU-дня
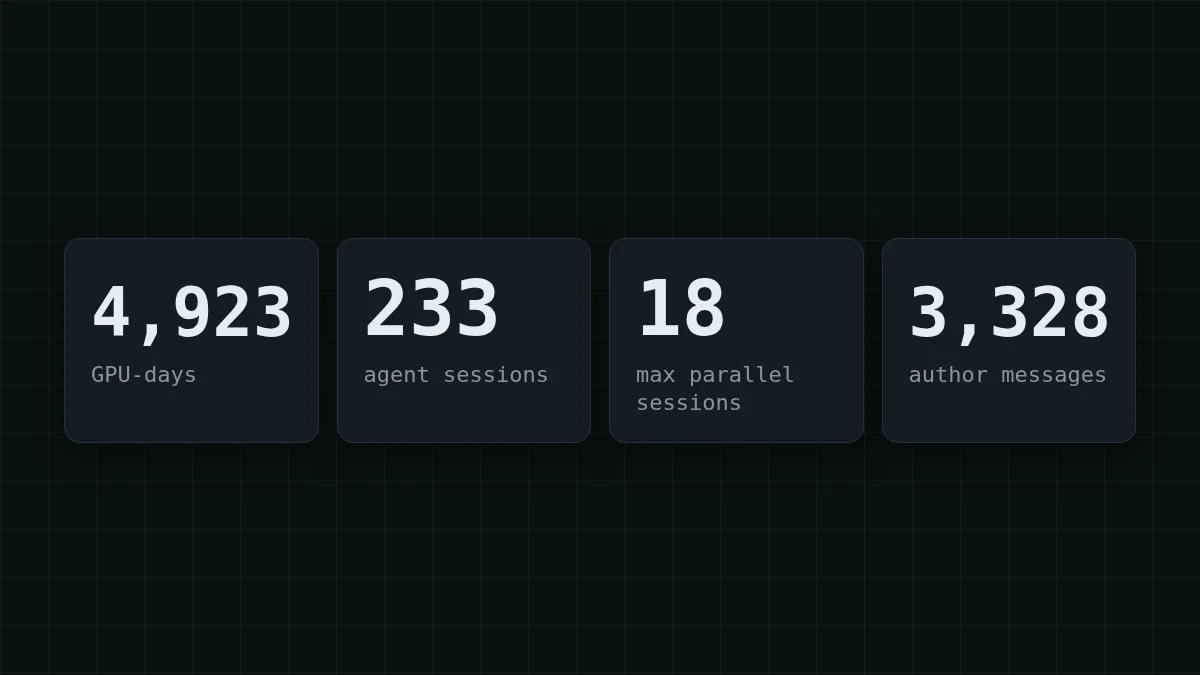
- просеивание: 3 813 GPU-дней
- решение линейной системы: 467 GPU-дней
Итого 643 + 3 813 + 467 = 4 923 GPU-дня, в отчёте округлено до ~4 900. По принятым там $3,50 за GPU-час:
4 923 × 24 × 3,50 = 413 532
Это совпадает с $414k за GPU в приложении к отчёту. Значит, заголовок — арендованное железо, которое несколько недель перемалывало числа. Токенов модели в этой сумме нет.
Быстрая проверка
Что за цифра ~$400k в отчёте про RSA-260?
Показать ответ
Ответ: Аренда GPU по рыночной цене на время разложения
Она получена как GPU-дни × $3,50 за GPU-час. Модели в отчёте не названы, число токенов агентов не приведено.
Что делали агенты и о чём отчёт молчит#
Агентская часть описана действиями, а не стоимостью. Первый промпт ушёл 13 августа 2026, работа заняла около трёх недель, а числа такие:
- 233 сессии Devin на разложение: в среднем 3 параллельно, в пике 18
- в 192 из них автор писал сообщения, 36 прошли вообще без вмешательства человека
- 101 дочернюю сессию запустили сами сессии
- собственный учёт Devin: 14 450 ACU (это единица Devin, не токены)
Сессии занимались замерами, работой с кластером, настройкой и отладкой. Человек расставлял приоритеты и писал бенчмарки. Две честные оговорки автора: разбиение задачи вокруг CADO-NFS придумал человек, и оно было критично; а чем дальше код уходил от оригинального CADO-NFS, тем больше агенты путались.
Не хватает как раз того, что нужно для бюджета: какие модели и сколько токенов. Поэтому не пытайтесь вывести счёт за токены из 14 450 ACU. Любая такая цифра в интернете — догадка.
Третья статья: ручное управление#
Автор отправил 3 328 сообщений, всего 82 702 слова. Это 82 702 ÷ 3 328 ≈ 25 слов на сообщение: короткие подталкивания, а не сочинения. В токенах эти слова почти ничего не стоят. Они стоят внимания: кто-то должен читать, что сделали агенты, и решать, что дальше. В бюджете проекта это отдельная строка в часах, а не в долларах за API.
Итого у долгого проекта с агентами три строки:
Прокрутите таблицу вправо →
| Строка | В отчёте про RSA-260 | Что определяет её у вас |
|---|---|---|
| Вычисления | ~$414k за время GPU, по $3,50 за GPU-час | Сама задача: сборки, тесты, обучение, расчёты |
| Токены модели | Не приведены | Сессии × шаги × токены на шаг |
| Ручное управление | 3 328 сообщений за ~3 недели | Как часто вы проверяете и меняете курс |
Оцените строку с токенами#
Вот формула и то, что чаще всего забывают: на каждом шаге история отправляется заново. У агента нет памяти между вызовами: в каждом запросе едут задача, прочитанные файлы и весь вывод инструментов. Поэтому входных токенов обычно намного больше, чем выходных (подробнее — в статье почему ИИ-агенты тратят так много токенов).
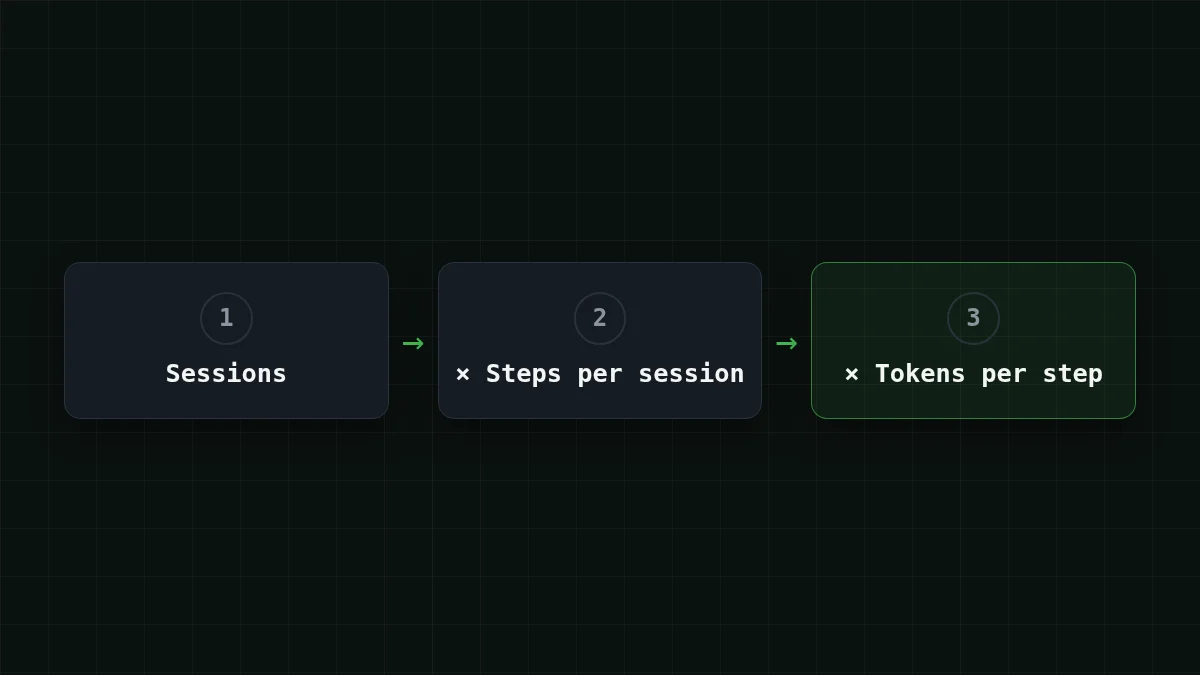
Допустим, вы планируете проект масштаба Cognition — 233 сессии — и закладываете 60 шагов на сессию. Оба числа — допущения этой страницы, а не данные Cognition. Тогда:
233 × 60 = 13 980
то есть 13 980 обращений к модели. Теперь размер одного обращения. Пусть средний шаг отправляет 60 000 токенов на входе (задача, история, пара файлов) и получает 1 500 токенов на выходе (команда или патч). Всего:
60 000 × 13 980 = 838 800 000
1 500 × 13 980 = 20 970 000
Получается около 839 млн входных токенов и 21 млн выходных. Вход больше выхода в сорок раз, и именно на этой стороне живёт ваш бюджет. На DeepSeek-V4-Flash такой проект стоит $14.68, а одна сессия в 60 шагов — $0.063. Та же нагрузка на всех моделях, с эталоном OpenRouter рядом:
| Модель | Вход $/1M | Выход $/1M | За запрос | 13 980 запросов | OpenRouter, 13 980 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0013 | $17.61 | $29.84 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0011 | $14.68 | $61.65 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $45.09 | $541.03 |
60 000 входных и 1 500 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
В сумме, с учётом входа и выхода, каждая из наших моделей на этой нагрузке дешевле OpenRouter. Цены живые, из страницы цен, так что таблица сама меняется вместе с тарифами.
Попробуйте самиПопробуйте: сессия из 60 шагов в среднем шлёт 60 000 токенов. Столько же отправляет шаг 1 и шаг 60?Показать ответ
Нет. Шаг 1 шлёт немного (задачу и пару файлов), шаг 60 заново отправляет всё, что набралось по дороге. Среднее 60 000 предполагает, что сессия начинается с малого и заканчивается около 100K и больше. Если ваши сессии заканчиваются, скажем, на 120K, среднее будет примерно вдвое меньше, поэтому измеряйте самый большой запрос, а не только среднее.
Свои числа за десять минут#
Допущения — только отправная точка. Прогоните одну настоящую сессию вашей задачи на дешёвой модели и посмотрите объект usage, который API возвращает в каждом ответе. OpenAI-совместимые эндпоинты отдают prompt_tokens и completion_ на каждый вызов:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "max_tokens": 1500, "messages": [{"role": "user", "content": "Summarize this test failure and propose a fix: ..."}]}'
Сложите usage за всю сессию, поделите на число вызовов и подставьте свои средние вместо 60 000 и 1 500. Настройка — в документации CheapTokens; учёт по шагам в коде — в статье как считать токены и стоимость агента на Python. Та же арифметика для одной сессии из 50 шагов — в разборе стоимость сессии агента на GLM, DeepSeek и MiniMax.
Для длинных циклов у DeepSeek-V4-Flash окно контекста 380K и до 32 768 токенов в одном ответе, цена одна в любое время суток. У GLM-5.3-Flash окно 390K, у MiniMax-M2.7 — 180K, так что проверьте, что ваш самый большой запрос помещается.
Выберите свой случай
На какой проект похож ваш?
Выберите вариант, чтобы увидеть ответ
Много коротких сессий
Мелкие задачи, каждая начинается с нуля: вход на вызов остаётся небольшим. Умножайте сессии на шаги, и итог будет определяться числом вызовов, а не их размером.
Несколько очень длинных сессий
История растёт по ходу сессии, поэтому дороже всего последние шаги. Оценивайте по самому большому запросу, делите работу на дочерние сессии с коротким заданием в каждой, и вход перестаёт обрастать снежным комом.
Тяжёлые вычисления плюс агенты
Как в RSA-260: сама задача требует железа. Считайте железо по часам у вашего провайдера, а строку с токенами оценивайте отдельно. В голове они не складываются, только в таблице.
Сузьте задачу, прежде чем увеличивать бюджет#
У отчёта есть ещё один урок для бюджета: чем дальше код уходил от оригинала, тем больше агенты путались. Запутавшийся агент делает больше шагов. Если оценка вышла слишком высокой, сначала уменьшайте число шагов на сессию: яснее задание, меньше кода в поле зрения, фиксированные шаги вынесены в скрипты (см. нужна ли модель на каждом шаге агента). Вдвое меньше шагов — вдвое меньше строка с токенами; это самый доступный рычаг.


