¿Necesitan los agentes el modelo en cada paso? Pon los pasos fijos en código
Por qué cada resultado de herramienta dispara otra llamada al modelo, qué pasos del agente pueden ser código simple, y cuánto cuesta un bucle de 3 pasos con y sin la llamada extra.
En esta página
Tu agente estuvo ejecutándose diez minutos y la factura es mayor que la tarea. Muy a menudo la razón es aburrida: después de cada resultado de herramienta, el harness vuelve a llamar al modelo, incluso cuando el siguiente paso era obvio.
Así que no, un agente no necesita el modelo en cada paso. Lo necesita donde hay que decidir algo. Un paso que siempre es igual, como ejecutar las pruebas después de una compilación que pasó, puede ser una regla simple en tu código.
Hay una razón económica para preocuparse. Cada llamada extra vuelve a leer todo el contexto como tokens de entrada (el artículo sobre chats largos explica por qué), así que una llamada omitida ahorra más que su propia respuesta corta. Si el bucle es nuevo para ti, empieza por cómo funciona un agente de IA y vuelve después.
Por qué un resultado de herramienta significa una llamada más al modelo#
El modelo nunca ejecuta nada. Escribe "por favor ejecuta make build", tu harness (el programa que rodea al modelo) lo ejecuta, pega la salida en la conversación y vuelve a llamar al modelo con todo lo anterior. Ese es todo el bucle. El modelo solo se entera de lo que devolvió una herramienta cuando lo llamas.
Piensa en un colega nuevo que llama al gerente después de cada paso para preguntar "¿y ahora?", aunque la lista de tareas diga "después de compilar, ejecuta las pruebas". El gerente responde lo mismo cada vez, y cada llamada cuesta un minuto de leer toda la historia desde el principio.
Así se ve en un log de agente. Digamos que la tarea es "arreglar la prueba que falla":
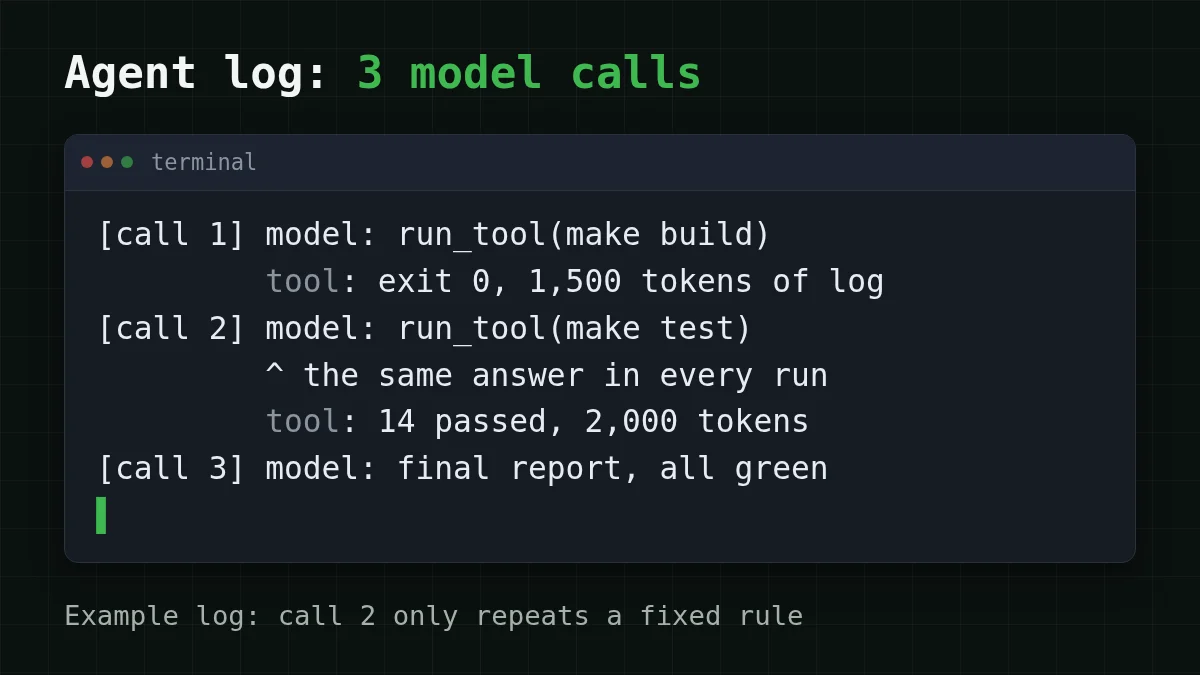
La llamada 2 es la interesante. La compilación pasó, el siguiente paso siempre son las pruebas, y el modelo se gasta una lectura completa del contexto para decir "ejecuta las pruebas". La llamada 1 y la llamada 3 son distintas: la llamada 1 elige cómo empezar, la llamada 3 lee los resultados de las pruebas y escribe el informe. Eso es trabajo real.
Qué pasos necesitan una decisión y cuáles son fijos#
Tres preguntas clasifican la mayoría de los pasos:
- ¿La siguiente acción la decide una señal clara, como un código de salida, un estado HTTP o "encontrado / no encontrado"?
- ¿Es la misma acción cada vez que aparece esa señal?
- ¿Es barato deshacer una suposición equivocada?
Tres síes: escríbelo como regla. Si no, el modelo se queda con el paso.
Un segundo ejemplo, fuera de la programación. Digamos que ejecutas un script de soporte: un cliente escribe, el script busca el pedido y luego responde. Buscar el pedido por su número es código. Rellenar "Tu pedido {id} está {status}" desde una plantilla también es código. Leer "llegó roto, ¿y ahora qué?" y elegir entre un reembolso, un reemplazo y una disculpa es un juicio, así que eso es una llamada al modelo, no tres.
Emparejar los pares
¿Quién debería encargarse de cada paso?
Toca un elemento de la izquierda, luego su par
- La compilación terminó con código de salida 0, y el siguiente paso siempre son las pruebasCódigo: el siguiente paso es fijo
- Las pruebas fallaron con un stack trace; ¿qué archivo necesita el cambio?Modelo: un juicio nuevo
- Pedido encontrado por número, ahora pon su estado en la plantilla de respuestaCódigo: rellenar la plantilla
- El cliente escribe "llegó roto, ¿y ahora qué?"Modelo: leer texto libre
Una salvaguarda hace esto seguro: la regla cubre solo el camino feliz. ¿La compilación falló con código de salida 1? ¿Pruebas en rojo? ¿Una herramienta devolvió algo que la regla no esperaba? Devuelve el control al modelo, exactamente como antes. Estás eliminando llamadas que solo tenían una respuesta posible, no sacando al modelo del bucle.
Un bucle de 3 pasos, con y sin la llamada extra#
Pongamos números al log de "arreglar la prueba que falla". Los supuestos, todos nuestros y fáciles de cambiar por los tuyos:
- prompt de sistema más tarea: 3.000 tokens
- log de compilación: 1.500 tokens; log de pruebas: 2.000 tokens
- una respuesta que solo pide una herramienta: 60 tokens; el informe final: 300 tokens
Adivina el número
Si la ejecución de pruebas pasa a código, ¿cuántas llamadas al modelo hace el bucle?
Tu respuesta
06
Mostrar respuesta
Respuesta: 2
Dos: una para iniciar la compilación, otra para leer ambos resultados y escribir el informe. La ejecución de pruebas ya no necesita una decisión.
Modelo en cada paso. La llamada 1 lee 3.000 tokens. La llamada 2 lee 3.000 + 60 + 1.500 = 4.560. La llamada 3 lee 4.560 + 60 + 2.000 = 6.620. Entrada en total: 3.000 + 4.560 + 6.620 = 14.180 tokens; salida: 60 + 60 + 300 = 420.
Ejecución de pruebas en código. La llamada 1 lee 3.000 tokens. El harness ejecuta la compilación y luego las pruebas por regla, y la llamada 2 lee 3.000 + 60 + 1.500 + 2.000 = 6.560. Entrada en total: 3.000 + 6.560 = 9.560 tokens; salida: 60 + 300 = 360.
La diferencia es 14.180 − 9.560 = 4.620 tokens de entrada, cerca de un tercio de la entrada, más una respuesta pequeña. En DeepSeek-V4-Flash una tarea así cuesta $0.00025 de la primera forma y $0.00018 de la segunda. Una tarea es un error de redondeo. Digamos que tu agente hace 500 al día (14.180 × 500 = 7.090.000 tokens de entrada, 420 × 500 = 210.000 tokens de salida frente a 4.780.000 y 180.000):
La brecha crece con el contexto: cuanto más largos son los logs que el modelo arrastra, más vale una relectura omitida. Aquí está el mismo bucle lado a lado:
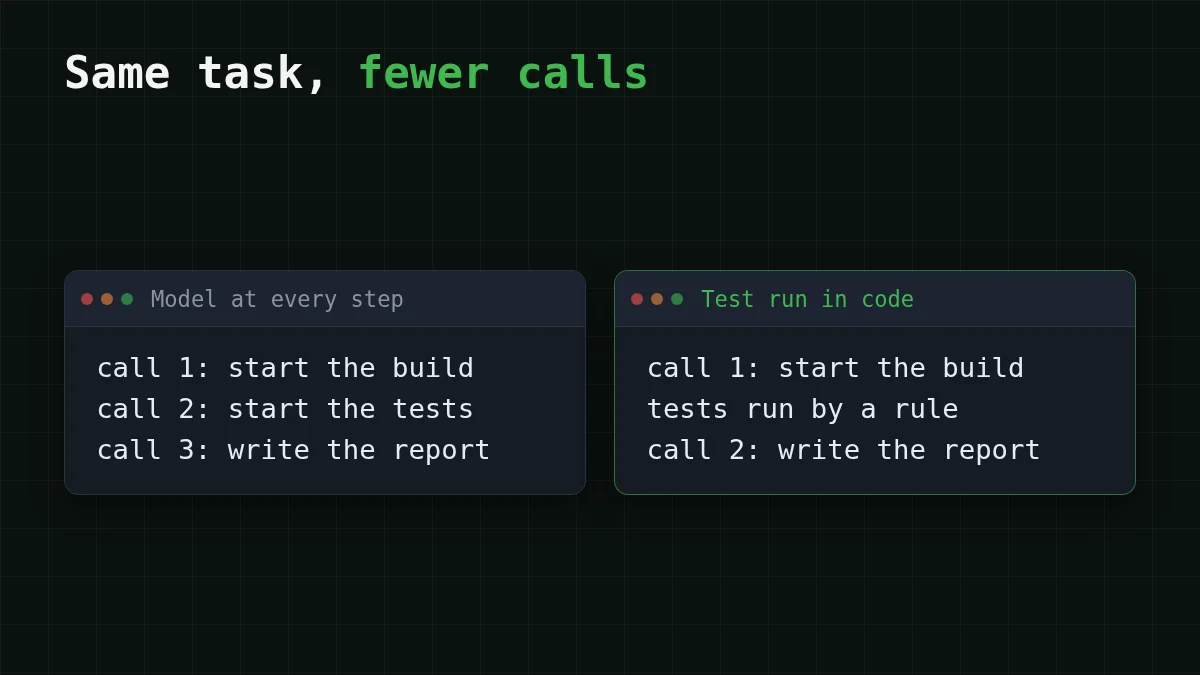
En código, la regla son unas pocas líneas. Esto es pseudocódigo, los nombres de los helpers son tuyos:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
Qué reportan los autores de HarnessMM#
La idea no es solo nuestra. HarnessMM es un preprint en arXiv (arXiv:2610.32813, enviado el 23 de octubre de 2026, consultado el 2 de noviembre de 2026) de Yuhua Jiang, Chang Xu, Feifei Gao y Li Zhao. Su observación: los harness de agentes a menudo vuelven a llamar al modelo tras la retroalimentación de una herramienta, incluso cuando una llamada anterior ya había determinado la siguiente acción. Su solución, la reutilización de decisiones con salvaguarda, reproduce esa decisión y recurre al modelo original cuando aparece una nueva decisión semántica, la evidencia no está respaldada o el selector se abstiene. El if de arriba es la versión escrita a mano de la misma idea; cómo decide su salvaguarda está en el paper.
Los autores reportan estos resultados en HumanEval:
- Harness de Codex: 66,72k → 47,02k tokens por tarea (−29,54%), éxito sin cambios en 90,82%.
- DeepSeek Harness: 96,28k → 11,62k tokens por tarea (−87,93%), éxito 71,43% → 85,71%.
Léelos con cuidado. Es un solo benchmark, el propio harness de los autores, un preprint que no ha pasado revisión por pares, y la página de arXiv no lista código. Puede que veas "88%" en versiones divulgadas: esa es solo la cifra de DeepSeek Harness, la de Codex es de alrededor del 30%. Trata ambas como una dirección, no como una promesa para tu agente. Tu propio log te dice más.
Revisa tu propio agente en diez minutos#
Activa un log de cada llamada al modelo, con los números usage de cada respuesta (seguimiento del coste de tokens de agentes en Python muestra una forma). Luego lee las últimas veinte ejecuciones y marca cada llamada: decisión o fija. Una llamada es candidata cuando la siguiente acción nunca cambió a lo largo de esas ejecuciones. ¿Qué muestra tu log?
Elige tu caso
¿Qué muestra tu log?
Elige una opción para ver la respuesta
El mismo par de llamadas en cada ejecución
Ahí se esconde una regla fija. Escríbela como un if sobre una señal clara, como el código de salida, y mantén el modelo como respaldo cuando la señal sea cualquier cosa inesperada.
Llamadas que solo reformatean o copian la salida de una herramienta
Muévelas a una plantilla en código. Si el texto realmente necesita un modelo, es un trabajo pequeño para un modelo barato, no para tu modelo más grande.
Llamadas donde el siguiente paso cambia con el contenido
Mantén el modelo aquí. Para eso está, y un modelo más barato a menudo maneja un paso simple de clasificar y elegir; consulta enrutamiento de modelos: primero el modelo barato.
Cada llamada relee un log enorme
Recorta lo que vuelve a la conversación: mantén la salida de herramientas fuera del contexto. La misma tarea sale más barata sin eliminar ninguna llamada.
Si quieres probar esto en un modelo con contexto largo, CheapTokens sirve DeepSeek-V4-Flash (deepseek-) para bucles de agentes: un precio a cualquier hora, 380K de contexto y hasta 32.768 tokens de salida por respuesta. Para los pasos que aún necesitan una decisión está GLM-5.3-Flash (zai-) con 390K de contexto. Ambos funcionan a través de la API compatible con OpenAI y Anthropic en https:/, con un solo saldo para todos los modelos. La configuración está en la documentación, los precios en la página de precios, y la página del modelo es DeepSeek barato.


