الذكاء الاصطناعي للمبتدئيندليل
هل تحتاج الوكلاء إلى النموذج في كل خطوة؟ ضع الخطوات الثابتة في الشفرة
لماذا تؤدي كل نتيجة أداة إلى استدعاء نموذج آخر، وأي خطوات الوكيل يمكن أن تكون شفرة بسيطة، وتكلفة حلقة من 3 خطوات مع الاستدعاء الإضافي وبدونه.
في هذه الصفحة
شغّلت وكيلك عشر دقائق، فجاءت الفاتورة أكبر من المهمة. غالبًا ما يكون السبب مملًا: بعد كل نتيجة أداة يستدعي الـ harness النموذج مرة أخرى، حتى عندما كانت الخطوة التالية واضحة.
إذن لا، لا يحتاج الوكيل إلى النموذج في كل خطوة. إنه يحتاج النموذج حيث يجب اتخاذ قرار. الخطوة التي تتكرر دائمًا بالشكل نفسه، مثل تشغيل الاختبارات بعد بناء ناجح، يمكن أن تكون قاعدة بسيطة في شفرتك.
هناك سبب مالي للاهتمام. كل استدعاء إضافي يعيد قراءة السياق كله كرموز إدخال (مقال المحادثة الطويلة يوضح السبب)، لذا فإن استدعاءً متخطّى يوفّر أكثر من إجابته القصيرة نفسها. إن كانت الحلقة جديدة عليك، فابدأ بـ كيف يعمل وكيل الذكاء الاصطناعي ثم عُد.
لماذا تعني نتيجة أداة واحدة استدعاء نموذج آخر#
النموذج لا ينفّذ شيئًا أبدًا. إنه يكتب "من فضلك شغّل make build"، فينفّذها الـ harness (البرنامج المحيط بالنموذج)، ويلصق المخرجات في المحادثة ويستدعي النموذج مجددًا بكل ما جرى حتى الآن. تلك هي الحلقة بأكملها. لا يعرف النموذج ما أعادته الأداة إلا عندما تستدعيه.
تخيّل زميلًا جديدًا يتصل بالمدير بعد كل خطوة ليسأل "وماذا الآن؟"، رغم أن قائمة المهام تقول "بعد الترجمة، شغّل الاختبارات". يجيب المدير الشيء نفسه كل مرة، وكل اتصال يكلّف دقيقة من قراءة القصة كلها من البداية.
هكذا يبدو ذلك في سجل وكيل. لنقل إن المهمة هي "أصلح الاختبار الفاشل":
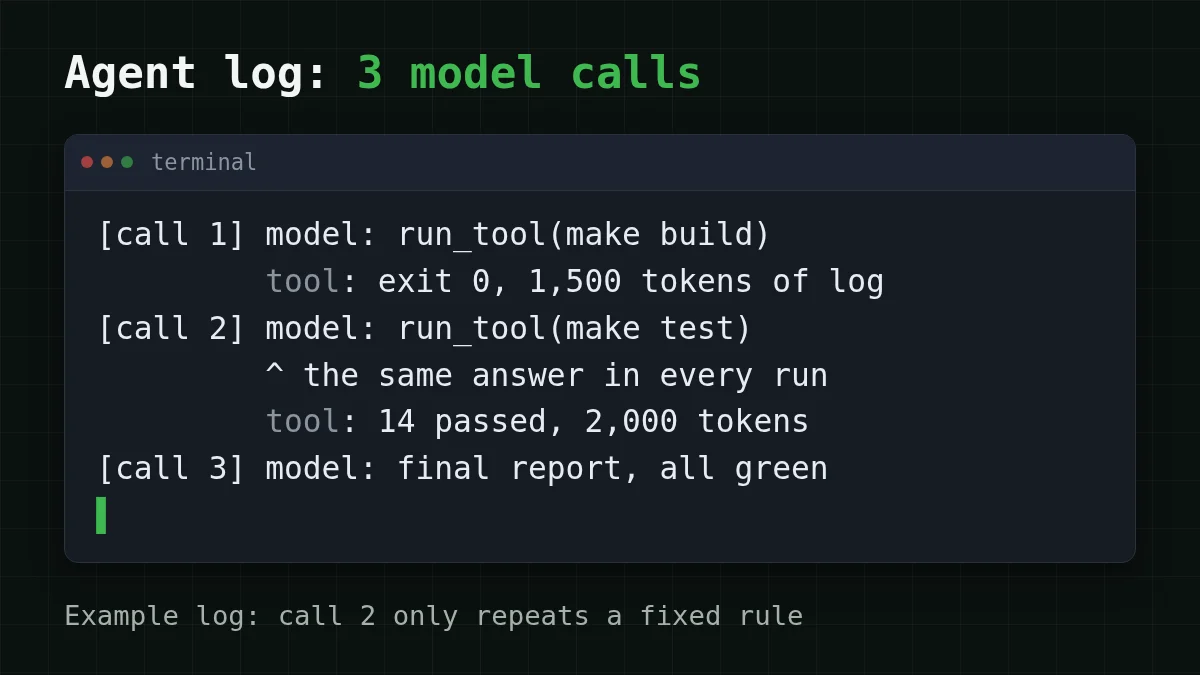
الاستدعاء الثاني هو المثير للاهتمام. نجح البناء، والخطوة التالية هي الاختبارات دائمًا، ويصرف النموذج قراءة كاملة للسياق ليقول "شغّل الاختبارات". الاستدعاء الأول والثالث مختلفان: الأول يختار كيف يبدأ، والثالث يقرأ نتائج الاختبار ويكتب التقرير. تلك أعمال حقيقية.
أي الخطوات تحتاج قرارًا وأيها ثابتة#
ثلاثة أسئلة تصنّف معظم الخطوات:
- هل تُحدَّد الخطوة التالية بإشارة واضحة، مثل رمز خروج أو حالة HTTP أو "وُجد / لم يوجد"؟
- هل هي الإجراء نفسه في كل مرة تظهر فيها تلك الإشارة؟
- هل التخمين الخاطئ رخيص التراجع عنه؟
ثلاث إجابات بنعم: اكتبها كقاعدة. وإلا فليحتفظ النموذج بالخطوة.
مثال ثانٍ، خارج البرمجة. لنقل إنك تشغّل سكربت دعم: يكتب عميل، فيبحث السكربت عن الطلب، ثم يرد. البحث عن الطلب برقمه هو شفرة. وملء "طلبك {id} حالته {status}" من قالب هو أيضًا شفرة. أما قراءة "وصل مكسورًا، ماذا الآن؟" والاختيار بين استرداد أو استبدال أو اعتذار فهو حكم، لذا يكون استدعاء نموذج واحدًا، لا ثلاثة.
طابق الأزواج
من يجب أن يتولى كل خطوة؟
اضغط على عنصر من اليسار، ثم على زوجه
- انتهى البناء برمز خروج 0، والخطوة التالية هي الاختبارات دائمًاشفرة: الخطوة التالية ثابتة
- فشلت الاختبارات مع تتبّع مكدس؛ أي ملف يحتاج التغيير؟نموذج: حكم جديد
- وُجد الطلب برقمه، والآن ضع حالته في قالب الردشفرة: املأ القالب
- يكتب العميل "وصل مكسورًا، ماذا الآن؟"نموذج: قراءة نص حر
حاجز واحد يجعل هذا آمنًا: القاعدة تغطي المسار السعيد فقط. فشل البناء برمز خروج 1؟ الاختبارات حمراء؟ أعادت أداة شيئًا لم تتوقعه القاعدة؟ أعد التحكم إلى النموذج، تمامًا كما كان. أنت تزيل استدعاءات لم يكن لها سوى إجابة واحدة ممكنة، لا تُخرج النموذج من الحلقة.
حلقة من 3 خطوات، مع الاستدعاء الإضافي وبدونه#
لنضع أرقامًا على سجل "أصلح الاختبار الفاشل". الافتراضات كلها لنا ويسهل استبدالها بأرقامك:
- موجه النظام مع المهمة: 3,000 رمز
- سجل البناء: 1,500 رمز؛ سجل الاختبار: 2,000 رمز
- رد يطلب أداة فقط: 60 رمزًا؛ التقرير النهائي: 300 رمز
خمّن الرقم
إذا انتقل تشغيل الاختبار إلى الشفرة، فكم استدعاء نموذج تصنع الحلقة؟
تخمينك
06
إظهار الإجابة
الإجابة: 2
اثنان: واحد لبدء البناء، وواحد لقراءة النتيجتين وكتابة التقرير. لم يعد تشغيل الاختبار يحتاج قرارًا.
النموذج في كل خطوة. يقرأ الاستدعاء الأول 3,000 رمز. يقرأ الثاني 3,000 + 60 + 1,500 = 4,560. يقرأ الثالث 4,560 + 60 + 2,000 = 6,620. إجمالي الإدخال: 3,000 + 4,560 + 6,620 = 14,180 رمزًا؛ الإخراج: 60 + 60 + 300 = 420.
تشغيل الاختبار في الشفرة. يقرأ الاستدعاء الأول 3,000 رمز. يشغّل الـ harness البناء، ثم الاختبارات بالقاعدة، ويقرأ الاستدعاء الثاني 3,000 + 60 + 1,500 + 2,000 = 6,560. إجمالي الإدخال: 3,000 + 6,560 = 9,560 رمزًا؛ الإخراج: 60 + 300 = 360.
الفرق هو 14,180 − 9,560 = 4,620 رمز إدخال، نحو ثلث الإدخال، زائد إجابة صغيرة واحدة. على DeepSeek-V4-Flash تكلّف مهمة واحدة كهذه $0.00025 بالطريقة الأولى و$0.00018 بالثانية. مهمة واحدة خطأ تقريب. لنقل إن وكيلك ينفّذ 500 منها يوميًا (14,180 × 500 = 7,090,000 رمز إدخال، 420 × 500 = 210,000 رمز إخراج مقابل 4,780,000 و180,000):
تتسع الفجوة مع السياق: فكلما طالت السجلات التي يجرّها النموذج، زادت قيمة إعادة القراءة المتخطّاة. إليك الحلقة نفسها جنبًا إلى جنب:
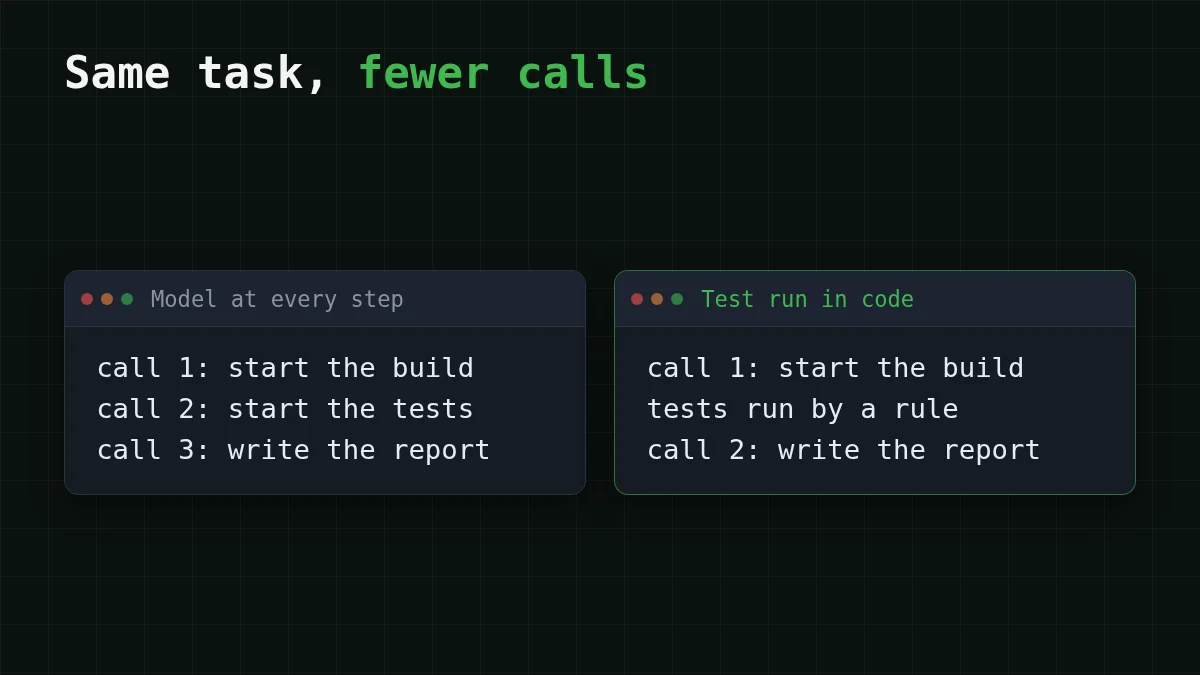
في الشفرة، القاعدة بضعة أسطر. هذا شبه شفرة، وأسماء الدوال المساعدة لك:
result = run_tool(call)              # the model asked for: make build
messages.append(tool_message(result))

if call.name == "build" and result.exit_code == 0:
    tests = run_tool("make test")    # fixed rule, no model call
    messages.append(tool_message(tests))
# anything else (build failed, odd output) goes back to the model

reply = call_model(messages)         # the model reads everything once
ما يذكره مؤلفو HarnessMM#
الفكرة ليست لنا وحدنا. HarnessMM ورقة أولية على arXiv (arXiv:2610.32813، قُدّمت في 23 أكتوبر 2026، فُحصت في 2 نوفمبر 2026) بقلم Yuhua Jiang وChang Xu وFeifei Gao وLi Zhao. ملاحظتهم: كثيرًا ما تستدعي الـ harness النموذج مجددًا بعد تغذية راجعة من أداة حتى عندما كان استدعاء سابق قد حدّد الخطوة التالية بالفعل. وإصلاحهم، إعادة استخدام القرار المحمية، يعيد تشغيل ذلك القرار ويرتد إلى النموذج الأصلي عند ظهور قرار دلالي جديد، أو عندما تكون الأدلة غير مدعومة أو يمتنع المحدِّد. الـ if أعلاه هو النسخة المكتوبة يدويًا من الفكرة نفسها؛ وكيف يقرر حاجزهم موجود في الورقة.
يذكر المؤلفون هذه النتائج على HumanEval:
- Codex harness: 66.72k → 47.02k رمز لكل مهمة (−29.54%)، والنجاح بلا تغيير عند 90.82%.
- DeepSeek Harness: 96.28k → 11.62k رمز لكل مهمة (−87.93%)، والنجاح 71.43% → 85.71%.
اقرأها بحذر. إنها معيار واحد، وharness المؤلفين أنفسهم، وورقة أولية غير محكّمة، وصفحة arXiv لا تسرد أي شفرة. قد ترى "88%" في الروايات: ذلك رقم DeepSeek Harness فقط، ورقم Codex نحو 30%. اعتبر كليهما اتجاهًا، لا وعدًا لوكيلك. سجلك الخاص يخبرك أكثر.
افحص وكيلك في عشر دقائق#
فعّل سجلًا لكل استدعاء نموذج، مع أرقام usage من كل استجابة (تتبّع تكلفة رموز الوكيل في Python يوضح طريقة). ثم اقرأ آخر عشرين تشغيلًا وعلّم كل استدعاء: قرار أم ثابت. الاستدعاء مرشح عندما لا تتغير الخطوة التالية عبر تلك التشغيلات. ماذا يُظهر سجلك؟
اختر حالتك
ماذا يُظهر سجلك؟
اختر خيارًا لعرض الإجابة
الزوج نفسه من الاستدعاءات في كل تشغيل
قاعدة ثابتة مختبئة هناك. اكتبها كـ if على إشارة واضحة، مثل رمز الخروج، وأبقِ النموذج كاحتياطي عندما تكون الإشارة أي شيء غير متوقع.
استدعاءات تعيد تنسيق مخرجات الأداة أو تنسخها فقط
انقلها إلى قالب في الشفرة. إن كان النص يحتاج نموذجًا فعلًا، فهي مهمة صغيرة لنموذج رخيص، لا لنموذجك الأكبر.
استدعاءات تتغير فيها الخطوة التالية مع المحتوى
أبقِ النموذج هنا. هذا ما وُجد من أجله، وغالبًا ما يتولى نموذج أرخص خطوة تصنيف واختيار بسيطة؛ انظر توجيه النماذج: النموذج الرخيص أولًا.
كل استدعاء يعيد قراءة سجل ضخم
قلّم ما يعود إلى المحادثة: أبقِ مخرجات الأدوات خارج السياق. تصبح المهمة نفسها أرخص دون إزالة أي استدعاء.
إن أردت تجربة هذا على نموذج بسياق طويل، يقدّم CheapTokens نموذج DeepSeek-V4-Flash (deepseek-) لحلقات الوكلاء: سعر واحد في أي ساعة، وسياق 380K وما يصل إلى 32,768 رمز إخراج لكل إجابة. وللخطوات التي ما زالت تحتاج قرارًا هناك GLM-5.3-Flash (zai-) بسياق 390K. يعمل كلاهما عبر واجهة API المتوافقة مع OpenAI وAnthropic على https:/، برصيد واحد لكل النماذج. الإعداد في التوثيق، والأسعار في صفحة الأسعار، وصفحة النموذج هي DeepSeek الرخيص.


