KI-NewsUpdate
Claude Fable 5.2 API-Preis: $8 / $40, Fast-Modus zum 2-fachen
Claude Fable 5.2 kostet $8 rein und $40 raus pro 1M Tokens; der Fast-Modus verdoppelt das. Sieh dir die API-ID an und was ein Agent-Tag kostet.
Auf dieser Seite
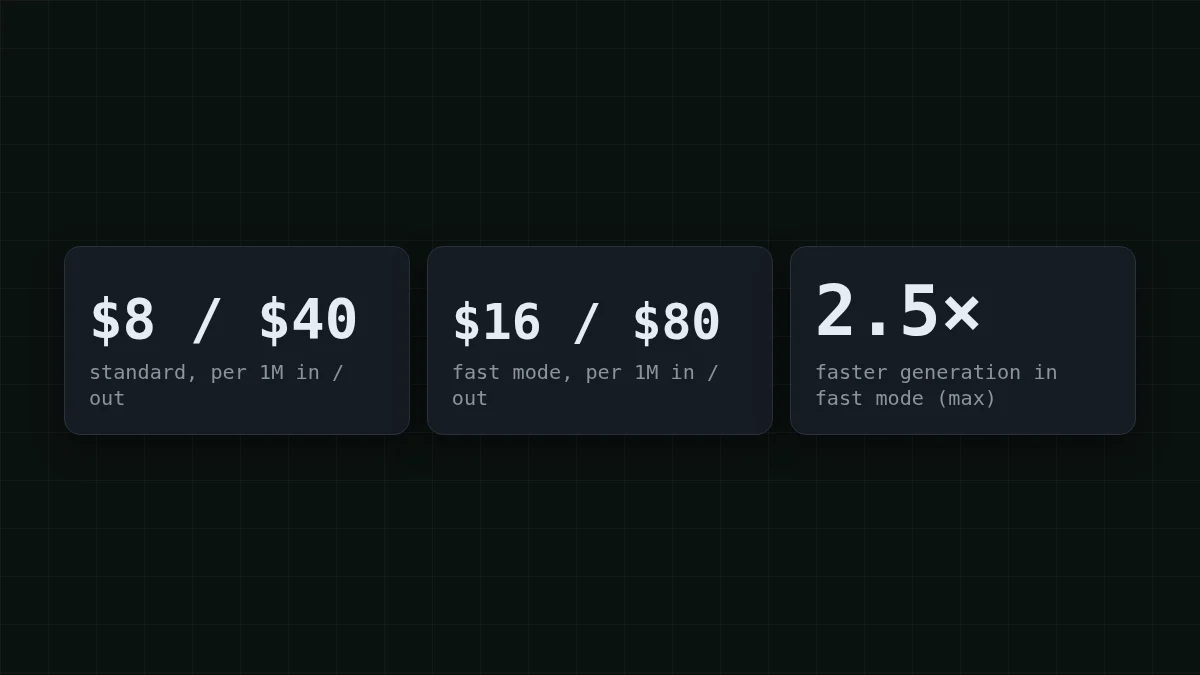
Claude Fable 5.2 ist als claude-fable-5-2 auf der API verfügbar. Der Standardpreis liegt bei $8 pro 1M Input-Tokens und $40 pro 1M Output-Tokens. Der Fast-Modus generiert bis zu 2,5-mal schneller und kostet genau das Doppelte: $16 / $80. Das stammt von Anthropics Release-Seite vom 9. November 2026 (geprüft am 10. November), und der Rest dieses Beitrags dreht sich darum, was diese Zahlen für eine Rechnung bedeuten.
Dein Agent lief zehn Minuten, und die Rechnung ist größer als die Aufgabe. Das ist die übliche Geschichte mit einem Top-Tier-Modell in einer Schleife, also packen wir echte Zahlen darauf.
Was Anthropic angekündigt hat#
Die Release-Seite, Claude Fable and Mythos 5.2, sagt:
- Fable 5.2 ist ab sofort auf der Claude Platform sowie auf AWS, Google Cloud und Microsoft Azure verfügbar.
- Der Output ist bis zu 30 % schneller als bei Claude Fable 5.1 (Anthropics eigene Angabe).
- Der Fast-Modus ist in Claude Code, der Claude Platform, Claude Models on Google Cloud und Microsoft Foundry verfügbar.
- Mythos 5.2 ist dasselbe zugrunde liegende Modell mit schwächeren Einschränkungen, beschränkt auf Organisationen, die über die Cyber- oder Life-Sciences-Verification-Programs zugelassen sind. Fable hat stärkere Cybersicherheits- und Biologie-Schutzmaßnahmen und steht allen Nutzern offen.
Die Seite nennt weder das Kontextfenster noch die maximale Output-Länge, und ich rate sie hier nicht. Prüfe sie in der Anthropic-Dokumentation, bevor du einen Prompt dimensionierst.
Was ein Agent-Schritt auf Fable 5.2 kostet#
Nehmen wir an, dein Coding-Agent macht einen typischen Aufruf mitten in der Aufgabe: 30.000 Tokens rein (die Historie, die er bei jedem Schritt erneut liest, plus Tool-Output) und 2.000 Tokens raus.
- Input: 30.000 / 1.000.000 × $8 = $0,24
- Output: 2.000 / 1.000.000 × $40 = $0,08
- Ein Schritt: $0,24 + $0,08 = $0,32
Das sieht klein aus. Jetzt die Schleife: Ein Agent, der 200 Schritte pro Tag macht, kostet $0,32 × 200 = $64 zum Standardpreis. Im Fast-Modus sind es $0,64 × 200 = $128 für dieselbe Arbeit.
Beachte, wohin das Geld fließt: Drei Viertel jedes Schritts entfallen auf die Input-Seite, die erneut gelesene Historie. Wenn du noch nie gesehen hast, warum das passiert, führt why AI agents use so many tokens durch ein Beispiel mit 20 Schritten.
Zahl erraten
Ein Agent-Schritt mit 30.000 Tokens rein und 2.000 raus auf Fable 5.2 zum Standardpreis: wie viele Cent?
Deine Schätzung
0100
Antwort anzeigen
Antwort: 32
32 Cent: $0,24 für Input plus $0,08 für Output. Der Fast-Modus würde das auf 64 verdoppeln.
Ist der Fast-Modus das Doppelte wert?#
Der Fast-Modus ändert die Geschwindigkeit, nicht die Antwort: dasselbe Modell, bis zu 2,5-mal schnellere Generierung, doppelter Preis pro Token. Ob sich das lohnt, hängt davon ab, wer wartet.
Wähle deinen Fall
Wo betreibst du Fable 5.2?
Wähle eine Option, um die Antwort zu sehen
Ich sitze vor Claude Code
Du liest jede Antwort und entscheidest den nächsten Schritt, also ist das Warten der teure Teil. Genau darauf zielt der Fast-Modus. Schalte ihn für die Strecken ein, in denen du aktiv steuerst, und aus, wenn du weggehst.
Der Agent läuft unbeaufsichtigt
Niemand schaut auf die Uhr, also würdest du das Doppelte für Geschwindigkeit zahlen, die niemand nutzt. Bleib beim Standardpreis und schau, welche Schritte überhaupt ein Top-Tier-Modell brauchen.
Eine Warnung zur Arithmetik: „Bis zu 2,5-mal schneller“ ist Anthropics Obergrenze, kein Versprechen für jede Anfrage. Stoppe eine deiner eigenen Aufgaben in beiden Modi, bevor du dich entscheidest.
Wo ein günstigeres Modell passt#
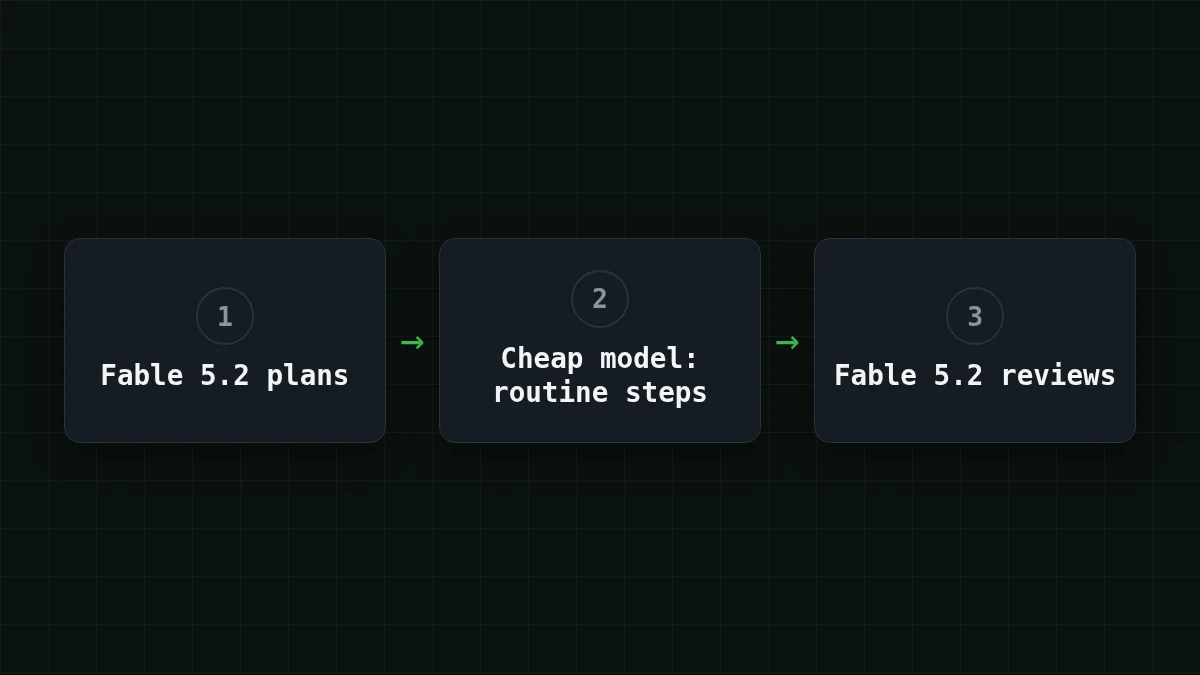
Die meisten Schleifen sind nicht ein einziges hartes Problem. Sie sind ein paar harte Entscheidungen, verpackt in viele Routine-Schritte: eine Datei lesen, einen Befehl ausführen, den Output zusammenfassen. Diese Routine-Schritte brauchen nicht das teuerste Modell, und genau dort häuft sich der Tagespreis an.
Eine übliche Aufteilung ist, Fable 5.2 planen und prüfen zu lassen und die Routine-Aufrufe an ein günstiges Modell zu schicken. Für diese Rolle hat CheapTokens DeepSeek-V4-Flash: bis zu 32.768 Tokens pro Antwort, 380K Kontext, ein Preis zu jeder Stunde und eine OpenAI- und Anthropic-kompatible API. Lass ein paar deiner eigenen Routine-Schritte darauf laufen und lies usage in der Antwort: Das zeigt dir, was ein Schritt dich wirklich kostet.
Hier ist derselbe Schritt mit 30.000 rein und 2.000 raus darauf: $0.00065. Und der 200-Schritte-Tag, live aus den aktuellen Preisen:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 200 Anfragen | OpenRouter, 200 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.136 | $0.234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.13 | $0.476 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $0.36 | $4.32 |
30.000 Input- und 2.000 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Die Anfrage ist ein normaler Chat-Aufruf. Verwende die vollständige Modell-ID aus der CheapTokens-Dokumentation (deepseek-); die kurze ID aus den Preisangaben wird von der API nicht akzeptiert.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this test output in 3 lines: ..."}],
    "max_tokens": 300
  }'
Die Antwort enthält einen usage-Block mit prompt_tokens und completion_, sodass du deine eigenen Schritte bepreisen kannst, statt meinen 30.000 / 2.000 zu vertrauen. Das Setup steht in der Dokumentation, die Modelle sind auf der DeepSeek-Seite, und model routing: cheap first, escalate behandelt, wie du entscheidest, welcher Schritt wohin geht. Speziell für Claude Code siehe how to make Claude Code cheaper.
Prüfe dein Verständnis#
Kurzer Check
Was ist der Fast-Modus auf Fable 5.2?
Antwort anzeigen
Antwort: Dasselbe Modell, das bis zu 2,5-mal schneller generiert, zum doppelten Preis pro Token
Anthropic gibt den Fast-Modus mit $16 / $80 pro 1M Tokens an, gegenüber $8 / $40 im Standard.
Kurze Antworten#
Was ist die API-ID? claude-fable-5-2.
Was kostet es? $8 pro 1M Input- und $40 pro 1M Output-Tokens; Fast-Modus $16 / $80 (Anthropic, 9. November 2026).
Wo kann ich es nutzen? Die Claude Platform, AWS, Google Cloud und Microsoft Azure; Fast-Modus in Claude Code, der Claude Platform, Google Cloud und Microsoft Foundry.
Was ist Mythos 5.2? Dasselbe zugrunde liegende Modell mit schwächeren Einschränkungen, für Organisationen, die über Anthropics Verification-Programs zugelassen sind.


