Berita AIPembaruan
Harga API Meta Muse Ember: $0,10 / $0,50, konteks 1 juta
Muse Ember dari Meta: tier harga, konteks 1 juta, output 512 ribu, dan berapa biaya sesi agen 50 langkah, dengan alternatif subtugas murah.
Di halaman ini
Muse Ember baru dari Meta adalah model kecil yang dibuat untuk langkah-langkah murah dan berulang di dalam sebuah agen, dan menurut pengumuman Meta biayanya $0,10 untuk input dan $0,50 untuk output per 1 juta token pada prompt hingga 200 ribu token. Di atas 200 ribu, harganya menjadi tiga kali lipat. Sesi agen 50 langkah dengan 20 ribu token masuk dan 500 token keluar per langkah menghabiskan sekitar $0,11 di Ember, dan peran yang sama terbuka untuk Anda di CheapTokens dengan DeepSeek-V4-Flash.
Model ini diumumkan pada 9 November 2026 di blog riset Meta (research.meta.ai/blog/muse-ember); postingan tersebut menampilkan tanggal tetapi tidak menampilkan waktu. Kami memeriksa blog dan halaman model di dev.meta.ai pada 10 November 2026.
Apa yang diumumkan Meta#
Muse Ember (id model muse-ember-1.0) adalah model terkecil dan paling efisien dalam lini Muse milik Meta, ditujukan untuk subtugas agen: pemanggilan tool, ekstraksi, routing, penguraian dokumen panjang. Anda dapat mengaksesnya di Muse Code, Meta Model API (hanya mode Standard), Google Cloud, dan Oracle Cloud. Meta tidak mengumumkan bobot terbuka, jadi API dan Muse Code adalah jalur masuknya. Region tidak disebutkan.
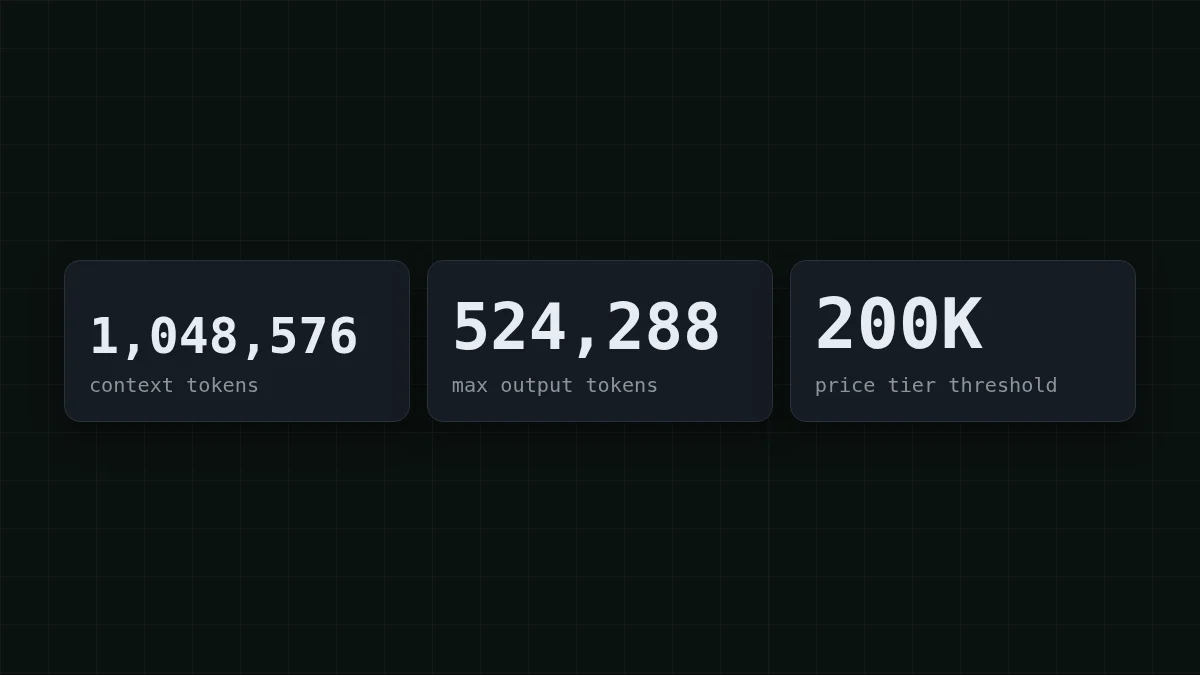
Batas dari halaman model Meta (dev.meta.ai/docs/muse-ember, tidak ada tanggal di halaman tersebut). Jendela konteks — 1.048.576 token, output maksimum — 524.288 token, dan tier harga yang lebih tinggi berlaku di atas 200 ribu token prompt.
Model ini menerima teks, gambar, video, audio, dan PDF sebagai input dan mengembalikan teks. Anda dapat memanggilnya melalui endpoint Responses, Chat Completions, atau Messages, dengan pemanggilan tool, output terstruktur, computer use, pemahaman gambar, dan search grounding. Tingkat penalaran (reasoning effort) berkisar dari minimal hingga max, dan default-nya adalah max. Streaming tidak disebutkan di halaman tersebut, jadi kami tidak akan mengklaimnya.
Meta juga menerbitkan angka benchmark, dan itu milik Meta, sebagian besar pada penalaran max: Terminal-Bench 4.0 sebesar 40,9% dibandingkan 39,2% untuk Haiku 5.5, AutomationBench-AA sebesar 37,8% dibandingkan 13,9% dan 20,2% untuk dua model lain yang dicantumkan Meta, dan FrontierCode 2.0-AA sebesar 27,2%, di belakang Haiku 5.5 pada 34,9%. Pada Artificial Analysis Intelligence Index, skornya 36 dibandingkan 37 untuk Muse Spark 1.3. Anggap saja sebagai klaim vendor sampai Anda menjalankan kasus Anda sendiri.
Berapa biaya sesi 50 langkah di Ember#
Tabel harga, menurut pengumuman Meta (halaman model itu sendiri mengarah ke halaman harga tanpa angka):
Gulir tabel ke kanan →
| Ukuran prompt | Input | Input cache | Output |
|---|---|---|---|
| hingga 200 ribu token | $0,10 | $0,004 | $0,50 |
| di atas 200 ribu token | $0,30 | $0,012 | $1,50 |
Harga per 1 juta token, diperiksa 10 November 2026. Sumber sekunder menjelaskan aturan di atas 200 ribu secara berbeda, jadi konfirmasikan di halaman harga Meta sebelum Anda menyusun anggaran berdasarkan aturan tersebut.
Sekarang sebuah sesi. Katakanlah agen Anda melakukan 50 langkah, dan setiap langkah mengirim sekitar 20 ribu token (riwayat yang terus bertambah ditambah hasil tool) dan menerima sekitar 500 token kembali. Itu berarti total 1 juta token masuk dan 25 ribu token keluar. Di Ember: 1 × $0,10 + 0,025 × $0,50 = $0,1125 (jumlah token dalam satuan juta). Sisi input hampir menjadi seluruh tagihan, itulah sebabnya harga input cache sebesar $0,004 penting jika agen Anda mempertahankan prefix yang sama.
Tebak angkanya
Katakanlah tarif yang lebih tinggi berlaku untuk seluruh prompt (begitulah bunyi kalimat Meta). Berapa sen biaya input dari prompt 250 ribu token di Ember?
Tebakan Anda
020
Tampilkan jawaban
Jawaban: 7,5
Jika tarif yang lebih tinggi berlaku untuk seluruh prompt: 250.000 × $0,30 per 1 juta = $0,075, jadi 7,5 sen untuk input saja. Lima puluh langkah seperti itu berarti $3,75 untuk input.
Mengapa prompt panjang sama sekali? Karena agen mengirim ulang riwayat pada setiap langkah; jika itu hal baru bagi Anda, mengapa agen membaca ulang seluruh riwayatnya menjelaskannya dengan contoh kecil.
Prompt Anda ada di tier mana?#
Garis 200 ribu adalah yang perlu diperhatikan. Meta mencantumkan tarif tiga kali lebih tinggi untuk prompt yang lebih panjang: $0,30 untuk input, $0,012 untuk input cache, dan $1,50 untuk output.
Pilih kasus Anda
Di mana letak permintaan terbesar agen Anda?
Pilih opsi untuk melihat jawabannya
Di bawah 200 ribu token
Anda tetap di tier bawah. Anggarkan dengan $0,10 masuk / $0,50 keluar dan perhatikan sisi output jika Anda mempertahankan reasoning effort pada default.
Antara 200 ribu dan 1 juta token
Tier yang lebih tinggi berlaku, dan jendela 1.048.576 token Ember masih cukup untuk Anda. Pangkas output tool lama sebelum melewati 200 ribu, atau pecah pekerjaan sehingga hanya satu langkah yang membawa dokumen penuh.
Di atas 1 juta token
Tidak muat dalam satu permintaan. Potong input menjadi beberapa bagian dan biarkan planner menggabungkan hasilnya.
Peran subtugas murah yang sama di CheapTokens#
Tata letak agen yang umum mempertahankan model yang lebih besar untuk perencanaan dan mengirim subtugas berulang ke model yang murah. Untuk kursi kedua itu, CheapTokens memiliki DeepSeek-V4-Flash: konteks 380 ribu, hingga 32.768 token output per jawaban, satu harga kapan pun sepanjang hari tanpa jam sibuk, API yang kompatibel dengan OpenAI dan Anthropic, serta satu saldo di semua model. GLM-5.3-Flash adalah opsi lain untuk loop pemanggilan tool dan penguraian dokumen panjang, dengan konteks 390 ribu dan hingga 8.192 token output. Jalankan 20 subtugas Anda sendiri di DeepSeek-V4-Flash dan bandingkan hasilnya berdasarkan field usage.
Berikut sesi 50 langkah yang sama, 20 ribu token masuk dan 500 token keluar per langkah, dengan harga langsung:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 50 permintaan | OpenRouter, 50 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00042 | $0.021 | $0.0356 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00035 | $0.0175 | $0.0735 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0011 | $0.0538 | $0.645 |
20.000 token input dan 500 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Baris DeepSeek-V4-Flash untuk seluruh sesi adalah $0.0175; secara total, dengan input dan output dihitung bersama, hasilnya lebih murah daripada harga referensi OpenRouter untuk model yang sama. Harga di halaman ini diperbarui sendiri.
Mencobanya cukup satu permintaan. Kunci dimasukkan ke variabel lingkungan, dan id model adalah id lengkap dari dokumentasi (dokumentasi berisi daftarnya; harga berisi tarif terkini):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Extract the order number from: Order #48213 shipped today."}],
    "max_tokens": 100
  }'
Balasannya memiliki objek usage yang biasa, sehingga Anda dapat membaca token input dan output sebenarnya dari subtugas Anda dan memasukkannya ke tabel di atas. Untuk pola routing itu sendiri, lihat model routing: model murah dulu, eskalasi dan, untuk lebih lanjut tentang model ini, DeepSeek di CheapTokens.
Perhatikan sisi output#
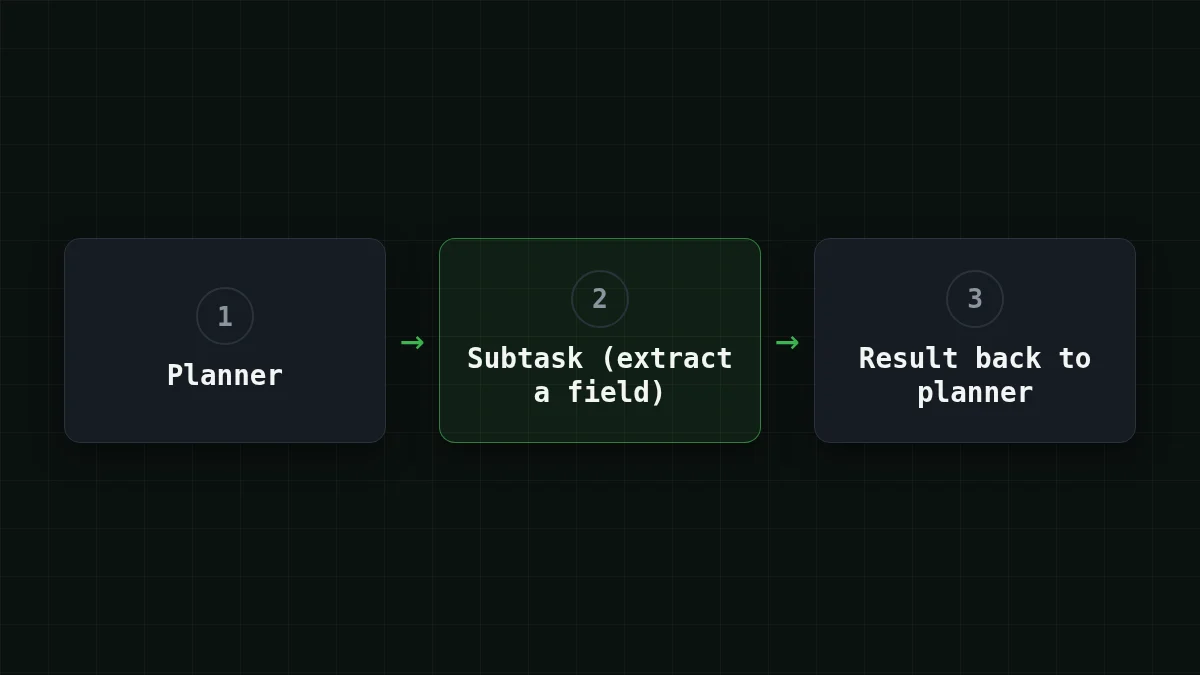
Reasoning effort default Ember adalah max, dan angka benchmark Meta sendiri sebagian besar dijalankan dengan cara itu. Subtugas yang hanya perlu mengambil satu field dari dokumen tidak memerlukannya, dan reasoning effort yang lebih tinggi bisa berarti lebih banyak token output, sisi yang lebih mahal. Halaman Meta tidak menyebutkan bagaimana token penalaran dihitung, jadi baca usage daripada berasumsi.
Coba sendiriCoba: bagaimana Anda mengetahui berapa yang sebenarnya dihabiskan satu subtugas?Tampilkan jawaban
Kirim 20 subtugas nyata pada pengaturan effort terendah, lalu pada default, dan baca usage di setiap balasan. Kalikan rata-rata input dan output dengan jumlah langkah per hari Anda dan hitung biayanya dengan harga Ember dari tabel di atas. Jika jawabannya cocok pada kasus Anda, pengaturan yang lebih murah adalah yang perlu dipertahankan. Mengapa itu berhasil dijelaskan di reasoning effort dan token berpikir.
Pandangan praktis bagi para pembangun: Ember diberi harga untuk kursi murah di sebuah agen, garis 200 ribu adalah angka yang perlu dijadikan acuan desain, dan satu-satunya angka yang menentukan adalah angka dari field usage Anda sendiri.


