খরচ অপ্টিমাইজেশনগাইড
বাল্ক কাজে থিংকিং টোকেন: effort, ক্যাপ, স্টেজ বাজেট
থিংকিং টোকেন আউটপুট হিসেবে বিল হয় এবং max_tokens-এ গণনা হয়। কীভাবে সেগুলো ক্যাপ করবেন এবং একটি সস্তা মডেল দিয়ে 40,000-আইটেমের বাল্ক কাজ অনুমান করবেন তা দেখুন।
এই পৃষ্ঠায়
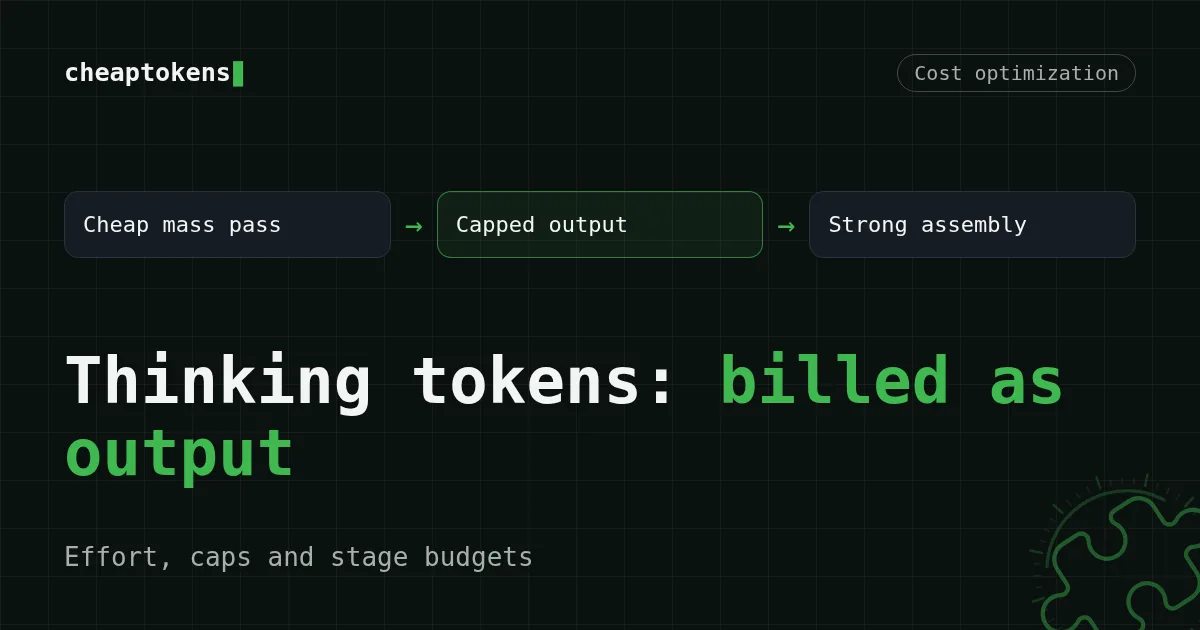
থিংকিং টোকেন আউটপুট টোকেন হিসেবে বিল হয়, এবং আপনি সেগুলো না দেখলেও সেগুলো max_tokens-এ গণনা হয়। তাই একটি বড় কাজের বিল নির্ভর করে মডেল কতটা ভাবে তার উপর, শুধু তার দৃশ্যমান উত্তর কত লম্বা তার উপর নয়। যে দুটি লিভার গুরুত্বপূর্ণ তা হলো একটি আউটপুট ক্যাপ এবং কাজের একটি বিভাজন: বাল্ক পাসের জন্য একটি সস্তা মডেল, শুধু অ্যাসেম্বলির জন্য একটি শক্তিশালী মডেল।
যদি আপনার এজেন্ট দশ মিনিট ধরে চলে এবং বিল কাজটির চেয়ে বড় হয়, তাহলে প্রথমে এখানেই দেখুন।
বিলে একটি থিংকিং টোকেন কেমন দেখায়#
একটি ক্লাসিফায়ার নিন যা প্রতিটি কমেন্টের জন্য keep বা drop উত্তর দেয়। দৃশ্যমান উত্তর একটি একক শব্দ; এর জন্য প্রায় 20 আউটপুট টোকেন বাজেট করি। ধরুন মডেল প্রথমে যুক্তি করে এবং সেটিতে 600 টোকেন খরচ করে। আপনি স্ক্রিনে 20 টোকেন দেখেন এবং 620-এর জন্য অর্থ দেন।
Anthropic-এর effort পেজ (৫ নভেম্বর ২০২৬-এ যাচাই করা) এটি সম্পর্কে স্পষ্ট: থিংকিং কনটেন্ট ফেরত না দিলেও থিংকিং max_tokens-এ গণনা হয়, এবং max_tokens হলো মোট আউটপুটের উপর একটি কঠোর সীমা, থিংকিং প্লাস রেসপন্স টেক্সট। আউটপুট দিকটিই সেই দিক যা প্রতি টোকেনে বেশি দামে বিল হয়, তাই এটিই ব্যথা দেয়।
সংখ্যা অনুমান করুন
একটি মডেল 600 টোকেন ভাবে, তারপর একটি 20-টোকেন উত্তর লেখে। কত আউটপুট টোকেন বিল হয়?
আপনার অনুমান
০২,০০০
উত্তর দেখান
উত্তর: ৬২০
620। থিংকিং এবং উত্তর দুটোই আউটপুট; দৃশ্যমান হোক বা না হোক, আপনি পুরো স্ট্রিমের জন্য অর্থ দেন।

এটিকে 40,000 কমেন্ট দিয়ে গুণ করুন এবং অদৃশ্য অংশটিই ইনভয়েসের বেশিরভাগ। একটি রিকোয়েস্টের দুই দিকের মূল বিষয় জানতে, দেখুন input vs output tokens।
Effort: একটি ডায়াল, বাজেট নয়#
Anthropic-এর Messages API output_ দিয়ে effort সেট করে। কোনো মান না দিলে মডেলের ডিফল্ট প্রযোজ্য হয়। লেভেলগুলো হলো max, xhigh, high, medium এবং low। বেশিরভাগ মডেলে ডিফল্ট high; Claude Opus 5.5 এবং Claude Haiku 5.5-এর ডিফল্ট medium।
একই পেজের তিনটি বিবরণ মনে রাখা উচিত:
- Effort প্রতিটি আউটপুট টোকেনে প্রযোজ্য, থিংকিং সহ বা ছাড়া। কম effort মানে কম এবং সংক্ষিপ্ত টুল কল, যা এজেন্টের জন্য গুরুত্বপূর্ণ।
lowসরল কাজ এবং সাবএজেন্টের জন্য উপযুক্ত।- Effort একটি আচরণগত সংকেত, কঠোর টোকেন বাজেট নয়। এটি মডেলকে প্ররোচিত করে; এটি কোনো সংখ্যার প্রতিশ্রুতি দেয় না। কঠোর সীমা হলো
max_tokens।
তাই effort হলো মডেল কতটা কঠোরভাবে চেষ্টা করে তার ডায়াল, এবং আউটপুট ক্যাপ হলো বেড়া। যেখানে পাওয়া যায় সেখানে দুটোই চান। থিংকিং কেন বেশি খরচ করে তার সহজ গল্পের জন্য একটি বিগিনার সংস্করণ আছে: reasoning effort and thinking tokens explained।
একটি বাস্তব পাইপলাইন: একটি মডেল নির্দেশ দেয়, আরেকটি বাল্ক কাজ করে#
Andrej Karpathy, AI গবেষক এবং OpenAI-এর সহ-প্রতিষ্ঠাতা, ৩১ অক্টোবর ২০২৬-এ তার HN ভিডিও পাইপলাইন বর্ণনা করেন (পোস্টটি)। Claude Opus 5.5 মিডিয়াম effort-এ, যা তার ডিফল্ট, সমস্ত Hacker News কমেন্ট ডাউনলোড করে, সেগুলোকে প্রায় 40,000 কমেন্টে সংকুচিত করে যা একটি YouTube ভিডিও সুপারিশ করে, এবং 150টি বিষয়ে 2007 থেকে 2026 পর্যন্ত 6,454টি ভিডিও নিয়ে একটি সাইট তৈরি করে। Sonnet একটি Claude Code ওয়ার্কফ্লোতে কমেন্টগুলোর উপর চলে স্প্যাম ফিল্টার করে এবং সুপারিশগুলো খুঁজে বের করে। তার বিবরণ অনুযায়ী পুরো কাজটিতে এখন প্রায় দুই ঘণ্টা লাগে।
পোস্টে কোনো টোকেন সংখ্যা বা খরচ দেওয়া নেই, তাই দাম নিয়ে উদ্ধৃত করার কিছু নেই। এটি যা দেখায় তা হলো আকৃতি: শক্তিশালী মডেল মিডিয়াম effort-এ শীর্ষে বসে কী তৈরি করতে হবে তা সিদ্ধান্ত নেয়; একটি সস্তা মডেল পুনরাবৃত্তিমূলক অংশটি চালায়। লক্ষ্য করুন টোকেনগুলো কোথায় যায়। নির্দেশ দেওয়া কয়েকটি বড়, বিরল ধাপ। ফিল্টারিং হলো হাজার হাজার ছোট, অভিন্ন ধাপ।

একই বিভাজন যেকোনো জোড়া মডেলের সাথে কাজ করে। আপনি যদি ফিল্টার প্রম্পটটিই চান, তা আছে filtering 40K comments with an LLM-এ; কোন রিকোয়েস্ট কোন মডেলে যাবে তা ঠিক করতে দেখুন model routing, cheap first।
বাল্ক পাস অনুমান করুন#
এটি আমাদের নিজস্ব অনুমান, Karpathy-র সংখ্যা নয়: 40,000 কমেন্ট, প্রতিটি প্রায় 150 ইনপুট টোকেন (নির্দেশনা প্লাস কমেন্ট) এবং প্রতিটি প্রায় 20 আউটপুট টোকেন (একটি লেবেল এবং কয়েকটি শব্দ)।
- ইনপুট: 40,000 × 150 = 6,000,000 টোকেন
- আউটপুট: 40,000 × 20 = 800,000 টোকেন
DeepSeek-V4-Flash-এ সেই পাসের খরচ $0.17। টেবিলটি আমাদের পরিবেশন করা প্রতিটি মডেলে একই ওয়ার্কলোড দেখায়; মোটে, ইনপুট এবং আউটপুট একসাথে গণনা করলে, প্রত্যেকটিই OpenRouter-এর চেয়ে সস্তা।
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ৪০,০০০টি অনুরোধ | OpenRouter, ৪০,০০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000038 | $0.152 | $0.267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000043 | $0.17 | $0.532 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000011 | $0.42 | $5.04 |
প্রতি অনুরোধে ১৫০ ইনপুট এবং ২০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
এখন মডেলকে উত্তর দেওয়ার আগে প্রতিটি কমেন্টের জন্য 600 টোকেন ভাবতে দিন, তাই প্রতি আইটেমে 620 আউটপুট টোকেন: 40,000 × 620 = 24,800,000 আউটপুট টোকেন। DeepSeek-V4-Flash-এ একই পাস হয় $2.57। একই ইনপুট, এবং যদি মডেল প্রতিটি কমেন্টের জন্য 600 টোকেন ভাবে, আউটপুট দিক একত্রিশ গুণ বাড়ে। সেই থিংকিং মূল্যবান কিনা তা আপনার নিজের eval বলবে; এক-শব্দের keep/drop-এর জন্য এটি নিম্ন লেভেলে বা একটি ক্যাপ দিয়ে পরীক্ষা করার প্রথম জিনিস।
আপনার নিজের সংখ্যা নিয়ে খেলুন: প্রতি রিকোয়েস্টে টোকেন এবং রিকোয়েস্টের সংখ্যা, এবং ক্যালকুলেটর লাইভ দাম ব্যবহার করে।
খরচ ক্যালকুলেটর
বাল্ক পাস: 40,000 কমেন্ট, ছোট লেবেল
প্রতি অনুরোধে ইনপুট টোকেন: ১৫০ · প্রতি অনুরোধে আউটপুট টোকেন: ২০ · প্রতিদিন অনুরোধ: ৪০,০০০
| মডেল | প্রতিদিন | প্রতি মাসে |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.152 | $4.56 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.17 | $5.10 |
| MiniMax-M2.7$0.05$0.15 | $0.42 | $12.60 |
আজই যে লিভারগুলো টানা যায়#
ভিন্ন API ভিন্ন থিংকিং নিয়ন্ত্রণ প্রকাশ করে, তাই এখানে সেগুলো যা সর্বত্র কাজ করে: একটি কঠোর ক্যাপ, একটি সংক্ষিপ্ত-উত্তর নির্দেশনা এবং একটি স্টেজ বিভাজন।
CheapTokens-এ বাল্ক পাসের জন্য একটি ন্যূনতম রিকোয়েস্ট। বেস URL হলো https:/ এবং মডেল আইডি হলো ডকস থেকে সম্পূর্ণটি:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 1024,
    "messages": [
      {"role": "system", "content": "Reply with exactly one word: keep or drop."},
      {"role": "user", "content": "Comment: this talk on compilers changed how I think, youtube.com/watch?v=example"}
    ]
  }'
রেসপন্সে usage. পড়ুন: সেই সংখ্যাটিই রিকোয়েস্টের জন্য আপনার আউটপুট বিল। ক্যাপ থিংকিং এবং দৃশ্যমান উত্তর একসাথে বেড়া দেয়। যদি finish_reason হয় length এবং কনটেন্ট খালি থাকে, উত্তর আসার আগেই ক্যাপ শেষ হয়েছে: এটি বাড়ান, বা একটি ছোট উত্তর চান। কয়েকটি কমেন্টে usage. পরীক্ষা করুন, তারপর ক্যাপটি প্রকৃত সর্বোচ্চের ঠিক উপরে সেট করুন। ক্যাপ এবং স্টপ-সিকোয়েন্সের বিবরণ আছে cut output tokens-এ, এবং বাক্যের মাঝখানে কাটার ব্যাখ্যা আছে why an answer stops mid-sentence-এ।
DeepSeek-V4-Flash 380K কনটেক্সটসহ প্রতি উত্তরে 32,768 আউটপুট টোকেন পর্যন্ত অনুমোদন করে, তাই 1,024-এর একটি ক্যাপ একটি পছন্দ, সীমা নয়। GLM-5.3-Flash (8,192 আউটপুট, 390K কনটেক্সট) এবং MiniMax-M2.7 (8,192 আউটপুট, 180K কনটেক্সট) একই প্যাটার্নে ফিট করে। প্রতি স্টেজে ক্যাপ বেছে নিন।
তুলনা করুন
এজেন্ট লুপ সেটিংস
আগে
প্রতিটি ধাপ সর্বোচ্চ effort এবং কোনো ক্যাপ ছাড়া চলে। মডেল প্রতিটি টুল কলের আগে দীর্ঘ যুক্তি লেখে, এবং বিল হওয়া আউটপুট দৃশ্যমান উত্তরের অনেক উপরে।
পরে
সাবএজেন্ট এবং সরল ক্লাসিফিকেশন কম effort-এ বা একটি সংক্ষিপ্ত-উত্তর নির্দেশনা এবং একটি max_tokens ক্যাপ দিয়ে চলে। শুধু অ্যাসেম্বলি ধাপ বেশি জায়গা পায়, এবং তাও কেবল আপনার নিজের eval লাভ দেখালে।
পুরো জিনিসটি এক পৃষ্ঠায় দেখতে, লাইভ দামের টেবিল আছে CheapTokens pricing-এ, এবং রিকোয়েস্ট ফরম্যাট আছে docs-এ।
প্রতি স্টেজে effort: একটি সংক্ষিপ্ত নিয়ম#
বাল্ক পাসে কম দিয়ে শুরু করুন এবং একবারে একটি স্টেজ বাড়ান। যে সংখ্যাটি আপনার নিজের eval বলে মূল্যবান সেটিই রাখুন, যে সংখ্যাটি সবচেয়ে নিরাপদ শোনায় তা নয়। শক্তিশালী মডেলের একটি ছোট, ইতিমধ্যে ফিল্টার করা সেট দেখা উচিত; সস্তা মডেলের বাকি সবকিছু দেখা উচিত।


