LLM দিয়ে ৪০ হাজার কমেন্ট ফিল্টার: রাখুন/বাদ দিন প্রম্পট এবং খরচ
একটি রাখুন/বাদ দিন প্রম্পট, একটি ছোট Python লুপ এবং সস্তা LLM দিয়ে ৪০,০০০ কমেন্ট ফিল্টার করার টোকেন অনুমান, কিছু চালানোর আগে।
এই পৃষ্ঠায়
আপনার আর্কাইভে ৪০,০০০ কমেন্ট আছে, এবং এর বেশিরভাগই শব্দ: স্প্যাম, "+1", রসিকতা, এমন রিপ্লাই যা আপনার লক্ষ্যের সাথে সম্পর্কহীন। একটি সস্তা LLM প্রতিটি কমেন্ট পড়ে এক শব্দে উত্তর দিতে পারে, keep বা drop। প্রতিটি কমেন্টকে আলাদা ছোট রিকোয়েস্ট হিসেবে পাঠালে পুরো পাসে প্রায় ৬ মিলিয়ন ইনপুট টোকেন এবং ২০০ হাজার আউটপুট টোকেন লাগে (ধরে নিচ্ছি প্রতি কমেন্টে প্রায় ১৫০ টোকেন ইন এবং ৫ টোকেন আউট)। DeepSeek-V4-Flash-এ বর্তমান মূল্যে এই রানটির খরচ $0.11।
নিচে: প্রম্পট, একটি ছোট Python লুপ, এবং হিসাব যা আপনি নিজের আর্কাইভের জন্য পুনরায় করতে পারেন। সবকিছু CheapTokens ডকুমেন্টেশন-এ বর্ণিত OpenAI-সামঞ্জস্যপূর্ণ এন্ডপয়েন্টের মাধ্যমে যায়।
ধারণাটি কোথা থেকে এসেছে#
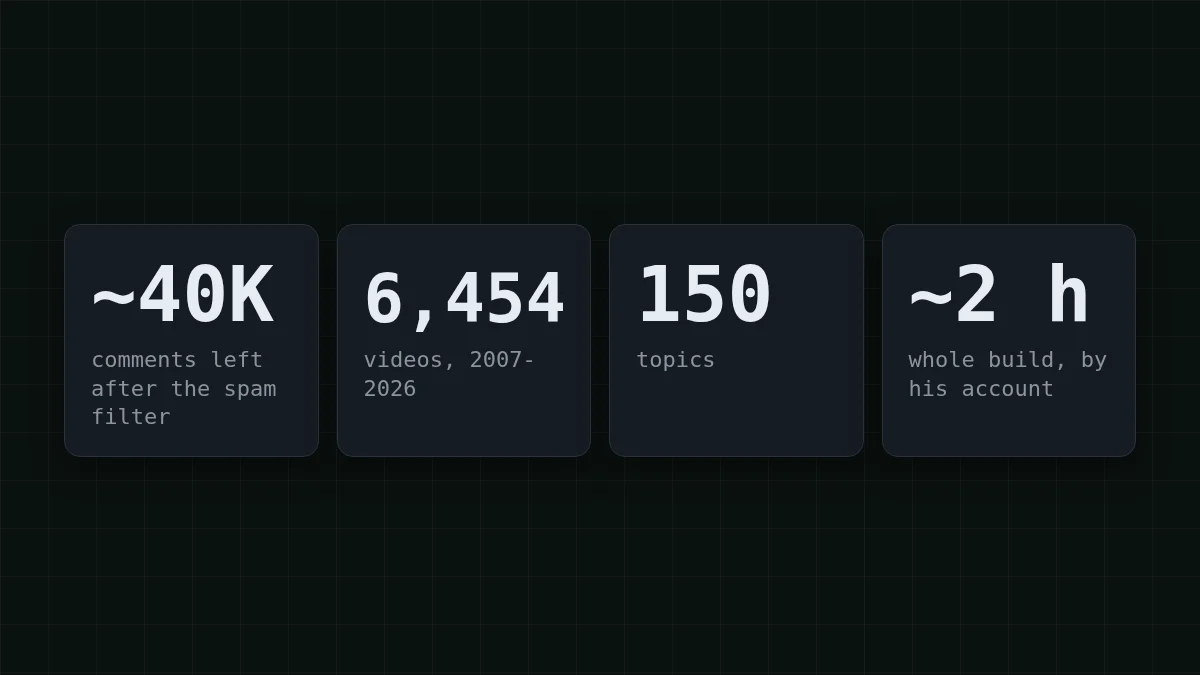
Andrej Karpathy (AI গবেষক, OpenAI-এর সহ-প্রতিষ্ঠাতা, Tesla-র সাবেক AI পরিচালক) ২০২৬ সালের ৩১ অক্টোবরের পোস্টে বর্ণনা করেছেন কীভাবে তিনি HackerTube তৈরি করেছেন, যা Hacker News কমেন্টে সুপারিশকৃত ভিডিওর সাইট। সেই নির্মাণে, Sonnet একটি Claude Code ওয়ার্কফ্লোতে কমেন্টগুলোর উপর চলে স্প্যাম সরিয়ে ফেলে এবং সেগুলোকে প্রায় ৪০,০০০ কমেন্টে সংকুচিত করে যা YouTube ভিডিও সুপারিশ করে। ফলাফল ছিল ১৫০টি বিষয়ে ৬,৪৫৪টি ভিডিও, এবং তিনি বলেন পুরো নির্মাণ এখন প্রায় দুই ঘণ্টা সময় নেয়।
পোস্টে টোকেন সংখ্যা বা খরচ উল্লেখ নেই। তাই এই নিবন্ধের সংখ্যাগুলো পাশে উল্লিখিত অনুমান থেকে গণনা, তার রানের পুনর্গঠন নয়। আপনি যা ধার করতে পারেন তা হলো কাজের আকার: অনেক ছোট টেক্সট, প্রতিটির সম্পর্কে একটি হ্যাঁ/না প্রশ্ন।
একটি হ্যাঁ/না ফিল্টার কীভাবে কাজ করে#
একজন দারোয়ানের কথা ভাবুন যার এক-লাইনের নিয়ম: "টিকিট আছে যে কেউ ঢুকতে পারে"। সে প্রত্যেককে এক সেকেন্ড দেখে, হ্যাঁ বা না বলে, এবং আগের অতিথিকে কখনো মনে রাখে না। একটি LLM ফিল্টার একইভাবে কাজ করে। প্রতিটি রিকোয়েস্টে আপনার নির্দেশনা এবং একটি কমেন্ট থাকে, এবং মডেল একটি শব্দ ফেরত দেয়। কমেন্ট ১৭,০০০ কমেন্ট ১৬,৯৯৯ সম্পর্কে কিছু জানে না।
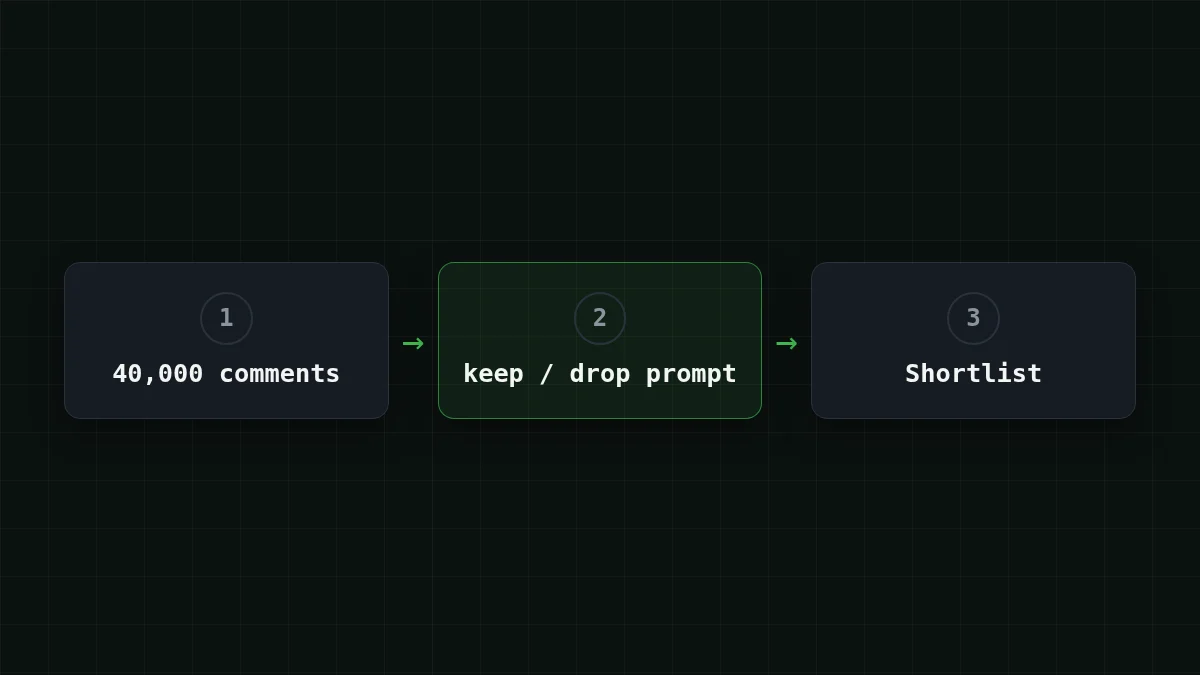
এই নকশার কারণেই বিলটি পূর্বানুমেয়। প্রতিটি রিকোয়েস্টের আকার প্রায় একই, তাই খরচ = রিকোয়েস্ট × প্রতি রিকোয়েস্টে টোকেন। এবং যেহেতু উত্তর একটি শব্দ, প্রায় সব টাকা ইনপুট দিকে যায়: নির্দেশনা এবং আপনি যে কমেন্ট পাঠান। যদি ইনপুট এবং আউটপুট মূল্য আপনার কাছে নতুন হয়, ইনপুট বনাম আউটপুট টোকেন বিভাজনটি ব্যাখ্যা করে।
রাখুন/বাদ দিন প্রম্পট লিখুন#
এখানে প্রম্পটই পুরো পণ্য। একটি অস্পষ্ট সংস্করণের সাথে একটি সুনির্দিষ্ট সংস্করণ তুলনা করুন:
তুলনা করুন
অস্পষ্ট নিয়ম বনাম সুনির্দিষ্ট নিয়ম
অস্পষ্ট
Is this comment good? Answer yes or no.কার জন্য ভালো? ডেটাবেস সম্পর্কে একটি দীর্ঘ, ভদ্র কমেন্ট "হ্যাঁ" ফেরত আসতে পারে যখন একটি ছোট "এটি দেখুন: <লিঙ্ক>" "না" ফেরত আসে। মডেলকে অনুমান করতে হয় আপনি কী বোঝাতে চেয়েছেন, এবং এর অনুমান কমেন্ট থেকে কমেন্টে পরিবর্তিত হয়।
সুনির্দিষ্ট
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.এখন মডেলের কাছে অনুমান করার মেজাজের বদলে একটি নিয়ম আছে: কী গণনা করা হয়, কী হয় না, এবং উত্তরটি কেমন দেখায়।
বলুন তিনটি কমেন্ট আসে। এগুলো আপনার লক্ষ্য করা উত্তর:
- "Unix-এর ইতিহাসের এই টকটি শেল সম্পর্কে আমার দৃষ্টিভঙ্গি বদলে দিয়েছে: youtube.com/watch?v=... ঘণ্টাটি মূল্যবান।" →
keep - "এখানে সস্তা ঘড়ি!!! আমার প্রোফাইলে ক্লিক করুন" →
drop - "সম্মত, ক্যাশিং সম্পর্কে দুর্দান্ত পয়েন্ট।" →
drop
তিনটি অভ্যাস প্রম্পটকে ৪০,০০০ আইটেম জুড়ে টিকিয়ে রাখে। বাকি কেসগুলোতে কী করতে হবে তা বলুন ("বাকি সব বাদ দিন"); নাহলে মডেল একটি তৃতীয় উত্তর উদ্ভাবন করে। এক শব্দ চান, যাতে উত্তরটি কোডে keep-এর সাথে তুলনা করা সহজ হয়। এবং কমেন্টটি ট্যাগে মুড়ে দিন, নিচের লুপের মতো: যে কমেন্ট বলে "উপরের নির্দেশনাগুলো উপেক্ষা করুন" তখন স্পষ্টভাবে ডেটা, আদেশ নয়। প্রম্পটে প্রতিটি ডকুমেন্ট লেবেল করুন এ বিষয়ে আরও গভীরে যায়।
লুপ: প্রতি কমেন্টে একটি রিকোয়েস্ট#
এখানে পুরো জিনিসটি। এটি comments.jsonl পড়ে (প্রতি লাইনে একটি text ফিল্ড সহ একটি JSON অবজেক্ট), প্রতিটি কমেন্টের উপর একটি রায় চায়, এবং রাখা লাইনগুলো kept.jsonl-এ লেখে। মডেল আইডি হলো সম্পূর্ণ gateway_id; কীটি একটি এনভায়রনমেন্ট ভেরিয়েবল থেকে আসে।
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 রায়গুলোকে রানগুলোর মধ্যে আরও পুনরাবৃত্তিযোগ্য করে, এবং max_tokens=10 একটি শব্দের জন্য জায়গা রাখে এবং আর কিছু না। শেষ লাইনটি দরকারি: এটি API যে usage সংখ্যাগুলো ফেরত দেয় তা যোগ করে, তাই আপনি অনুমানের বদলে আপনার প্রকৃত টোকেন সংখ্যা পান।
প্রথম দশটি কমেন্টে এটি চালান এবং প্রতিটি রায় নিজে পড়ুন। যদি কোনো উত্তর কাটা মনে হয় বা খালি ফেরত আসে, কেন একটি AI উত্তর মাঝবাক্যে থেমে যায়-এ বর্ণিত finish_reason পরীক্ষা করুন। পরীক্ষার জন্য একবারে একটি রিকোয়েস্ট ঠিক আছে; সম্পূর্ণ ৪০,০০০-এর জন্য, AsyncOpenAI অনেকগুলো সমান্তরালে পাঠায়।
৪০,০০০ কমেন্টের খরচ#
এখানে অনুমানগুলো, যাতে আপনি নিজেরটা বসাতে পারেন। একটি কমেন্ট প্লাস নির্দেশনা প্রায় ১৫০ টোকেন ইনপুট। উত্তর প্রায় ৫ টোকেন। Hacker News কমেন্ট প্রায়ই দীর্ঘ হয়, তাই ১৫০-কে ন্যূনতম ধরুন এবং এটি রিহার্সাল সংখ্যা দিয়ে প্রতিস্থাপন করুন। ৪০,০০০ কমেন্টের জন্য:
- ইনপুট: ৪০,০০০ × ১৫০ = ৬,০০০,০০০ টোকেন
- আউটপুট: ৪০,০০০ × ৫ = ২০০,০০০ টোকেন
নির্দেশনাটি হলো সেই অংশ যা মানুষ ভুলে যায়। এটি প্রতিটি কমেন্টের সাথে যায়। একটি অনুমান চেষ্টা করুন:
সংখ্যা অনুমান করুন
বলুন আপনার নির্দেশনা ৬০ টোকেন লম্বা। এর ৪০,০০০ কপি মিলে কত ইনপুট টোকেন হয়?
আপনার অনুমান
০৬০,০০,০০০
উত্তর দেখান
উত্তর: ২৪,০০,০০০
৪০,০০০ × ৬০ = ২,৪০০,০০০। এটি ৬,০০০,০০০ ইনপুট টোকেনের ৪০%, এমন টেক্সটে ব্যয় হয় যা কখনো বদলায় না, তাই আরও সংক্ষিপ্ত নির্দেশনা প্রথমে ছাঁটার জিনিস।
এখন লাইভ মূল্যে পুরো পাসের বিল:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ৪০,০০০টি অনুরোধ | OpenRouter, ৪০,০০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
প্রতি অনুরোধে ১৫০ ইনপুট এবং ৫ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
এই ওয়ার্কলোডে, DeepSeek-V4-Flash এবং GLM-5.3-Flash উভয়ই মোটে OpenRouter-এর চেয়ে সস্তা, ইনপুট এবং আউটপুট একসাথে গণনা করে; OpenRouter কলামটি পাশাপাশি দেখায়। উভয়ই এই ধরনের উচ্চ-ভলিউম কাজের জন্য মূল্য নির্ধারিত: DeepSeek-V4-Flash-এর যেকোনো সময়ে একই মূল্য এবং প্রতি উত্তরে ৩২,৭৬৮ আউটপুট টোকেন পর্যন্ত, GLM-5.3-Flash একই এন্ডপয়েন্টে দ্বিতীয় বিকল্প। প্রতিটিতে আপনার ৫০-কমেন্ট রিহার্সাল চালান এবং রায়গুলো নিজে তুলনা করুন। পরিবর্তন করতে, মডেল লাইনটি zai--এ বদলান। প্রতিটি মডেলের বর্তমান মূল্য মূল্য পৃষ্ঠা-এ, এবং CheapTokens-এ DeepSeek মডেল বিস্তারিত তালিকা দেয়।
নিজে চেষ্টা করুনচেষ্টা করুন: আপনার আর্কাইভে ৪০,০০০ নয়, ১০০,০০০ কমেন্ট আছে। কী বদলায়?উত্তর দেখান
বিলটি সংখ্যার সাথে সাথে বাড়ে। ১০০,০০০ × ১৫০ = ১৫,০০০,০০০ ইনপুট টোকেন এবং ১০০,০০০ × ৫ = ৫০০,০০০ আউটপুট টোকেন, যা DeepSeek-V4-Flash-এ $0.275। একই প্রম্পট, ২.৫ গুণ আইটেম, ২.৫ গুণ খরচ।
চালানোর আগে#
প্রথমে, একটি রিহার্সাল। ৫০টি কমেন্ট নিন, লুপ চালান, এবং সব ৫০টি রায় পড়ুন। তারপর মুদ্রিত টোকেন মোট ব্যবহার করুন: ৫০ × ৮০০ = ৪০,০০০, তাই সম্পূর্ণ রান হলো রিহার্সালের টোকেন × ৮০০। এটি ১৫০-এবং-৫ অনুমানকে আপনার নিজের সংখ্যা দিয়ে প্রতিস্থাপন করে।
দ্বিতীয়ত, প্রম্পটটি রিহার্সালে ঠিক করুন, সম্পূর্ণ রানে নয়। যদি তিনটি "বাদ দিন" রায় ভুল হয়, সেই কেস সম্পর্কে একটি বাক্য যোগ করুন এবং ৫০টি পুনরায় চালান। এখানে বাছাই করা এক সেন্টের ভগ্নাংশ খরচ করে, এবং ৪০,০০০ পুনরায় চালাতে অনেক বেশি।
তৃতীয়ত, মনে রাখবেন মডেল কী দেখে: একটি কমেন্ট, কোনো থ্রেড নয়। যদি "সম্মত, দুর্দান্ত পয়েন্ট" শুধুমাত্র প্যারেন্ট কমেন্টের পাশে অর্থবহ হয়, প্যারেন্টটিও রিকোয়েস্টে রাখুন। এটি প্রতিটি রিকোয়েস্টকে দীর্ঘ করে, তাই নতুন আকার দিয়ে টোকেন গণিত পুনরায় করুন।
যখন রিহার্সাল ঠিক মনে হয়, আপনার অ্যাকাউন্টে একটি API কী তৈরি করুন, CHEAPTOKENS_-কে এটির দিকে নির্দেশ করুন এবং সম্পূর্ণ পাস শুরু করুন। যদি কীটি আপনার কাছে নতুন হয়, একটি API কী কী এবং এটি কীভাবে সংরক্ষণ করবেন পাঁচ মিনিট নেয়।


