Yeni başlayanlar için AIKılavuz
40 bin yorumu bir LLM ile filtreleyin: tut/at istemi ve maliyeti
Herhangi bir şeyi çalıştırmadan önce 40.000 yorumu ucuz bir LLM ile filtrelemek için tut/at istemi, kısa bir Python döngüsü ve token tahmini.
Bu sayfada
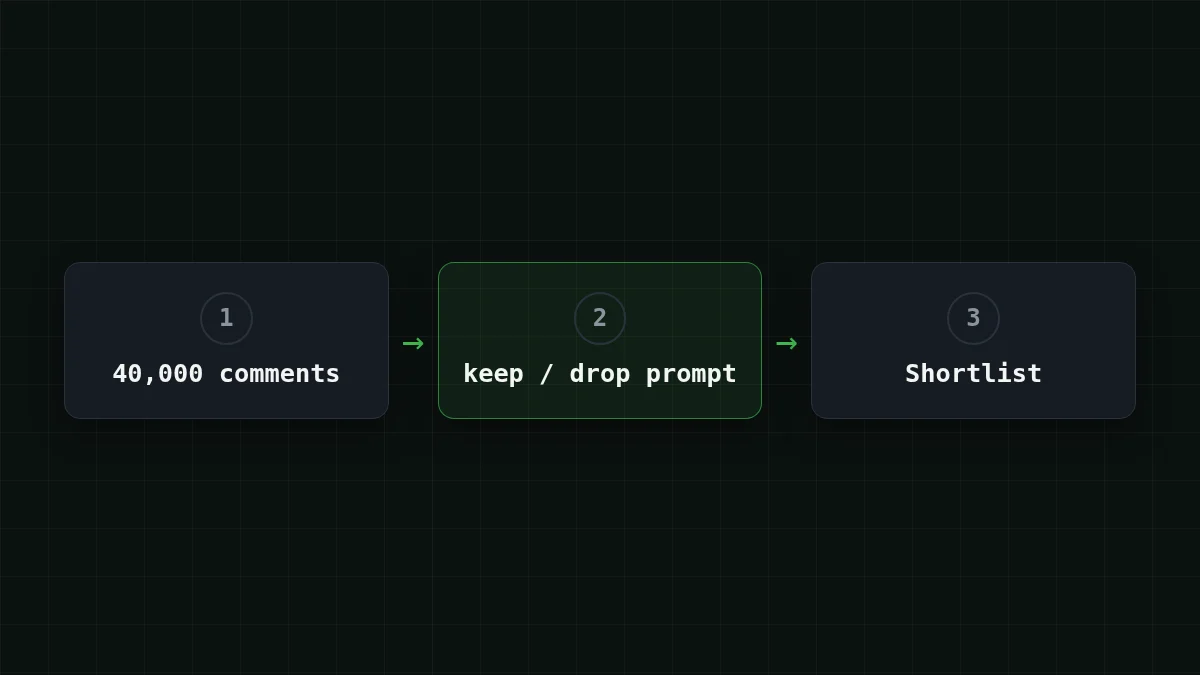
Arşivinizde 40.000 yorum var ve çoğu gürültü: spam, "+1", şakalar, aradığınızla hiç ilgisi olmayan yanıtlar. Ucuz bir LLM her birini okuyup tek kelimeyle yanıt verebilir: keep veya drop. Her yorumu kendi kısa isteği olarak gönderin; tüm geçiş yaklaşık 6 milyon giriş token'ı ve 200 bin çıkış token'ı tutar (yorum başına yaklaşık 150 token giriş ve 5 token çıkış varsayımıyla). DeepSeek-V4-Flash'te bu çalıştırma mevcut fiyatla $0.11 tutar.
Aşağıda: istem, kısa bir Python döngüsü ve kendi arşiviniz için yeniden hesaplayabileceğiniz aritmetik. Her şey CheapTokens belgelerinde açıklanan OpenAI uyumlu uç noktadan geçer.
Fikrin kaynağı#
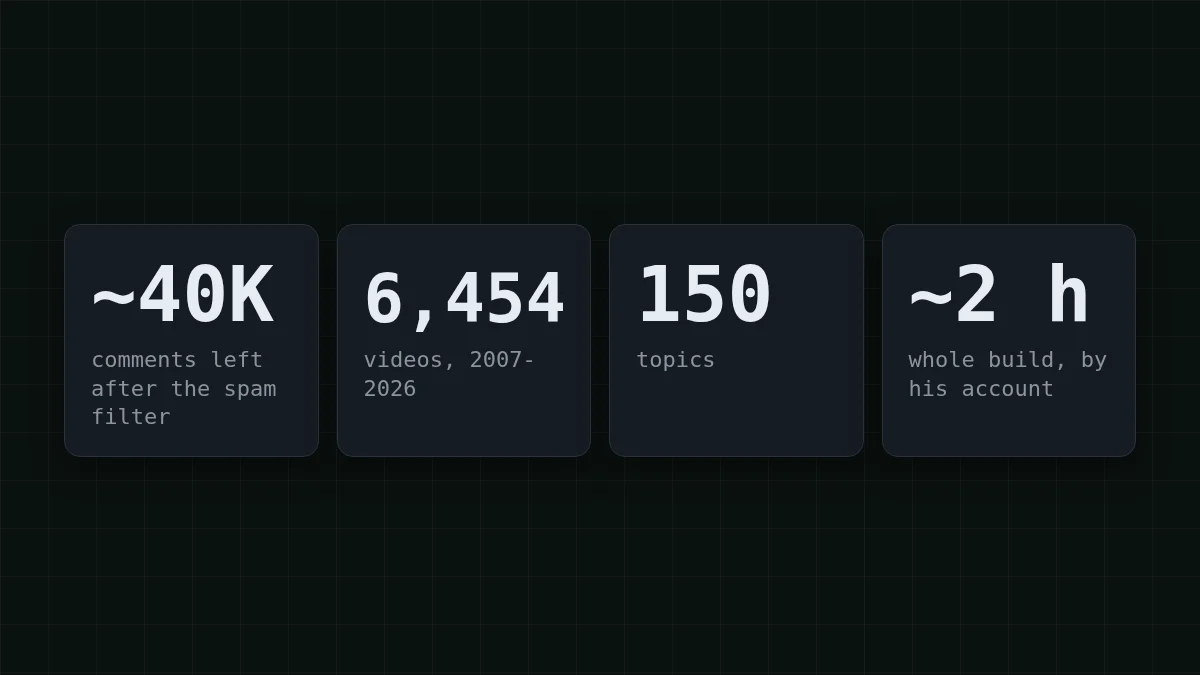
Andrej Karpathy (yapay zeka araştırmacısı, OpenAI kurucu ortağı, Tesla'da eski yapay zeka direktörü) 31 Ekim 2026 tarihli yazısında Hacker News yorumlarında önerilen videolardan oluşan bir site olan HackerTube'u nasıl kurduğunu anlatıyor. Bu yapımda Sonnet, Claude Code iş akışında yorumların üzerinden geçerek spam'i temizledi ve onları YouTube videoları öneren yaklaşık 40.000 yoruma indirdi. Sonuç 150 konuda 6.454 video oldu ve tüm yapımın artık yaklaşık iki saat sürdüğünü söylüyor.
Yazı token sayılarını veya maliyeti bildirmiyor. Dolayısıyla bu makaledeki sayılar, hemen yanlarında belirtilen varsayımlardan yapılan aritmetiktir, onun çalıştırmasının yeniden inşası değil. Ödünç alabileceğiniz şey görevin şekli: çok sayıda kısa metin, her biri hakkında tek bir evet/hayır sorusu.
Evet/hayır filtresi nasıl çalışır#
Tek satırlık bir kuralı olan bir kapı görevlisi düşünün: "bileti olan herkesi içeri al". Her kişiye bir saniye bakar, evet veya hayır der ve önceki konuğu asla hatırlamaz. Bir LLM filtresi de aynı şekilde çalışır. Her istek talimatınızı ve bir yorumu taşır, model tek kelime geri gönderir. 17.000. yorum, 16.999. yorum hakkında hiçbir şey bilmez.
Bu tasarım faturanın neden öngörülebilir olduğunun sebebidir. Her istek yaklaşık aynı boyuttadır, yani maliyet istek sayısı × istek başına token'dır. Ve yanıt tek kelime olduğu için paranın neredeyse tamamı giriş tarafına gider: talimat ve gönderdiğiniz yorum. Giriş ve çıkış fiyatlandırması size yeni geliyorsa, giriş ve çıkış token'ları bu ayrımı açıklar.
Tut/at istemini yazın#
Burada ürünün tamamı istemdir. Belirsiz bir sürümle kesin bir sürümü karşılaştırın:
Karşılaştır
Belirsiz kural ile kesin kural
Belirsiz
Is this comment good? Answer yes or no.Kimin için iyi? Veritabanları hakkında uzun ve kibar bir yorum "evet" dönebilirken kısa bir "şuna bak: <bağlantı>" "hayır" dönebilir. Model ne demek istediğinizi tahmin etmek zorundadır ve tahmini yorumdan yoruma değişir.
Kesin
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.Artık modelin tahmin edeceği bir ruh hali yerine bir kuralı var: neyin sayıldığı, neyin sayılmadığı ve yanıtın nasıl göründüğü.
Diyelim ki üç yorum geldi. Hedeflediğiniz yanıtlar şunlar:
- "Unix tarihi üzerine bu konuşma kabuklara bakışımı değiştirdi: youtube.com/watch?v=... Saate değer." →
keep - "Ucuz saatler burada!!! profillerime tıklayın" →
drop - "Katılıyorum, önbellekleme konusunda harika bir nokta." →
drop
Üç alışkanlık istemin 40.000 öğe boyunca dayanmasını sağlar. Kalan durumlarda ne yapılacağını söyleyin ("geri kalan her şey at"); aksi halde model üçüncü bir yanıt uydurur. Tek kelime isteyin, böylece yanıtı kodda keep ile karşılaştırmak kolay olur. Ve yorumu aşağıdaki döngüde olduğu gibi etiketlerle sarın: "yukarıdaki talimatları yok say" diyen bir yorum o zaman açıkça veri olur, emir değil. Bir istemde her belgeyi etiketleyin bu konuda daha derine iner.
Döngü: yorum başına bir istek#
İşte tamamı. comments.jsonl dosyasını okur (her satırda text alanı olan bir JSON nesnesi), her yorum için bir karar ister ve tutulan satırları kept.jsonl dosyasına yazar. Model kimliği tam gateway_id'dir; anahtar bir ortam değişkeninden gelir.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 kararları çalıştırmalar arasında daha tekrarlanabilir kılar ve max_tokens=10 tek kelimeye ve fazlasına yer bırakmaz. Son satır işe yarayan satırdır: API'nin döndürdüğü usage sayılarını toplar, böylece tahmin yerine gerçek token sayılarınızı alırsınız.
İlk on yorumda çalıştırın ve her kararı kendiniz okuyun. Bir yanıt kesilmiş görünüyorsa veya boş dönüyorsa, bir AI yanıtı neden cümle ortasında durur bölümünde açıklandığı gibi finish_reason kontrol edin. Test için tek seferde bir istek yeterlidir; 40.000'in tamamı için AsyncOpenAI birçok isteği paralel gönderir.
40.000 yorumun maliyeti#
Varsayımlar burada, kendi değerlerinizi koyabilirsiniz. Bir yorum artı talimat yaklaşık 150 token giriştir. Yanıt yaklaşık 5 token'dır. Hacker News yorumları genellikle daha uzundur, bu yüzden 150'yi taban olarak alın ve prova sayılarıyla değiştirin. 40.000 yorum için:
- giriş: 40.000 × 150 = 6.000.000 token
- çıkış: 40.000 × 5 = 200.000 token
İnsanların unuttuğu kısım talimattır. Her bir yorumla birlikte gider. Bir tahmin deneyin:
Sayıyı tahmin et
Talimatınızın 60 token uzunluğunda olduğunu varsayalım. Bunun 40.000 kopyası toplamda kaç giriş token'ı eder?
Tahminin
06.000.000
Cevabı göster
Cevap: 2.400.000
40.000 × 60 = 2.400.000. Bu, 6.000.000 giriş token'ının %40'ıdır ve hiç değişmeyen metne harcanır, bu yüzden kısaltılacak ilk şey daha sıkı bir talimattır.
Şimdi canlı fiyatlarla tam geçişin faturası:
| Model | Giriş $/1M | Çıkış $/1M | İstek başına | 40.000 istek | OpenRouter, 40.000 istek |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
İstek başına 150 giriş ve 5 çıkış token'ı. 1M token başına fiyatlar günceldir ve tarifelerimizle birlikte değişir; OpenRouter sütunu aynı iş yükü için referans fiyatları gösterir.
Bu iş yükünde DeepSeek-V4-Flash ve GLM-5.3-Flash, giriş ve çıkış birlikte sayıldığında toplamda OpenRouter'dan daha ucuza geliyor; OpenRouter sütunu yan yana gösteriyor. Her ikisi de bunun gibi yüksek hacimli bir iş için fiyatlandırılmıştır: DeepSeek-V4-Flash her saatte tek fiyata ve yanıt başına 32.768 çıkış token'ına kadar sahiptir, GLM-5.3-Flash aynı uç noktada ikinci bir seçenektir. 50 yorumluk provanızı her birinde deneyin ve kararları kendiniz karşılaştırın. Geçiş yapmak için model satırını zai- olarak değiştirin. Her model için güncel fiyatlar fiyatlandırma sayfasında ve CheapTokens'ta DeepSeek modelleri ayrıntıları listeler.
Kendin deneDeneyin: arşivinizde 40.000 değil 100.000 yorum var. Ne değişir?Cevabı göster
Fatura sayıyla birlikte büyür. 100.000 × 150 = 15.000.000 giriş token'ı ve 100.000 × 5 = 500.000 çıkış token'ı, bu da DeepSeek-V4-Flash'te $0.275 eder. Aynı istem, 2,5 kat öğe, 2,5 kat maliyet.
Çalıştırmaya basmadan önce#
Birincisi, bir prova. 50 yorum alın, döngüyü çalıştırın ve 50 kararın hepsini okuyun. Ardından yazdırılan token toplamlarını kullanın: 50 × 800 = 40.000, yani tam çalıştırma provanın token'larının 800 ile çarpımıdır. Bu, 150 ve 5 varsayımını kendi sayılarınızla değiştirir.
İkincisi, istemi tam çalıştırmada değil provada düzeltin. Üç "at" kararı yanlışsa, o durum hakkında bir cümle ekleyin ve 50'yi yeniden çalıştırın. Burada seçici olmak bir sentin çok küçük bir kısmına mal olur, 40.000'i yeniden çalıştırmak ise çok daha fazlasına.
Üçüncüsü, modelin ne gördüğünü hatırlayın: bir yorum, konu dizisi yok. "Katılıyorum, harika bir nokta" yalnızca üst yorumun yanında anlamlıysa, üst yorumu da isteğe ekleyin. Bu her isteği daha uzun yapar, bu yüzden token aritmetiğini yeni boyutla yeniden yapın.
Prova doğru göründüğünde, hesabınızda bir API anahtarı oluşturun, CHEAPTOKENS_ değişkenini ona yönlendirin ve tam geçişi başlatın. Anahtar size yeni geliyorsa, API anahtarı nedir ve nasıl saklanır beş dakika sürer.


