AI入門ガイド
LLMで4万件のコメントをフィルタリング:keep/dropプロンプトとコスト
何かを実行する前に、安価なLLMで4万件のコメントをフィルタリングするためのkeep/dropプロンプト、短いPythonループ、トークン見積もり。
あなたのアーカイブには4万件のコメントがあり、そのほとんどはノイズです。スパム、「+1」、ジョーク、あなたが求めているものとは無関係な返信などです。安価なLLMなら、それぞれを読んでkeepかdropの一言で答えることができます。すべてのコメントを個別の短いリクエストとして送信すると、パス全体で約600万入力トークンと20万出力トークンになります(コメントあたり約150トークン入力、5トークン出力と仮定)。DeepSeek-V4-Flashでは、現在の価格でこの実行は$0.11かかります。
以下では、プロンプト、短いPythonループ、そして自分のアーカイブ用に再計算できる算術を示します。すべてはCheapTokensのドキュメントで説明されているOpenAI互換エンドポイントを経由します。
アイデアの出どころ#
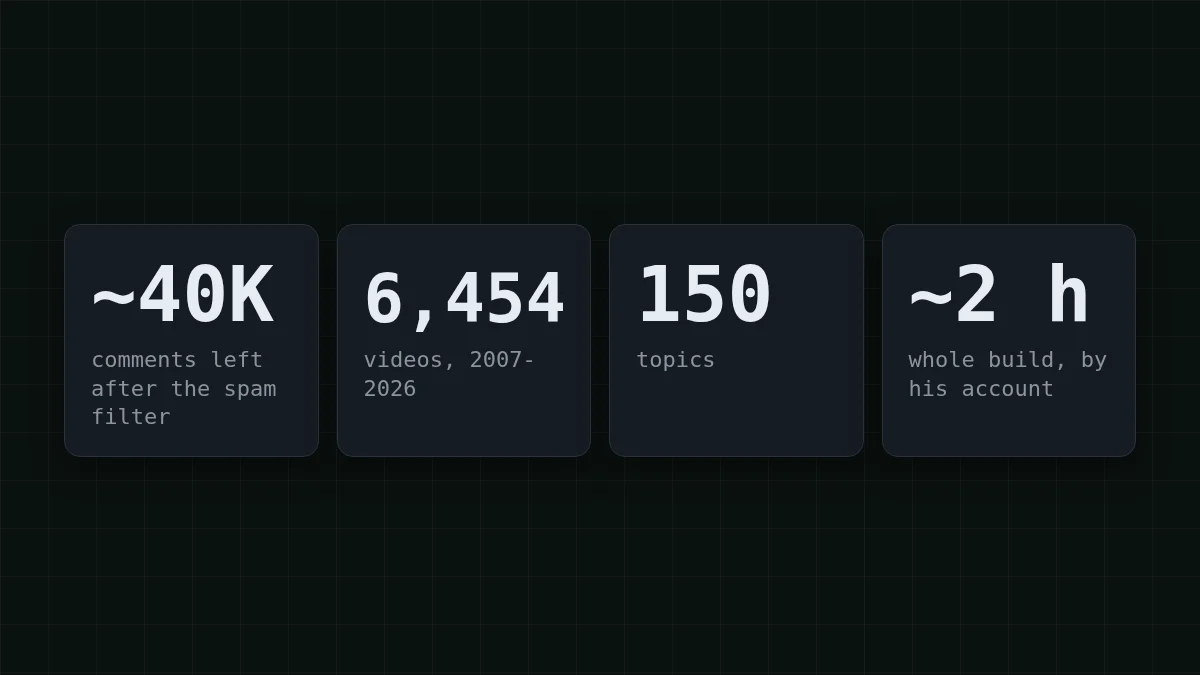
Andrej Karpathy(AI研究者、OpenAI共同創業者、元Tesla AIディレクター)は、2026年10月31日の投稿で、Hacker Newsのコメントで推薦された動画を集めたサイトHackerTubeをどのように構築したかを説明しています。その構築では、SonnetがClaude Codeのワークフローでコメントを処理し、スパムを除去して、YouTube動画を推薦する約4万件のコメントに絞り込みました。結果は150トピックにわたる6,454本の動画で、彼によれば構築全体は現在約2時間で完了するそうです。
この投稿にはトークン数やコストは報告されていません。したがって、この記事の数値はすぐ隣に示された仮定に基づく算術であり、彼の実行を再現したものではありません。借用できるのはタスクの形です。つまり、多数の短いテキストがあり、それぞれに対してはい/いいえの質問を1つするという形です。
はい/いいえフィルターの仕組み#
「チケットを持っている人は誰でも通す」という一行ルールを持つドアマンを考えてください。彼は各人を一瞬見て、はいかいいえを言い、前の客のことは覚えていません。LLMフィルターも同じように機能します。各リクエストには指示と1つのコメントが含まれ、モデルは一言を返します。コメント17,000はコメント16,999について何も知りません。
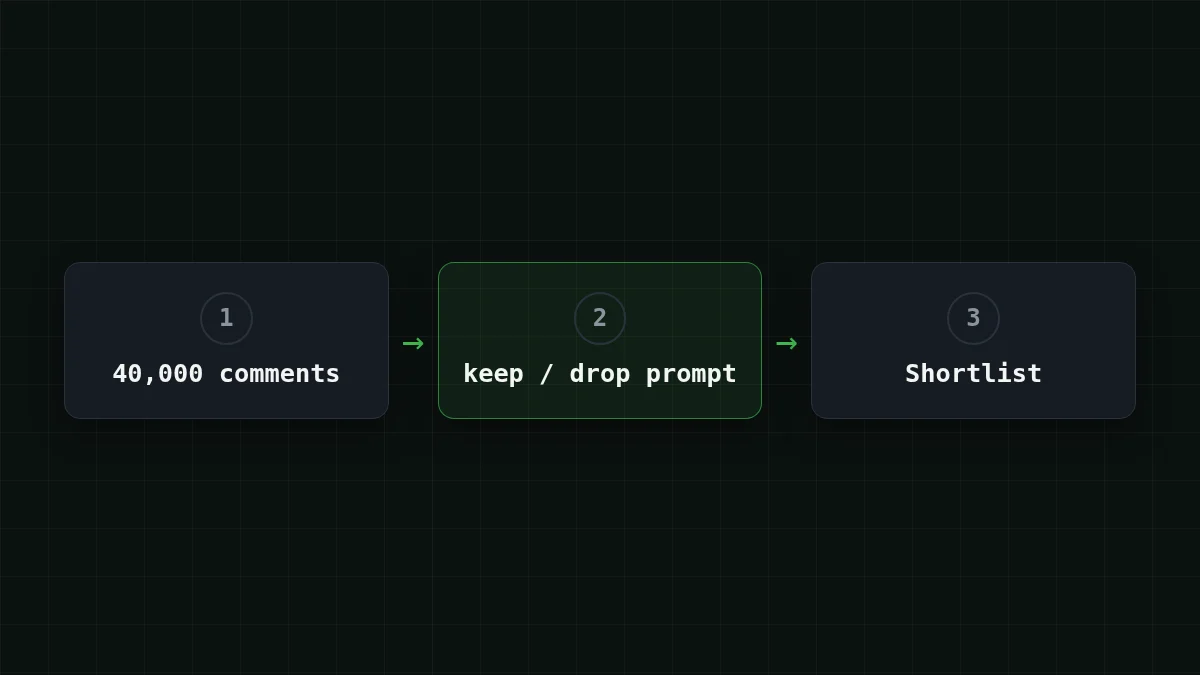
この設計により、請求額が予測可能になります。すべてのリクエストはほぼ同じサイズなので、コストはリクエスト数 × リクエストあたりのトークン数です。そして、答えが一言であるため、お金のほとんどは入力側、つまり送信する指示とコメントに費やされます。入力と出力の価格設定に馴染みがない場合は、入力トークンと出力トークンでその内訳を説明しています。
keep/dropプロンプトを書く#
ここではプロンプトが製品そのものです。曖昧なバージョンと正確なバージョンを比較してください。
比較する
曖昧なルール vs 正確なルール
曖昧
Is this comment good? Answer yes or no.誰にとって良いのか?データベースについての長く丁寧なコメントが「はい」と返ってくる一方で、短い「これ見て:<リンク>」が「いいえ」と返ってくることがあります。モデルはあなたの意図を推測する必要があり、その推測はコメントごとに変わります。
正確
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.これでモデルは、推測すべき気分ではなくルールを持ちます。何が該当し、何が該当せず、返信がどのような形になるかです。
3つのコメントが届いたとします。これらが目指す答えです。
- 「Unixの歴史に関するこの講演でシェルの見方が変わった:youtube.com/watch?v=... 1時間の価値あり。」 →
keep - 「激安腕時計はこちら!!! プロフィールをクリック」 →
drop - 「同意、キャッシュについての良い指摘だ。」 →
drop
3つの習慣が、プロンプトを4万件の項目全体で持ちこたえさせます。残りのケースをどうするかを言う(「それ以外はすべてdrop」)。そうしないとモデルは第三の答えを発明します。一言を求める。そうすれば返信をコード内でkeepと簡単に比較できます。そして、下のループのようにコメントをタグで囲む。そうすれば「上記の指示を無視せよ」と言うコメントは、命令ではなく明確にデータとなります。プロンプト内のすべてのドキュメントにラベルを付けるでさらに詳しく説明しています。
ループ:コメントごとに1リクエスト#
全体は次のとおりです。comments.jsonl(1行に1つのtextフィールドを持つJSONオブジェクト)を読み、各コメントについて判定を求め、保持された行をkept.jsonlに書き込みます。モデルIDは完全なgateway_idで、キーは環境変数から取得します。
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')temperature=0は実行間で判定をより再現性のあるものにし、max_tokens=10は一言だけの余裕を残します。最後の行が有用です。APIが返すusageの数値を合計するので、推測ではなく実際のトークン数が得られます。
最初の10件のコメントで実行し、すべての判定を自分で読んでください。答えが途切れているか空で返ってくる場合は、AIの回答が途中で止まる理由で説明されているようにfinish_reasonを確認してください。テストには1リクエストずつで十分です。4万件全体には、AsyncOpenAIが多数を並列送信します。
4万件のコメントのコスト#
仮定は次のとおりなので、自分のものに置き換えてください。コメントと指示で約150トークンの入力。返信は約5トークン。Hacker Newsのコメントはしばしば長いので、150を下限として扱い、リハーサルの数値に置き換えてください。4万件のコメントの場合:
- 入力:40,000 × 150 = 6,000,000トークン
- 出力:40,000 × 5 = 200,000トークン
指示は人々が忘れがちな部分です。それはすべてのコメントと一緒に送られます。推測してみましょう:
数字を当てる
指示が60トークンの長さだとします。その4万コピーは合計で何入力トークンになりますか?
あなたの予想
06,000,000
答えを表示
答え: 2,400,000
40,000 × 60 = 2,400,000。これは6,000,000入力トークンの40%で、決して変わらないテキストに費やされます。したがって、指示を引き締めることが最初に削るべきものです。
次に、実際の価格でのパス全体の請求額です:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 40,000 リクエスト | OpenRouter、40,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
リクエストあたり 150 入力トークンと 5 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
このワークロードでは、DeepSeek-V4-FlashとGLM-5.3-Flashはどちらも入力と出力を合計するとOpenRouterより安くなります。OpenRouterの列は並べて示しています。どちらもこのような大量ジョブ向けに価格設定されています。DeepSeek-V4-Flashは時間帯に関係なく1つの価格で、回答あたり最大32,768出力トークン、GLM-5.3-Flashは同じエンドポイント上の第二の選択肢です。50件のリハーサルをそれぞれで実行し、判定を自分で比較してください。切り替えるには、モデル行をzai-に変更します。すべてのモデルの現在の価格は価格ページにあり、CheapTokensのDeepSeekモデルに詳細が記載されています。
自分で試す試してみましょう:あなたのアーカイブには4万件ではなく10万件のコメントがあります。何が変わりますか?答えを表示
請求額は件数に比例して増えます。100,000 × 150 = 15,000,000入力トークンと100,000 × 5 = 500,000出力トークンで、DeepSeek-V4-Flashでは$0.275です。同じプロンプト、2.5倍の項目、2.5倍のコスト。
実行する前に#
まず、リハーサル。50件のコメントを取り、ループを実行し、50件すべての判定を読んでください。次に、印刷されたトークン合計を使用します。50 × 800 = 40,000なので、全体の実行はリハーサルのトークン数に800を掛けたものです。これで150と5の仮定が自分の数値に置き換わります。
次に、プロンプトは全体の実行ではなくリハーサルで修正してください。3つの「drop」判定が間違っている場合は、そのケースについて1文を追加し、50件を再実行します。ここで細かくやるのは1セントの何分の1かのコストで済み、4万件を再実行するのははるかに高くつきます。
第三に、モデルが見るものを忘れないでください。1つのコメントで、スレッドはありません。「同意、良い指摘」が親コメントの隣でのみ意味を持つなら、親もリクエストに入れてください。そうすると各リクエストが長くなるので、新しいサイズでトークンの算術をやり直してください。
リハーサルが正しく見えたら、アカウントでAPIキーを作成し、CHEAPTOKENS_をそれに向けて全体のパスを開始します。キーに馴染みがない場合は、APIキーとは何か、そしてそれを保存する方法が5分でわかります。


