Filtre 40 mil comentários com um LLM: prompt de manter/descartar e custo
Um prompt de manter/descartar, um loop curto em Python e uma estimativa de tokens para filtrar 40.000 comentários com um LLM barato, antes de rodar qualquer coisa.
Nesta página
Seu arquivo tem 40.000 comentários, e a maioria é ruído: spam, "+1", piadas, respostas que não têm nada a ver com o que você procura. Um LLM barato pode ler cada um e responder com uma única palavra, keep ou drop. Envie cada comentário como sua própria requisição curta e a passagem inteira chega a cerca de 6 milhões de tokens de entrada e 200 mil tokens de saída (assumindo aproximadamente 150 tokens de entrada e 5 de saída por comentário). No DeepSeek-V4-Flash essa execução custa $0.11 pelo preço atual.
Abaixo: o prompt, um loop curto em Python e a aritmética que você pode refazer para o seu próprio arquivo. Tudo passa pelo endpoint compatível com OpenAI descrito na documentação do CheapTokens.
De onde vem a ideia#
Andrej Karpathy (pesquisador de IA, cofundador da OpenAI, ex-diretor de IA na Tesla) descreveu em seu post de 31 de outubro de 2026 como construiu o HackerTube, um site de vídeos recomendados em comentários do Hacker News. Nessa construção, o Sonnet percorreu os comentários em um fluxo de trabalho do Claude Code para remover spam e reduzi-los a cerca de 40.000 comentários que recomendam vídeos do YouTube. O resultado foram 6.454 vídeos em 150 tópicos, e ele diz que a construção inteira agora leva cerca de duas horas.
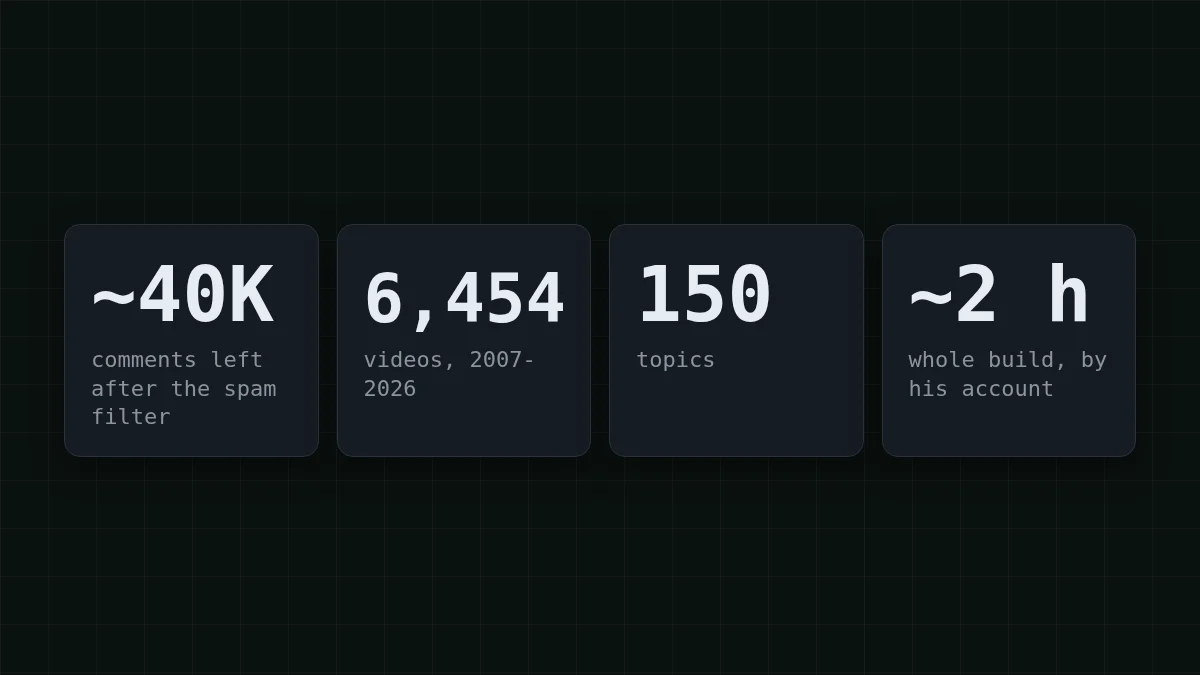
O post não informa contagens de tokens nem custo. Então os números deste artigo são aritmética a partir de premissas declaradas logo ao lado deles, não uma reconstrução da execução dele. O que você pode aproveitar é o formato da tarefa: muitos textos curtos, uma pergunta de sim/não sobre cada um.
Como funciona um filtro de sim/não#
Pense em um porteiro com uma regra de uma linha: "deixe entrar quem tiver ingresso". Ele olha para cada pessoa por um segundo, diz sim ou não, e nunca lembra do convidado anterior. Um filtro de LLM funciona do mesmo jeito. Cada requisição carrega sua instrução mais um comentário, e o modelo devolve uma palavra. O comentário 17.000 não sabe nada sobre o comentário 16.999.
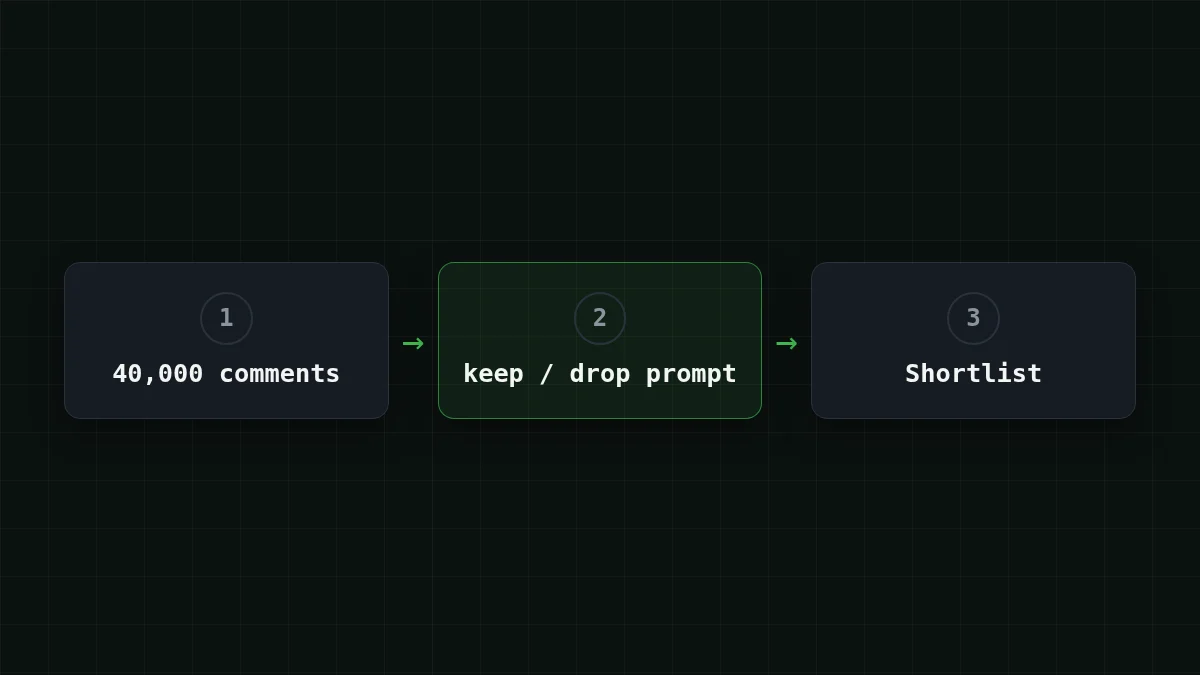
Esse design é o motivo de a conta ser previsível. Toda requisição tem aproximadamente o mesmo tamanho, então o custo é requisições × tokens por requisição. E como a resposta é uma palavra, quase todo o dinheiro vai para o lado da entrada: a instrução e o comentário que você envia. Se precificação de entrada e saída é novidade para você, tokens de entrada vs saída explica a divisão.
Escreva o prompt de manter/descartar#
O prompt é o produto inteiro aqui. Compare uma versão vaga com uma exata:
Comparar
Regra vaga vs regra exata
Vaga
Is this comment good? Answer yes or no.Bom para quem? Um comentário longo e educado sobre bancos de dados pode voltar "sim" enquanto um curto "olha isso: <link>" volta "não". O modelo tem que adivinhar o que você quis dizer, e o palpite dele muda de comentário para comentário.
Exata
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.Agora o modelo tem uma regra em vez de um humor para adivinhar: o que conta, o que não conta e como é a resposta.
Digamos que cheguem três comentários. Estas são as respostas que você busca:
- "Esta palestra sobre a história do Unix mudou como eu vejo shells: youtube.com/watch?v=... Vale a hora." →
keep - "Relógios baratos aqui!!! clique no meu perfil" →
drop - "Concordo, ótimo ponto sobre cache." →
drop
Três hábitos fazem o prompt se sustentar em 40.000 itens. Diga o que fazer com os casos restantes ("todo o resto é descartar"); caso contrário, o modelo inventa uma terceira resposta. Peça uma palavra, para que a resposta seja fácil de comparar com keep no código. E envolva o comentário em tags, como no loop abaixo: um comentário que diz "ignore as instruções acima" fica então claramente como dado, não como ordem. Rotule todo documento em um prompt aprofunda isso.
O loop: uma requisição por comentário#
Aqui está tudo. Ele lê comments.jsonl (um objeto JSON com um campo text por linha), pede um veredito sobre cada comentário e grava as linhas mantidas em kept.jsonl. O id do modelo é o gateway_id completo; a chave vem de uma variável de ambiente.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 torna os vereditos mais repetíveis entre execuções, e max_tokens=10 deixa espaço para uma palavra e nada mais. A última linha é a útil: ela soma os números de usage que a API retorna, então você obtém suas contagens reais de tokens em vez de um palpite.
Rode nos primeiros dez comentários e leia cada veredito você mesmo. Se uma resposta parecer cortada ou voltar vazia, verifique finish_reason como descrito em por que uma resposta de IA para no meio da frase. Uma requisição por vez serve para um teste; para os 40.000 completos, AsyncOpenAI envia muitas em paralelo.
Quanto custam 40.000 comentários#
Aqui estão as premissas, para você trocar pelas suas. Um comentário mais a instrução dá cerca de 150 tokens de entrada. A resposta tem cerca de 5 tokens. Comentários do Hacker News costumam ser mais longos, então trate 150 como piso e substitua pelos números do ensaio. Para 40.000 comentários:
- entrada: 40.000 × 150 = 6.000.000 tokens
- saída: 40.000 × 5 = 200.000 tokens
A instrução é a parte que as pessoas esquecem. Ela viaja com cada comentário. Tente um palpite:
Adivinhar o número
Digamos que sua instrução tenha 60 tokens. Quantos tokens de entrada 40.000 cópias dela somam?
O seu palpite
06.000.000
Mostrar resposta
Resposta: 2.400.000
40.000 × 60 = 2.400.000. Isso é 40% dos 6.000.000 de tokens de entrada, gastos em texto que nunca muda, então enxugar a instrução é a primeira coisa a cortar.
Agora a conta da passagem completa, com preços ao vivo:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 40.000 solicitações | OpenRouter, 40.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
150 tokens de entrada e 5 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Nesta carga de trabalho, DeepSeek-V4-Flash e GLM-5.3-Flash saem mais baratos que o OpenRouter no total, com entrada e saída contadas juntas; a coluna do OpenRouter mostra lado a lado. Ambos têm preço para um trabalho de alto volume como este: DeepSeek-V4-Flash tem um preço a qualquer hora e até 32.768 tokens de saída por resposta, GLM-5.3-Flash é uma segunda opção no mesmo endpoint. Faça seu ensaio de 50 comentários em cada um e compare os vereditos você mesmo. Para trocar, mude a linha do modelo para zai-. Os preços atuais de cada modelo estão na página de preços, e modelos DeepSeek no CheapTokens lista os detalhes.
Experimente você mesmoTente: seu arquivo tem 100.000 comentários, não 40.000. O que muda?Mostrar resposta
A conta cresce junto com a contagem. 100.000 × 150 = 15.000.000 tokens de entrada e 100.000 × 5 = 500.000 tokens de saída, o que dá $0.275 no DeepSeek-V4-Flash. Mesmo prompt, 2,5 vezes os itens, 2,5 vezes o custo.
Antes de apertar executar#
Primeiro, um ensaio. Pegue 50 comentários, rode o loop e leia todos os 50 vereditos. Depois use os totais de tokens impressos: 50 × 800 = 40.000, então a execução completa é os tokens do ensaio multiplicados por 800. Isso substitui a premissa de 150 e 5 pelos seus próprios números.
Segundo, ajuste o prompt no ensaio, não na execução completa. Se três vereditos de "descartar" estiverem errados, adicione uma frase sobre esse caso e rode os 50 de novo. Custa uma fração de centavo ser exigente aqui, e muito mais rodar 40.000 de novo.
Terceiro, lembre-se do que o modelo vê: um comentário, sem thread. Se "concordo, ótimo ponto" só faz sentido ao lado do comentário pai, coloque o pai na requisição também. Isso deixa cada requisição mais longa, então refaça a aritmética de tokens com o novo tamanho.
Quando o ensaio parecer certo, crie uma chave de API na sua conta, aponte CHEAPTOKENS_ para ela e comece a passagem completa. Se a chave é novidade para você, o que é uma chave de API e como armazená-la leva cinco minutos.


