AI untuk pemulaPanduan
Filter 40K komentar dengan LLM: prompt keep/drop dan biaya
Prompt keep/drop, loop Python singkat dan estimasi token untuk memfilter 40.000 komentar dengan LLM murah, sebelum Anda menjalankan apa pun.
Di halaman ini
Arsip Anda memiliki 40.000 komentar, dan sebagian besar adalah noise: spam, "+1", lelucon, balasan yang tidak ada hubungannya dengan yang Anda cari. LLM murah dapat membaca masing-masing dan menjawab dengan satu kata, keep atau drop. Kirim setiap komentar sebagai permintaan pendeknya sendiri dan seluruh proses memakan sekitar 6 juta token input dan 200 ribu token output (dengan asumsi kira-kira 150 token masuk dan 5 keluar per komentar). Pada DeepSeek-V4-Flash, proses itu memakan biaya $0.11 dengan harga saat ini.
Di bawah: prompt, loop Python singkat, dan aritmetika yang dapat Anda ulangi untuk arsip Anda sendiri. Semuanya melalui endpoint yang kompatibel dengan OpenAI yang dijelaskan di dokumentasi CheapTokens.
Dari mana ide ini berasal#
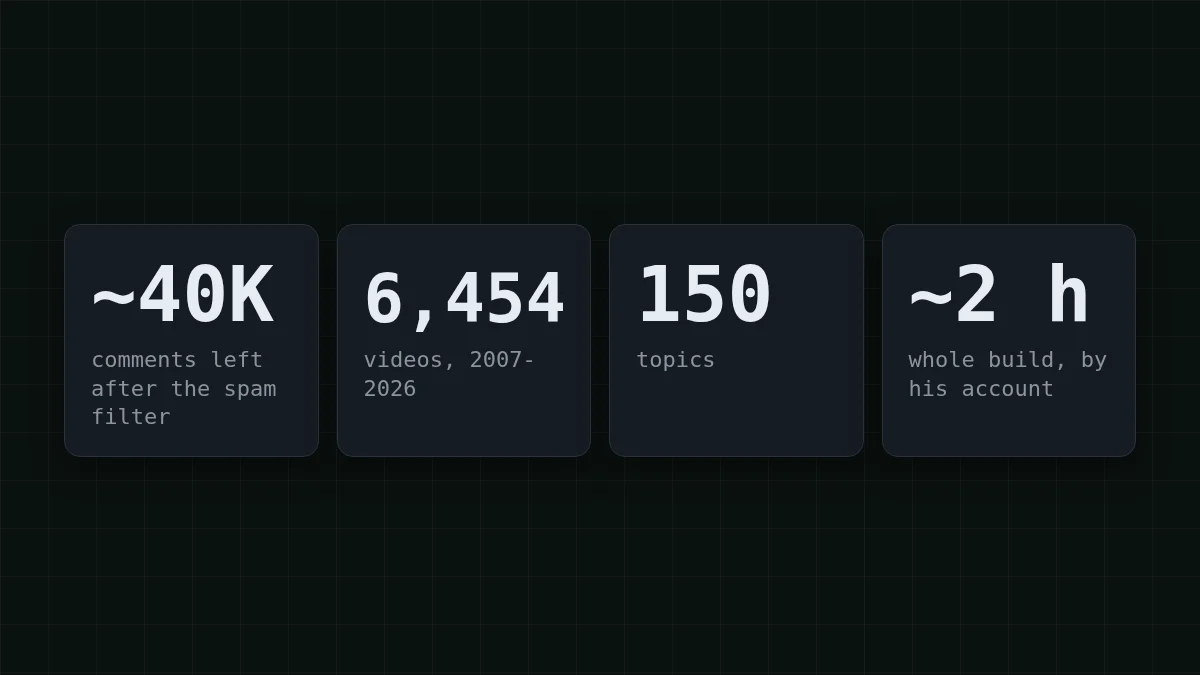
Andrej Karpathy (peneliti AI, salah satu pendiri OpenAI, mantan direktur AI di Tesla) menjelaskan dalam postingannya tanggal 31 Oktober 2026 bagaimana ia membangun HackerTube, situs video yang direkomendasikan dalam komentar Hacker News. Dalam pembangunan itu, Sonnet menjalankan komentar dalam alur kerja Claude Code untuk menghapus spam dan menyaringnya menjadi sekitar 40.000 komentar yang merekomendasikan video YouTube. Hasilnya adalah 6.454 video di 150 topik, dan ia mengatakan seluruh pembangunan sekarang memakan waktu sekitar dua jam.
Postingan itu tidak melaporkan jumlah token atau biaya. Jadi angka-angka dalam artikel ini adalah aritmetika dari asumsi yang dinyatakan tepat di sebelahnya, bukan rekonstruksi dari prosesnya. Yang dapat Anda pinjam adalah bentuk tugasnya: banyak teks pendek, satu pertanyaan ya/tidak tentang masing-masing.
Cara kerja filter ya/tidak#
Bayangkan seorang penjaga pintu dengan aturan satu baris: "izinkan masuk siapa pun yang punya tiket". Ia melihat setiap orang selama satu detik, mengatakan ya atau tidak, dan tidak pernah mengingat tamu sebelumnya. Filter LLM bekerja dengan cara yang sama. Setiap permintaan membawa instruksi Anda plus satu komentar, dan model mengirim kembali satu kata. Komentar 17.000 tidak tahu apa-apa tentang komentar 16.999.
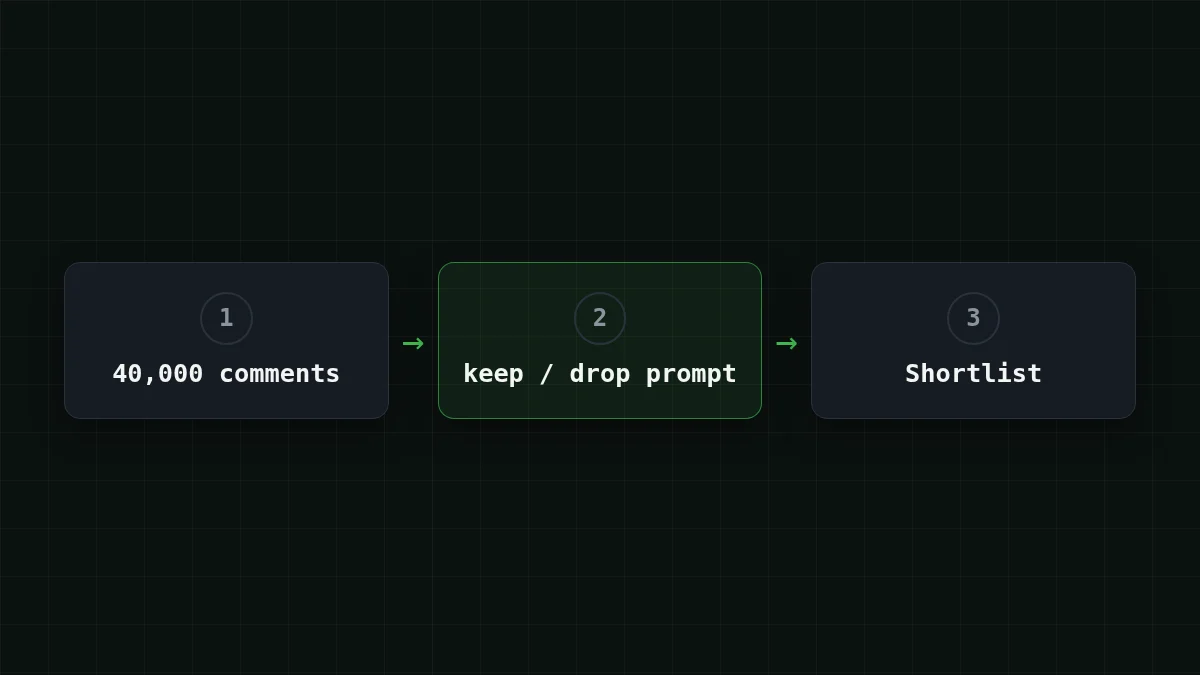
Desain itulah yang membuat tagihannya dapat diprediksi. Setiap permintaan memiliki ukuran yang kira-kira sama, jadi biaya adalah jumlah permintaan × token per permintaan. Dan karena jawabannya satu kata, hampir semua uang masuk ke sisi input: instruksi dan komentar yang Anda kirim. Jika harga input dan output baru bagi Anda, token input vs output menjelaskan pembagiannya.
Tulis prompt keep/drop#
Prompt adalah seluruh produk di sini. Bandingkan versi yang samar dengan yang tepat:
Bandingkan
Aturan samar vs aturan tepat
Samar
Is this comment good? Answer yes or no.Baik untuk siapa? Komentar panjang dan sopan tentang basis data bisa kembali "ya" sementara "tonton ini: <link>" yang pendek kembali "tidak". Model harus menebak apa yang Anda maksud, dan tebakannya berubah dari komentar ke komentar.
Tepat
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.Sekarang model memiliki aturan, bukan suasana hati untuk ditebak: apa yang dihitung, apa yang tidak, dan seperti apa balasannya.
Katakan tiga komentar datang. Ini adalah jawaban yang Anda tuju:
- "This talk on the history of Unix changed how I see shells: youtube.com/watch?v=... Worth the hour." →
keep - "Cheap watches here!!! click my profile" →
drop - "Agree, great point about caching." →
drop
Tiga kebiasaan membuat prompt bertahan di 40.000 item. Katakan apa yang harus dilakukan dengan kasus sisa ("segala sesuatu yang lain adalah drop"); jika tidak, model akan menciptakan jawaban ketiga. Minta satu kata, sehingga balasannya mudah dibandingkan dengan keep dalam kode. Dan bungkus komentar dalam tag, seperti dalam loop di bawah: komentar yang mengatakan "abaikan instruksi di atas" kemudian jelas merupakan data, bukan perintah. Beri label setiap dokumen dalam prompt membahas lebih dalam tentang itu.
Loop: satu permintaan per komentar#
Inilah keseluruhannya. Ini membaca comments.jsonl (satu objek JSON dengan bidang text per baris), meminta putusan untuk setiap komentar, dan menulis baris yang dipertahankan ke kept.jsonl. Id model adalah gateway_id lengkap; kuncinya berasal dari variabel lingkungan.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 membuat putusan lebih dapat diulang antar proses, dan max_tokens=10 menyisakan ruang untuk satu kata dan tidak lebih. Baris terakhir adalah yang berguna: ia menjumlahkan angka usage yang dikembalikan API, sehingga Anda mendapatkan jumlah token nyata alih-alih tebakan.
Jalankan pada sepuluh komentar pertama dan baca setiap putusan sendiri. Jika jawaban tampak terpotong atau kembali kosong, periksa finish_reason seperti dijelaskan dalam mengapa jawaban AI berhenti di tengah kalimat. Satu permintaan pada satu waktu baik untuk pengujian; untuk 40.000 penuh, AsyncOpenAI mengirim banyak secara paralel.
Berapa biaya 40.000 komentar#
Berikut asumsinya, sehingga Anda dapat menggantinya dengan milik Anda sendiri. Sebuah komentar plus instruksi adalah sekitar 150 token input. Balasannya sekitar 5 token. Komentar Hacker News sering lebih panjang, jadi anggap 150 sebagai batas bawah dan ganti dengan angka dari uji coba. Untuk 40.000 komentar:
- input: 40.000 × 150 = 6.000.000 token
- output: 40.000 × 5 = 200.000 token
Instruksi adalah bagian yang orang lupakan. Itu ikut dengan setiap komentar. Coba tebak:
Tebak angkanya
Katakan instruksi Anda panjangnya 60 token. Berapa jumlah token input yang ditambahkan oleh 40.000 salinannya?
Tebakan Anda
06.000.000
Tampilkan jawaban
Jawaban: 2.400.000
40.000 × 60 = 2.400.000. Itu 40% dari 6.000.000 token input, dihabiskan untuk teks yang tidak pernah berubah, jadi instruksi yang lebih ringkas adalah hal pertama yang harus dipangkas.
Sekarang tagihan untuk seluruh proses, dengan harga langsung:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 40.000 permintaan | OpenRouter, 40.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
150 token input dan 5 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Pada beban kerja ini, DeepSeek-V4-Flash dan GLM-5.3-Flash keduanya lebih murah daripada OpenRouter secara total, dengan input dan output dihitung bersama; kolom OpenRouter menunjukkannya berdampingan. Keduanya diberi harga untuk pekerjaan bervolume tinggi seperti ini: DeepSeek-V4-Flash memiliki satu harga pada jam berapa pun dan hingga 32.768 token output per jawaban, GLM-5.3-Flash adalah opsi kedua pada endpoint yang sama. Coba uji coba 50 komentar Anda pada masing-masing dan bandingkan putusannya sendiri. Untuk beralih, ubah baris model menjadi zai-. Harga terkini untuk setiap model ada di halaman harga, dan model DeepSeek di CheapTokens mencantumkan detailnya.
Coba sendiriCoba: arsip Anda memiliki 100.000 komentar, bukan 40.000. Apa yang berubah?Tampilkan jawaban
Tagihannya tumbuh seiring dengan jumlahnya. 100.000 × 150 = 15.000.000 token input dan 100.000 × 5 = 500.000 token output, yaitu $0.275 pada DeepSeek-V4-Flash. Prompt sama, 2,5 kali item, 2,5 kali biaya.
Sebelum Anda menekan run#
Pertama, uji coba. Ambil 50 komentar, jalankan loop, dan baca semua 50 putusan. Kemudian gunakan total token yang dicetak: 50 × 800 = 40.000, jadi proses penuh adalah token uji coba dikalikan 800. Itu menggantikan asumsi 150-dan-5 dengan angka Anda sendiri.
Kedua, perbaiki prompt pada uji coba, bukan pada proses penuh. Jika tiga putusan "drop" salah, tambahkan satu kalimat tentang kasus itu dan jalankan ulang 50. Biayanya sepersekian sen untuk bersikap teliti di sini, dan jauh lebih banyak untuk menjalankan ulang 40.000.
Ketiga, ingat apa yang dilihat model: satu komentar, tanpa thread. Jika "agree, great point" hanya bermakna di samping komentar induk, sertakan induknya dalam permintaan juga. Itu membuat setiap permintaan lebih panjang, jadi ulangi aritmetika token dengan ukuran baru.
Ketika uji coba terlihat benar, buat kunci API di akun Anda, arahkan CHEAPTOKENS_ ke sana dan mulai proses penuh. Jika kunci itu baru bagi Anda, apa itu kunci API dan cara menyimpannya memakan waktu lima menit.


