Filtra 40K comentarios con un LLM: prompt de conservar/descartar y coste
Un prompt de conservar/descartar, un bucle corto en Python y una estimación de tokens para filtrar 40.000 comentarios con un LLM barato, antes de ejecutar nada.
En esta página
Tu archivo tiene 40.000 comentarios, y la mayoría son ruido: spam, "+1", chistes, respuestas que no tienen nada que ver con lo que buscas. Un LLM barato puede leer cada uno y responder con una sola palabra, keep o drop. Envía cada comentario como su propia petición corta y la pasada completa viene a costar unos 6 millones de tokens de entrada y 200 mil tokens de salida (suponiendo aproximadamente 150 tokens de entrada y 5 de salida por comentario). En DeepSeek-V4-Flash esa ejecución cuesta $0.11 al precio actual.
Abajo: el prompt, un bucle corto en Python y la aritmética que puedes rehacer para tu propio archivo. Todo pasa por el endpoint compatible con OpenAI que se describe en la documentación de CheapTokens.
De dónde viene la idea#
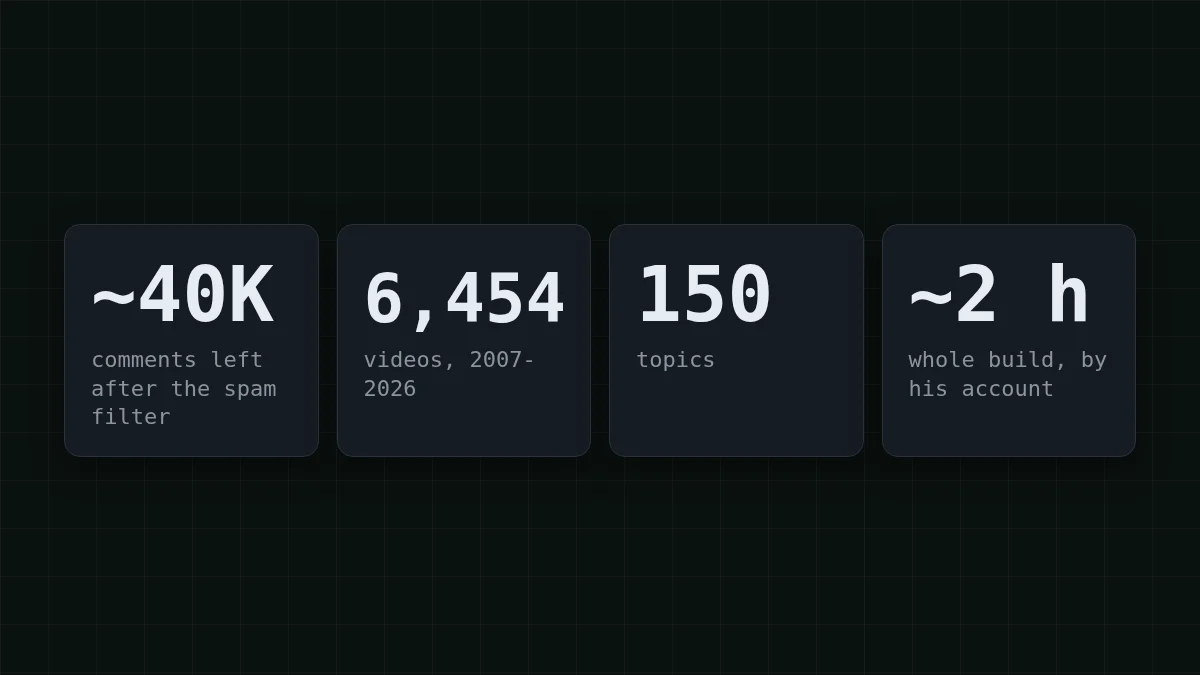
Andrej Karpathy (investigador de IA, cofundador de OpenAI, exdirector de IA en Tesla) describió en su publicación del 31 de octubre de 2026 cómo construyó HackerTube, un sitio de vídeos recomendados en los comentarios de Hacker News. En esa construcción, Sonnet recorrió los comentarios en un flujo de trabajo de Claude Code para eliminar el spam y reducirlos a unos 40.000 comentarios que recomiendan vídeos de YouTube. El resultado fueron 6.454 vídeos en 150 temas, y dice que toda la construcción ahora lleva unas dos horas.
La publicación no informa de recuentos de tokens ni de coste. Así que los números de este artículo son aritmética a partir de supuestos indicados justo al lado, no una reconstrucción de su ejecución. Lo que puedes tomar prestado es la forma de la tarea: muchos textos cortos, una pregunta de sí/no sobre cada uno.
Cómo funciona un filtro de sí/no#
Piensa en un portero con una regla de una línea: "deja pasar a cualquiera que tenga entrada". Mira a cada persona un segundo, dice sí o no, y nunca recuerda al invitado anterior. Un filtro LLM funciona igual. Cada petición lleva tu instrucción más un comentario, y el modelo devuelve una palabra. El comentario 17.000 no sabe nada del comentario 16.999.
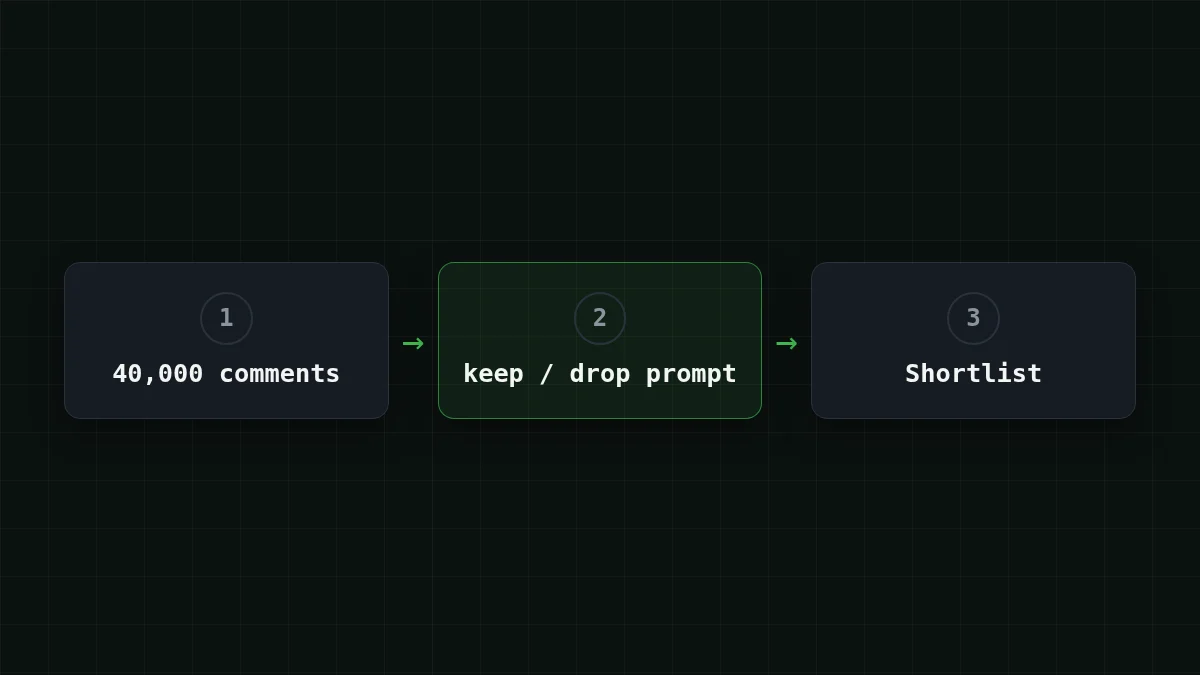
Ese diseño es la razón por la que la factura es predecible. Cada petición tiene aproximadamente el mismo tamaño, así que el coste es peticiones × tokens por petición. Y como la respuesta es una palabra, casi todo el dinero se va al lado de la entrada: la instrucción y el comentario que envías. Si el precio de entrada y salida es nuevo para ti, tokens de entrada vs salida explica la división.
Escribe el prompt de conservar/descartar#
El prompt es todo el producto aquí. Compara una versión vaga con una exacta:
Comparar
Regla vaga vs regla exacta
Vaga
Is this comment good? Answer yes or no.¿Buena para quién? Un comentario largo y educado sobre bases de datos puede volver como "sí" mientras que un corto "mira esto: <enlace>" vuelve como "no". El modelo tiene que adivinar qué querías decir, y su conjetura cambia de un comentario a otro.
Exacta
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.Ahora el modelo tiene una regla en lugar de un estado de ánimo que adivinar: qué cuenta, qué no, y cómo es la respuesta.
Supón que llegan tres comentarios. Estas son las respuestas que buscas:
- "Esta charla sobre la historia de Unix cambió cómo veo las shells: youtube.com/watch?v=... Vale la hora." →
keep - "¡¡¡Relojes baratos aquí!!! haz clic en mi perfil" →
drop - "De acuerdo, buen punto sobre el almacenamiento en caché." →
drop
Tres hábitos hacen que el prompt aguante 40.000 elementos. Di qué hacer con los casos sobrantes ("todo lo demás es descartar"); si no, el modelo inventa una tercera respuesta. Pide una sola palabra, para que la respuesta sea fácil de comparar con keep en el código. Y envuelve el comentario en etiquetas, como en el bucle de abajo: un comentario que dice "ignora las instrucciones anteriores" queda entonces claramente como dato, no como orden. Etiquetar cada documento en un prompt profundiza en eso.
El bucle: una petición por comentario#
Aquí está todo. Lee comments.jsonl (un objeto JSON con un campo text por línea), pide un veredicto sobre cada comentario y escribe las líneas conservadas en kept.jsonl. El id del modelo es el gateway_id completo; la clave viene de una variable de entorno.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 hace los veredictos más repetibles entre ejecuciones, y max_tokens=10 deja espacio para una palabra y nada más. La última línea es la útil: suma los números usage que devuelve la API, así obtienes tus recuentos reales de tokens en lugar de una conjetura.
Ejecútalo con los primeros diez comentarios y lee tú mismo cada veredicto. Si una respuesta parece cortada o vuelve vacía, revisa finish_reason como se describe en por qué una respuesta de IA se detiene a mitad de frase. Una petición a la vez está bien para una prueba; para los 40.000 completos, AsyncOpenAI envía muchas en paralelo.
Cuánto cuestan 40.000 comentarios#
Aquí están los supuestos, para que puedas sustituir los tuyos. Un comentario más la instrucción son unos 150 tokens de entrada. La respuesta son unos 5 tokens. Los comentarios de Hacker News suelen ser más largos, así que trata 150 como un mínimo y sustitúyelo por los números del ensayo. Para 40.000 comentarios:
- entrada: 40.000 × 150 = 6.000.000 tokens
- salida: 40.000 × 5 = 200.000 tokens
La instrucción es la parte que la gente olvida. Viaja con cada uno de los comentarios. Prueba una conjetura:
Adivina el número
Supón que tu instrucción tiene 60 tokens. ¿A cuántos tokens de entrada suman 40.000 copias de ella?
Tu respuesta
06.000.000
Mostrar respuesta
Respuesta: 2.400.000
40.000 × 60 = 2.400.000. Eso es el 40% de los 6.000.000 de tokens de entrada, gastados en texto que nunca cambia, así que una instrucción más ajustada es lo primero que recortar.
Ahora la factura de la pasada completa, con precios en vivo:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 40.000 solicitudes | OpenRouter, 40.000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
150 tokens de entrada y 5 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En esta carga de trabajo, DeepSeek-V4-Flash y GLM-5.3-Flash salen ambos más baratos que OpenRouter en total, contando entrada y salida juntas; la columna de OpenRouter lo muestra lado a lado. Ambos tienen precio para un trabajo de alto volumen como este: DeepSeek-V4-Flash tiene un precio a cualquier hora y hasta 32.768 tokens de salida por respuesta, GLM-5.3-Flash es una segunda opción en el mismo endpoint. Prueba tu ensayo de 50 comentarios con cada uno y compara los veredictos tú mismo. Para cambiar, modifica la línea del modelo a zai-. Los precios actuales de cada modelo están en la página de precios, y modelos DeepSeek en CheapTokens enumera los detalles.
Pruébalo tú mismoPruébalo: tu archivo tiene 100.000 comentarios, no 40.000. ¿Qué cambia?Mostrar respuesta
La factura crece al mismo ritmo que el recuento. 100.000 × 150 = 15.000.000 tokens de entrada y 100.000 × 5 = 500.000 tokens de salida, que son $0.275 en DeepSeek-V4-Flash. Mismo prompt, 2,5 veces los elementos, 2,5 veces el coste.
Antes de pulsar ejecutar#
Primero, un ensayo. Toma 50 comentarios, ejecuta el bucle y lee los 50 veredictos. Luego usa los totales de tokens impresos: 50 × 800 = 40.000, así que la ejecución completa son los tokens del ensayo multiplicados por 800. Eso sustituye el supuesto de 150 y 5 por tus propios números.
Segundo, ajusta el prompt en el ensayo, no en la ejecución completa. Si tres veredictos de "descartar" son erróneos, añade una frase sobre ese caso y vuelve a ejecutar los 50. Cuesta una fracción de céntimo ser exigente aquí, y mucho más volver a ejecutar 40.000.
Tercero, recuerda lo que ve el modelo: un comentario, ningún hilo. Si "de acuerdo, buen punto" solo tiene sentido junto al comentario padre, pon también el padre en la petición. Eso hace cada petición más larga, así que rehaz la aritmética de tokens con el nuevo tamaño.
Cuando el ensayo parezca correcto, crea una clave de API en tu cuenta, apunta CHEAPTOKENS_ a ella y empieza la pasada completa. Si la clave es nueva para ti, qué es una clave de API y cómo guardarla te lleva cinco minutos.


