Etiqueta cada documento en un prompt para que el modelo no los confunda
Cómo dar a cada texto pegado un nombre y una función, con un prompt de antes/después y una solicitud de chat completion funcional en Python y curl.
En esta página
Pegaste dos textos en un solo mensaje y le pediste al modelo que los comparara. A menos que hayas dicho cuál es cuál, tiene que adivinar. La solución es pequeña: dale a cada texto un nombre y una función, y envuelve cada uno en su propia etiqueta. La guía de prompting de Anthropic (una página viva, consultada el 31 de octubre de 2026) recomienda etiquetar cada tipo de contenido para que el modelo no malinterprete qué es una instrucción, qué es contexto y qué es la entrada. Abajo tienes un prompt de antes/después y una solicitud de chat completion funcional que puedes enviar a la API de CheapTokens.
Qué sale mal cuando solo pegas#
Toma el caso más simple. Un proveedor envía una nueva descripción de producto y quieres saber qué cambió respecto a la que está en tu página de la tienda. Pegas ambas bajo "¿Qué cambió?" y pulsas enviar. Para ti el orden es obvio. Para el modelo son dos bloques de texto sin nada entre ellos, y la pregunta nunca dice cuál es el antiguo. Puede que acierte. También puede llamar al texto nuevo el antiguo y entregarte una lista de cambios al revés, con una voz perfectamente segura.
La misma trampa se esconde en tareas cotidianas:
- dos versiones de un contrato, y preguntas qué cambió la otra parte;
- tres notas de reunión, y preguntas qué decisiones se contradicen entre sí;
- una muestra de estilo más un borrador: ¿cuál imitar, cuál reescribir?
- un log de errores pegado junto con el código, y la pregunta es "arregla esto".
En cada uno de ellos el modelo necesita dos cosas por texto: un nombre (qué es y de dónde viene) y una función (qué quieres hacer con él).
Dale a cada texto un nombre y una función#
Tres movimientos pequeños:
- Pon cada texto en su propia etiqueta. La guía de Anthropic sugiere un envoltorio
<documents>con un<document index="1">por texto, y dentro de él un<source>para el nombre y<document_para el texto en sí.content> - Di qué es cada uno en la instrucción, fuera de las etiquetas: "El documento 1 es el texto ANTIGUO de nuestra tienda. El documento 2 es el texto NUEVO del proveedor."
- Haz la pregunta con las mismas palabras. "Enumera cada dato que cambió, como antiguo -> nuevo" ahora tiene un antiguo y un nuevo a los que apuntar.
Aquí está el ejemplo de la botella antes y después:
Comparar
La misma solicitud, antes y después
Antes
What changed?

Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.

Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
Después
Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
</document_content>
</document>
</documents>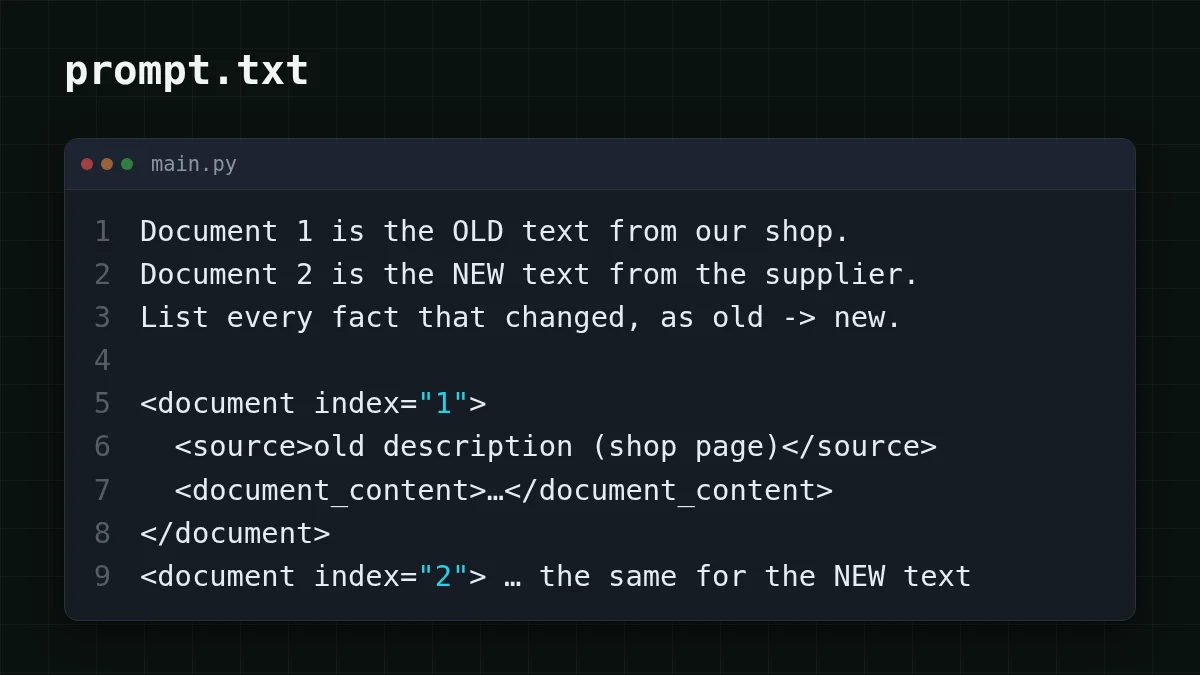
Las etiquetas cuestan unos pocos tokens y eliminan las conjeturas. Anthropic escribió este consejo para sus modelos Claude, pero las etiquetas son texto plano, así que nada te impide enviar el mismo diseño a otro modelo de chat.
Envíalo como una solicitud real#
Aquí está el prompt "después" como llamada a la API. La dirección es https:/, la API es compatible con OpenAI y el modelo es deepseek-. Toma los ids de modelo de la documentación de CheapTokens: los nombres difieren entre proveedores. DeepSeek-V4-Flash tiene una ventana de contexto de 380K y hasta 32.768 tokens de salida por respuesta, lo que deja espacio para un montón de textos largos. La clave viene de una variable de entorno, nunca del código.
La misma solicitud en dos herramientas
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

old = "Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe."
new = "Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only."

prompt = f"""Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
{old}
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
{new}
</document_content>
</document>
</documents>"""

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": prompt}],
    max_tokens=300,
)
print(response.choices[0].message.content)
print(response.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 300,
    "messages": [{
      "role": "user",
      "content": "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.\n\n<documents>\n<document index=\"1\">\n<source>old description (current shop page)</source>\n<document_content>\nSteel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.\n</document_content>\n</document>\n<document index=\"2\">\n<source>new description (from the supplier)</source>\n<document_content>\nSteel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.\n</document_content>\n</document>\n</documents>"
    }]
  }'
La respuesta es texto plano en choices[0]., y usage junto a él cuenta los tokens. Una buena respuesta enumera tres cambios: 500 ml -> 750 ml, 12 horas -> 24 horas, apto para lavavajillas -> solo lavado a mano. Si las flechas van al revés, el modelo perdió de vista las etiquetas. Comprueba que la instrucción llama a los documentos igual que las etiquetas.
Cuánto cuestan las etiquetas#
Las etiquetas son texto, y el texto se factura. Digamos que un líder de equipo introduce tres notas de reunión de unos 2.000 tokens cada una y pregunta qué decisiones entran en conflicto. Tres notas: 3 × 2.000 = 6.000 tokens. Añade unos 150 tokens para la instrucción y las etiquetas (una suposición) y la solicitud lleva 6.150 tokens de entrada, con una respuesta de 300 tokens de salida. En DeepSeek-V4-Flash esa solicitud cuesta $0.00012, y las etiquetas en sí son un error de redondeo junto a las notas. Aquí está la misma solicitud enviada 1.000 veces, con OpenRouter al lado:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.135 | $0.231 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00012 | $0.122 | $0.473 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00035 | $0.353 | $4.23 |
6150 tokens de entrada y 300 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Los 6.150 tokens caben en la ventana de 380K con espacio de sobra (qué es una ventana de contexto). Contado en total, entrada y salida juntas, la solicitud sale más barata que OpenRouter. La entrada y la salida se facturan a tarifas distintas, y tokens de entrada vs salida explica por qué. Las cifras actuales de cada modelo están en la página de precios.
Hábitos para montones de texto más grandes#
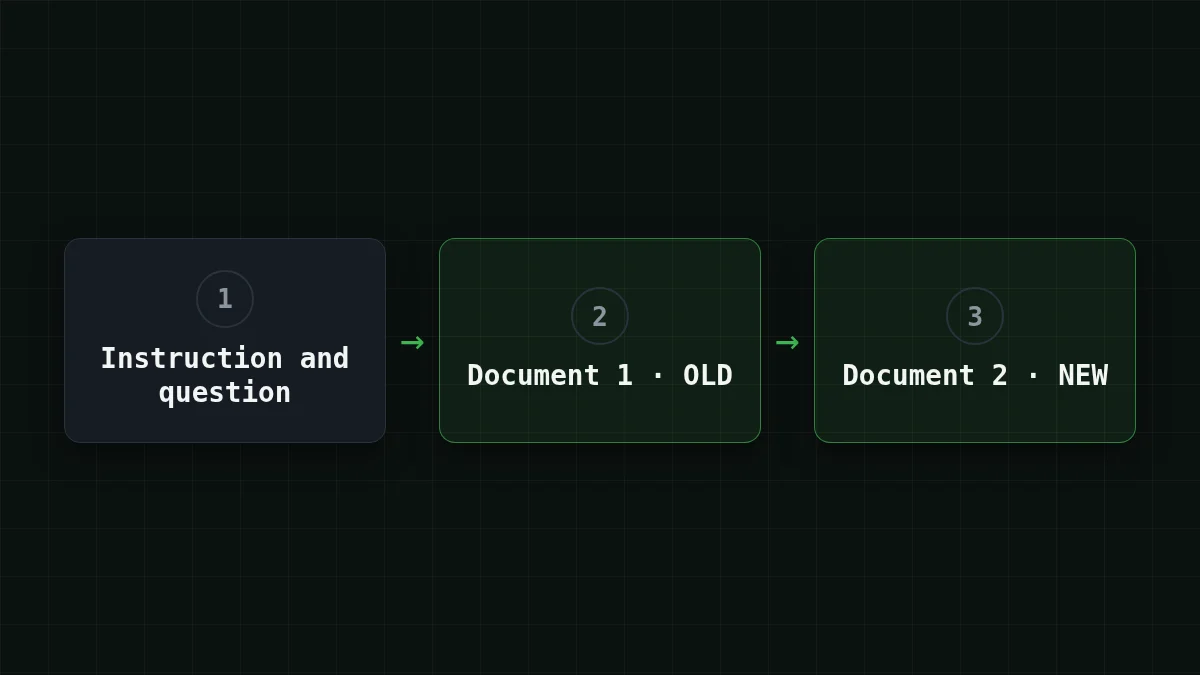
Cuando hay más de dos textos, los números por sí solos no bastan: cada uno necesita su propio nombre. La imagen de abajo muestra el diseño del ejemplo: primero la instrucción con la pregunta, luego cada documento en su propia etiqueta.
- Nombra por contenido, no solo por número.
<source>contract v2, sent by the client</supera asource> document 2cuando la respuesta te lo cita de vuelta. - Mantén tu instrucción fuera de las etiquetas, para que una línea dentro de un texto pegado no se tome por una orden.
- Un texto, una etiqueta. Un archivo largo sigue siendo una etiqueta; dos archivos son dos.
- Reutiliza los nombres en la pregunta: "¿qué decisiones de monday-notes contradicen a wednesday-notes?".
- Da funciones también a los ejemplos. "El documento 1 es una muestra de estilo: copia su tono, no sus datos. El documento 2 es el borrador a reescribir."
Pruébalo tú mismoPruébalo: tienes un log de errores y el código que lo produjo en un solo prompt. ¿Qué añades a cada uno?Mostrar respuesta
Un nombre y una función. Para el log: <source>error log from the last run</ más "este es el síntoma, no lo edites". Para el código: <source>app. más "esto es lo que hay que arreglar". Luego pide la corrección por esos nombres.
Para lo básico del resto del prompt (objetivo, contexto, formato), consulta cómo escribir un buen prompt.


