Cómo escribir un buen prompt: 5 partes y un ejemplo de antes/después
Convierte una petición vaga de una línea en un prompt con tarea, contexto, formato, ejemplo y reglas, y luego envíalo a través de una API compatible con OpenAI.
En esta página
Tu modelo resume un correo de cliente en tres párrafos el lunes y en dos viñetas el martes. Mismo prompt, mismo modelo. Eso es lo que hace una petición de una línea: deja cada decisión al modelo, y el modelo decide de forma distinta cada vez.
Un buen prompt responde a cinco preguntas: qué hacer (tarea), con qué trabajar (contexto), qué aspecto debe tener la respuesta (formato), qué aspecto tiene una buena respuesta (ejemplo) y qué evitar (restricciones). A continuación, una petición vaga se convierte en una estructurada, pasa por la API de CheapTokens compatible con OpenAI, y ves qué añade el prompt más largo a la factura.
Por qué "Resume este correo" es una apuesta#
Cuando escribes "Resume este correo", ya tienes una respuesta en mente: una frase, cuán urgente es, qué hacer después. El modelo no puede ver esa imagen. Así que adivina, y cada conjetura es razonable. Juntas te dan una respuesta distinta en cada ejecución, y un script que lee la respuesta no tiene nada estable que analizar.
La guía de ingeniería de prompts de OpenAI (leída el 27 de octubre de 2026) lo dice claramente: la ingeniería de prompts consiste en escribir instrucciones eficaces, y los modelos GPT funcionan mejor cuando les dices explícitamente cómo realizar una tarea. El hábito no se limita al texto. El 26 de octubre de 2026 un canal de Telegram compartió un prompt para un vídeo generado de 30 segundos que estaba dividido en bloques: escena, estilo visual, diálogo, audio y exclusiones, especificaciones técnicas. Tarea distinta, misma jugada. El autor nombró cada decisión por adelantado en lugar de dejarla al modelo.
Pruébalo tú mismoPruébalo: ¿qué tendría que adivinar un modelo a partir de "Resume este correo"?Mostrar respuesta
La longitud (una línea o una página), el público (tú o el cliente), la forma de la respuesta (prosa, viñetas, JSON), qué cuenta como importante y qué hacer cuando el correo no lo dice. Cada una de esas cosas es algo que un prompt puede resolver.
Las cinco partes, en palabras sencillas#
Piensa en instruir a un nuevo colega en su primer día. "Encárgate de esto" te da una conjetura. Una nota adhesiva con el trabajo, el material, el formato que quieres, un ejemplo y un "no" te da lo que querías decir.
Tarea es un verbo y un objeto: "Resume el correo y valora su urgencia". Sé literal. "Ayúdame con este correo" no es una tarea.
Contexto es el material sobre el que trabaja el modelo: el correo, una descripción de producto, una política. El modelo solo sabe lo que aprendió en el entrenamiento más lo que pegas. Envuelve el texto pegado en delimitadores, como etiquetas estilo XML como <email>…</email> o encabezados markdown, para que tus instrucciones no se confundan con el texto. La guía de OpenAI sugiere ambas.
Formato es qué aspecto tiene la respuesta: "JSON con las claves summary, urgency, next_step" o "tres viñetas, 12 palabras cada una como máximo". Importa sobre todo cuando el código lee la respuesta.
Ejemplo es una entrada con la salida que quieres. La guía recomienda ejemplos few-shot que cubran una variedad diversa de entradas con las salidas deseadas. Un ejemplo es un buen comienzo; añade un segundo cuando tus entradas difieren mucho.
Restricciones son los "no": usa solo hechos del correo, escribe "unknown" cuando falte algo, nada de reembolsos ni descuentos.
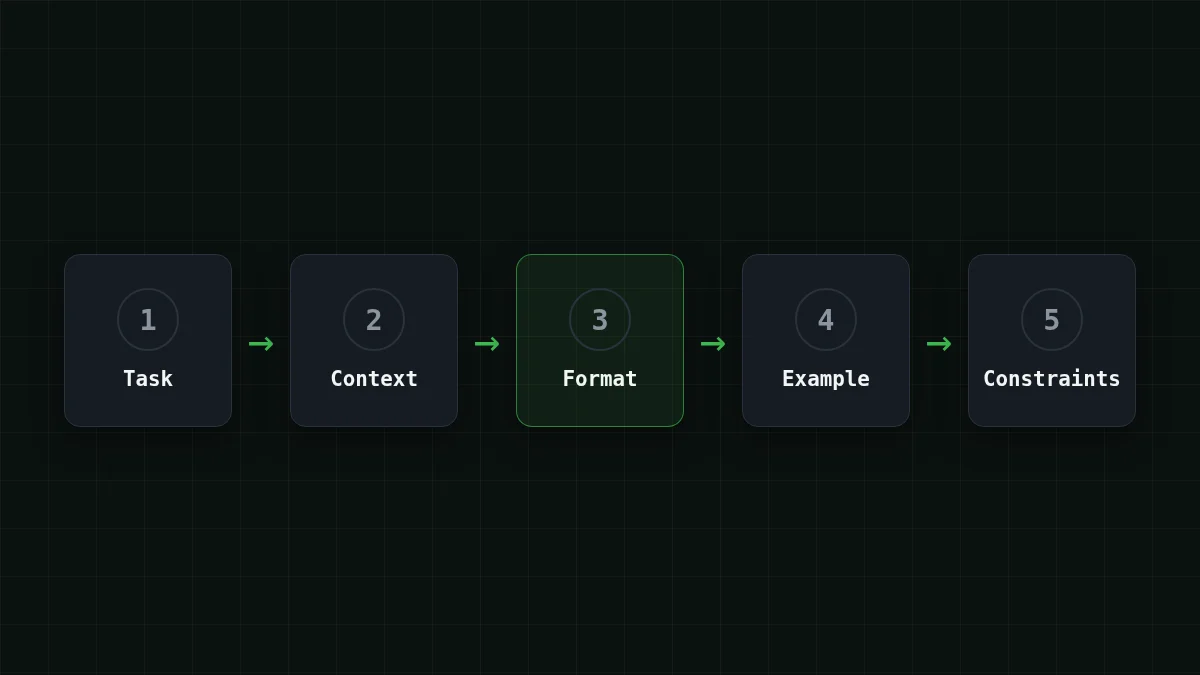
El orden también importa un poco. La misma guía dice que un mensaje de desarrollador o de sistema suele ir con identidad, instrucciones, ejemplos, contexto, y que el contexto pertenece cerca del final porque cambia entre peticiones. Las reglas van en el mensaje de sistema; la entrada va en el mensaje de usuario.
Emparejar los pares
Empareja cada parte de un prompt con la pregunta que responde
Toca un elemento de la izquierda, luego su par
- Tarea¿Qué debe hacer el modelo?
- Contexto¿Sobre qué material trabaja?
- Formato¿Qué aspecto debe tener la respuesta?
- Ejemplo¿Qué aspecto tiene una buena respuesta?
- Restricciones¿Qué no debe hacer?
Antes y después: un correo de cliente#
Aquí está la petición de una línea junto a la misma petición con las cinco partes. El correo en sí es el contexto, y va en el mensaje de usuario, envuelto en etiquetas <email>.
Comparar
Una petición, dos prompts
Antes
Summarize this email.Después
You summarize customer emails for a support team.

Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
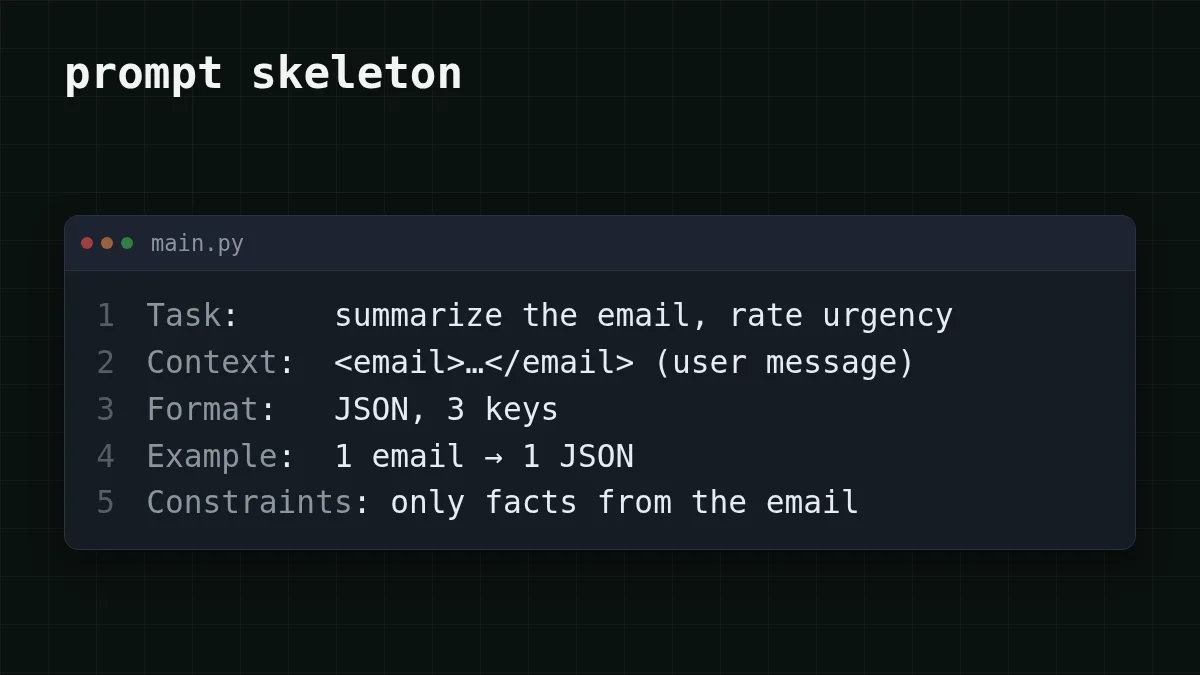
Lee el "después" de arriba abajo y puedes señalar cada parte: la línea inicial y la tarea, la línea de formato, el ejemplo, las reglas. El correo falta en el texto a propósito. Cambia con cada petición, así que viaja por separado.
Envíalo a través de la API#
Las instrucciones nunca cambian, así que viven en una constante y van primero. El correo cambia, así que va al final. Este es el script completo, usando el SDK de Python de OpenAI apuntando a CheapTokens. El modelo es DeepSeek-V4-Flash: contexto de 380K, hasta 32.768 tokens de salida por respuesta, un precio a cualquier hora. Toma la URL base y el id del modelo de la documentación de CheapTokens; si aún no tienes una clave, tu primera petición a la API lo explica paso a paso.
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

SYSTEM_PROMPT = """You summarize customer emails for a support team.

Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
"""

email = "Hello, I was charged twice for my subscription this month. Please fix it before Friday, my card is almost at its limit."

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": f"<email>\n{email}\n</email>"},
    ],
)

reply = response.choices[0].message.content
print(json.loads(reply))
print(response.usage.prompt_tokens, response.usage.completion_tokens)
Si la línea de formato hizo su trabajo, la respuesta es un objeto JSON con summary, urgency y next_step, y json.loads lo convierte en un diccionario. Si lanza un error, el modelo envolvió el JSON en texto extra: ajusta la última regla o añade un segundo ejemplo. La última línea imprime cuántos tokens entraron y salieron, que es el número del que trata la siguiente sección.
Cuánto cuestan las palabras extra#
Un token es un fragmento de una palabra. Pagas por token por lo que envías (entrada) y por lo que escribe el modelo (salida), y la salida es el lado más caro. Más sobre eso en tokens de entrada vs salida.
Supongamos que ejecutas un bot de soporte con 1.000 correos al día, y el correo tiene unos 300 tokens. La petición de una línea añade aproximadamente 10 tokens de instrucción, así que entran unos 310; asumimos que obtiene un resumen de forma libre de unos 250 tokens. El prompt de sistema de arriba tiene unos 200 tokens, más unos 10 por las etiquetas <email>, así que entran unos 500; asumimos que la línea de formato contiene la respuesta a un JSON de unos 80 tokens. En DeepSeek-V4-Flash eso es $0.00003 por correo para la petición de una línea y $0.000016 para el prompt estructurado. El prompt se alargó, pero la petición se abarató, porque la parte larga es la entrada y la parte que acortaste es la salida. Ejecuta el script y cambia estas suposiciones por tus propios prompt_tokens y completion_.
Aquí está el prompt estructurado a 1.000 correos al día en los distintos modelos. En total, contando entrada y salida juntas, CheapTokens sale más barato que el precio de referencia de OpenRouter en esta carga de trabajo; los precios actuales están en la página de precios.
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000013 | $0.0132 | $0.0234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000016 | $0.0155 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000037 | $0.037 | $0.444 |
500 tokens de entrada y 80 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Compruébalo tú mismo#
Una pregunta sobre el hábito que más compensa cuando un script reutiliza un prompt. Una vez que la estructura funciona, las siguientes palancas son el mensaje de sistema y la temperatura, tratados en Prompt de sistema y temperatura.
Verificación rápida
Tu script envía las mismas instrucciones con un correo nuevo cada vez. ¿Dónde debería ir el correo?
Mostrar respuesta
Respuesta: Al final, después de las instrucciones y el ejemplo
Las instrucciones se mantienen iguales entre peticiones y el correo cambia. La guía de OpenAI sugiere poner el contexto que varía cerca del final del prompt.


