AI для новичковИнструкция
Как написать хороший промпт: 5 частей и пример «до и после»
Как превратить расплывчатую просьбу в промпт с задачей, контекстом, форматом, примером и правилами и отправить его через OpenAI-совместимый API.
Содержание
В понедельник модель пересказывает письмо клиента тремя абзацами, во вторник — двумя пунктами. Промпт тот же, модель та же. Так работает просьба в одну строку: все решения она отдаёт модели, а модель каждый раз решает по-своему.
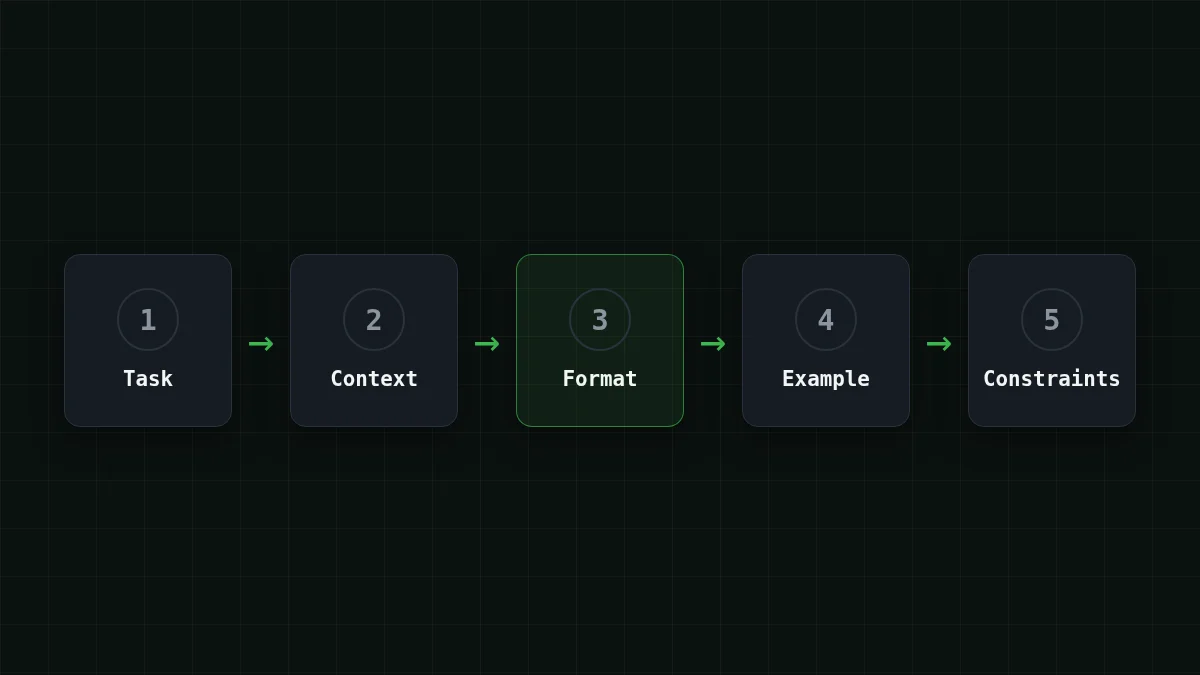
Хороший промпт отвечает на пять вопросов: что сделать (задача), с чем работать (контекст), как должен выглядеть ответ (формат), как выглядит хороший ответ (пример) и чего не делать (ограничения). Дальше расплывчатая просьба превращается в структурированную, уходит через OpenAI-совместимый API CheapTokens, и вы увидите, сколько длинный промпт добавляет к счёту.
Почему «Сделай саммари этого письма» — лотерея#
Когда вы пишете «Сделай саммари этого письма», в голове у вас уже есть ответ: одно предложение, насколько срочно, что делать дальше. Модель этой картинки не видит. Поэтому она угадывает, и каждая догадка разумна. Вместе они дают разный ответ при каждом запуске, а скрипту, который читает ответ, не за что зацепиться.
OpenAI в руководстве по prompt engineering (прочитано 27 октября 2026) говорит об этом прямо: prompt engineering — это написание эффективных инструкций, а GPT-модели работают лучше, когда им явно объясняют, как выполнить задачу. Это не только про текст. 26 октября 2026 года один Telegram-канал показал промпт для сгенерированного 30-секундного видео, разбитый на блоки: сцена, визуальный стиль, реплики, звук и исключения, технические параметры. Задача другая, приём тот же: автор назвал все решения заранее, а не оставил их модели.
Попробуйте самиПопробуйте: что модели пришлось бы угадывать по просьбе «Сделай саммари этого письма»?Показать ответ
Длину (строка или страница), адресата (вы или клиент), форму ответа (текст, пункты, JSON), что считать важным и что делать, если в письме об этом ничего нет. Каждый из этих пунктов можно закрыть промптом.
Пять частей простыми словами#
Представьте, что вы в первый день вводите коллегу в дело. «Разберись с этим» — и он угадывает. Записка с задачей, материалом, нужным форматом, образцом и «так не делай» — и вы получаете то, что имели в виду.
Задача — один глагол и один объект: «Сделай саммари письма и оцени срочность». Пишите буквально. «Помоги с этим письмом» — это не задача.
Контекст — материал, с которым работает модель: письмо, описание товара, правила. Модель знает только то, чему училась, и то, что вы вставили. Вставленный текст оборачивайте в разделители — XML-подобные теги вроде <email>…</email> или заголовки markdown, — чтобы инструкции не смешались с текстом. В руководстве OpenAI предлагают оба способа.
Формат — как выглядит ответ: «JSON с ключами summary, urgency, next_step» или «три пункта, не длиннее 12 слов». Важнее всего, когда ответ читает код.
Пример — один вход и тот ответ, который вам нужен. В руководстве советуют примеры (few-shot) на разнообразных входах с нужными ответами. Начать можно с одного; второй добавьте, когда входы сильно отличаются.
Ограничения — это «не делай»: опирайся только на факты из письма, пиши «unknown», если чего-то нет, не обещай возврат и скидки.
Порядок тоже немного важен. В том же руководстве сообщение разработчика или системное обычно идёт так: роль, инструкции, примеры, контекст, а контекст лучше ставить ближе к концу, потому что он меняется от запроса к запросу. Правила — в системное сообщение, входные данные — в сообщение пользователя.
Найдите пары
Сопоставьте часть промпта и вопрос, на который она отвечает
Нажмите на элемент слева, затем на его пару
- ЗадачаЧто должна сделать модель?
- КонтекстС каким материалом она работает?
- ФорматКак должен выглядеть ответ?
- ПримерКак выглядит хороший ответ?
- ОграниченияЧего ей делать нельзя?
До и после: письмо клиента#
Вот однострочная просьба рядом с тем же запросом из всех пяти частей. Само письмо — это контекст, он идёт в сообщении пользователя, в тегах <email>.
Сравнение
Один запрос, два промпта
До
Сделай саммари этого письма.После
Ты делаешь саммари писем клиентов для службы поддержки.

Задача: сделай саммари письма в тегах <email> и оцени, насколько оно срочное.

Формат: отвечай только JSON с ключами "summary" (одно предложение), "urgency" ("low", "medium" или "high") и "next_step" (одно короткое предложение).

Пример:
<email>Здравствуйте, заказ 1042 должны были привезти в понедельник, а сегодня четверг. Где он?</email>
{"summary": "Заказ 1042 опаздывает на три дня, клиент спрашивает, где он.", "urgency": "medium", "next_step": "Проверить трекинг перевозчика по заказу 1042 и ответить клиенту о статусе."}

Правила:
- Опирайся только на то, что написано в письме. Если чего-то нет, пиши "unknown".
- Не предлагай возврат денег и скидки.
- Ничего не выводи за пределами JSON.
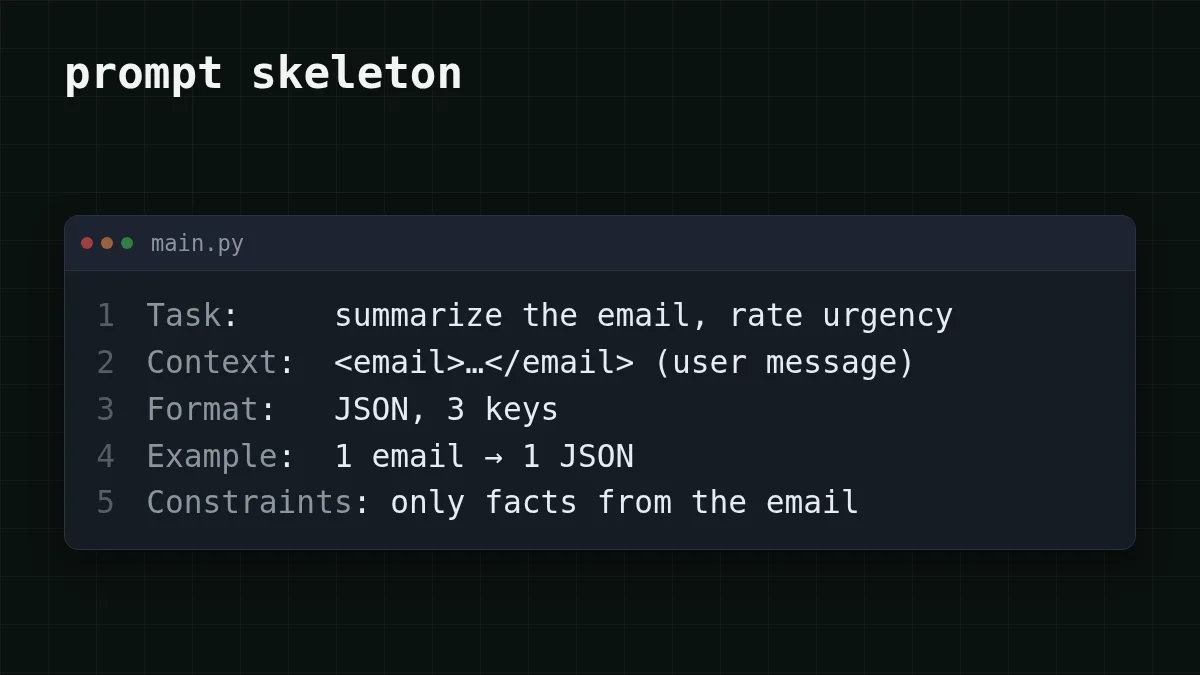
Прочитайте «после» сверху вниз, и каждую часть можно показать пальцем: первая строка и задача, строка формата, пример, правила. Самого письма в тексте нет специально. Оно меняется в каждом запросе, поэтому едет отдельно.
Отправьте его через API#
Инструкции не меняются, поэтому лежат в константе и идут первыми. Письмо меняется, поэтому идёт последним. Вот весь скрипт: OpenAI Python SDK, направленный на CheapTokens. Модель — DeepSeek-V4-Flash: контекст 380K, до 32 768 токенов в ответе, одна цена в любое время суток. Базовый адрес и id модели берите из документации CheapTokens; если ключа ещё нет, его получение разобрано в статье «Ваш первый запрос к API».
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

SYSTEM_PROMPT = """Ты делаешь саммари писем клиентов для службы поддержки.

Задача: сделай саммари письма в тегах <email> и оцени, насколько оно срочное.

Формат: отвечай только JSON с ключами "summary" (одно предложение), "urgency" ("low", "medium" или "high") и "next_step" (одно короткое предложение).

Пример:
<email>Здравствуйте, заказ 1042 должны были привезти в понедельник, а сегодня четверг. Где он?</email>
{"summary": "Заказ 1042 опаздывает на три дня, клиент спрашивает, где он.", "urgency": "medium", "next_step": "Проверить трекинг перевозчика по заказу 1042 и ответить клиенту о статусе."}

Правила:
- Опирайся только на то, что написано в письме. Если чего-то нет, пиши "unknown".
- Не предлагай возврат денег и скидки.
- Ничего не выводи за пределами JSON.
"""

email = "Здравствуйте, с меня дважды списали деньги за подписку в этом месяце. Исправьте, пожалуйста, до пятницы: на карте почти нет лимита."

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": f"<email>\n{email}\n</email>"},
    ],
)

reply = response.choices[0].message.content
print(json.loads(reply))
print(response.usage.prompt_tokens, response.usage.completion_tokens)
Если строка формата сработала, ответ — один JSON-объект с summary, urgency и next_step, а json.loads превращает его в словарь. Если вылетает ошибка, модель обернула JSON в лишний текст: ужесточите последнее правило или добавьте второй пример. Последняя строка печатает, сколько токенов ушло на вход и на выход — про это следующий раздел.
Сколько стоят лишние слова#
Токен — это кусочек слова. Вы платите за токены и того, что отправляете (вход), и того, что пишет модель (выход), а выход — более дорогая сторона. Подробнее — в статье о входных и выходных токенах.
Допустим, вы ведёте бота поддержки с 1 000 писем в день, письмо занимает около 300 токенов. Однострочная просьба добавляет примерно 10 токенов инструкции, то есть на вход уходит около 310; будем считать, что в ответ модель пишет свободный пересказ токенов на 250. Системный промпт выше занимает около 200 токенов, плюс примерно 10 на теги <email>, то есть на вход уходит около 500; будем считать, что строка формата удерживает ответ в пределах JSON токенов на 80. На DeepSeek-V4-Flash это $0.00003 за письмо при однострочной просьбе и $0.000016 при структурированном промпте. Промпт стал длиннее, а запрос — дешевле: длинная часть — это вход, а сократили вы выход. Запустите скрипт и подставьте вместо этих допущений свои prompt_tokens и completion_.
Вот структурированный промпт на 1 000 писем в день по всем моделям. В сумме, с учётом входа и выхода, CheapTokens на этой нагрузке выходит дешевле референсной цены OpenRouter; актуальные цены — на странице цен.
| Модель | Вход $/1M | Выход $/1M | За запрос | 1 000 запросов | OpenRouter, 1 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000013 | $0.0132 | $0.0234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000016 | $0.0155 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000037 | $0.037 | $0.444 |
500 входных и 80 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Проверьте себя#
Один вопрос про привычку, которая окупается больше всего, когда скрипт использует промпт повторно. Когда структура заработала, следующие ручки — системное сообщение и температура, они разобраны в статье «System prompt и temperature».
Быстрая проверка
Скрипт отправляет одни и те же инструкции и каждый раз новое письмо. Куда поставить письмо?
Показать ответ
Ответ: В конец, после инструкций и примера
Инструкции между запросами не меняются, а письмо меняется. В руководстве OpenAI советуют ставить контекст, который меняется, ближе к концу промпта.


