IA pour débutantsGuide
Comment écrire un bon prompt : 5 parties et un exemple avant/après
Transformez une requête vague d'une ligne en un prompt avec tâche, contexte, format, exemple et règles, puis envoyez-le via une API compatible OpenAI.
Sur cette page
Votre modèle résume un e-mail client en trois paragraphes le lundi et en deux puces le mardi. Même prompt, même modèle. C'est ce que fait une requête d'une ligne : elle laisse chaque décision au modèle, et le modèle décide différemment à chaque fois.
Un bon prompt répond à cinq questions : quoi faire (tâche), avec quoi travailler (contexte), à quoi la réponse doit ressembler (format), à quoi ressemble une bonne réponse (exemple) et ce qu'il faut éviter (contraintes). Ci-dessous, une requête vague devient structurée, passe par l'API CheapTokens compatible OpenAI, et vous voyez ce que le prompt plus long ajoute à la facture.
Pourquoi « Résume cet e-mail » est un pari#
Quand vous tapez « Résume cet e-mail », vous avez déjà une réponse en tête : une phrase, le degré d'urgence, la prochaine action. Le modèle ne voit pas cette image. Alors il devine, et chaque supposition est raisonnable. Ensemble, elles vous donnent une réponse différente à chaque exécution, et un script qui lit la réponse n'a rien de stable à parser.
Le guide d'ingénierie de prompt d'OpenAI (lu le 27 octobre 2026) énonce l'idée simplement : l'ingénierie de prompt consiste à écrire des instructions efficaces, et les modèles GPT font mieux quand vous leur dites explicitement comment accomplir une tâche. L'habitude ne se limite pas au texte. Le 26 octobre 2026, un canal Telegram a partagé un prompt pour une vidéo générée de 30 secondes, découpé en blocs : scène, style visuel, dialogue, audio et exclusions, spécifications techniques. Tâche différente, même geste. L'auteur a nommé chaque décision en amont au lieu de la laisser au modèle.
Essayez vous-mêmeEssayez : que devrait deviner un modèle à partir de « Résume cet e-mail » ?Afficher la réponse
La longueur (une ligne ou une page), le public (vous ou le client), la forme de la réponse (prose, puces, JSON), ce qui compte comme important, et quoi faire quand l'e-mail ne le dit pas. Chacun de ces points est quelque chose qu'un prompt peut régler.
Les cinq parties, en mots simples#
Pensez à un nouveau collègue qu'on briefe le premier jour. « Occupe-toi de ça » vous vaut une supposition. Un post-it avec le travail, le matériel, le format voulu, un exemple et un « à ne pas faire » vous donne ce que vous vouliez dire.
Tâche : un verbe et un objet : « Résume l'e-mail et évalue son urgence. » Soyez littéral. « Aide-moi avec cet e-mail » n'est pas une tâche.
Contexte : le matériel sur lequel le modèle travaille : l'e-mail, une description produit, une politique. Le modèle ne sait que ce qu'il a appris à l'entraînement plus ce que vous collez. Encadrez le texte collé par des délimiteurs, comme des balises de style XML telles que <email>…</email> ou des en-têtes markdown, pour que vos instructions ne puissent pas être confondues avec le texte. Le guide d'OpenAI suggère les deux.
Format : à quoi ressemble la réponse : « JSON avec les clés summary, urgency, next_step » ou « trois puces, 12 mots maximum chacune ». C'est le plus important quand du code lit la réponse.
Exemple : une entrée avec la sortie que vous voulez. Le guide recommande des exemples few-shot qui couvrent une gamme diversifiée d'entrées avec les sorties souhaitées. Un exemple est un bon début ; ajoutez-en un second quand vos entrées diffèrent beaucoup.
Contraintes : les « à ne pas faire » : n'utiliser que les faits de l'e-mail, écrire « unknown » quand une information manque, pas de remboursements ni de remises.
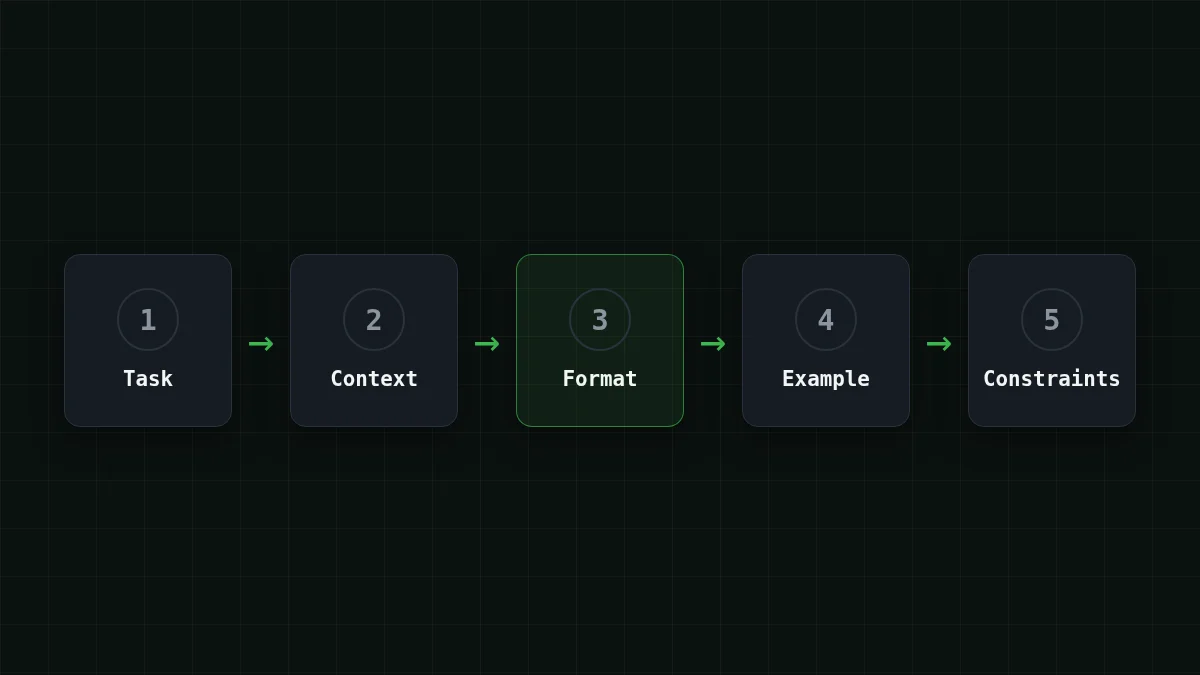
L'ordre compte aussi un peu. Le même guide indique qu'un message développeur ou système suit généralement identité, instructions, exemples, contexte, et que le contexte va près de la fin parce qu'il change entre les requêtes. Les règles vont dans le message système ; l'entrée va dans le message utilisateur.
Associer les paires
Associez chaque partie d'un prompt à la question à laquelle elle répond
Touchez un élément à gauche, puis sa paire
- TâcheQue doit faire le modèle ?
- ContexteSur quel matériel travaille-t-il ?
- FormatÀ quoi la réponse doit-elle ressembler ?
- ExempleÀ quoi ressemble une bonne réponse ?
- ContraintesQue ne doit-il pas faire ?
Avant et après : un e-mail client#
Voici la requête d'une ligne à côté de la même demande avec les cinq parties. L'e-mail lui-même est le contexte, et il va dans le message utilisateur, entouré de balises <email>.
Comparer
Une requête, deux prompts
Avant
Summarize this email.Après
You summarize customer emails for a support team.

Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
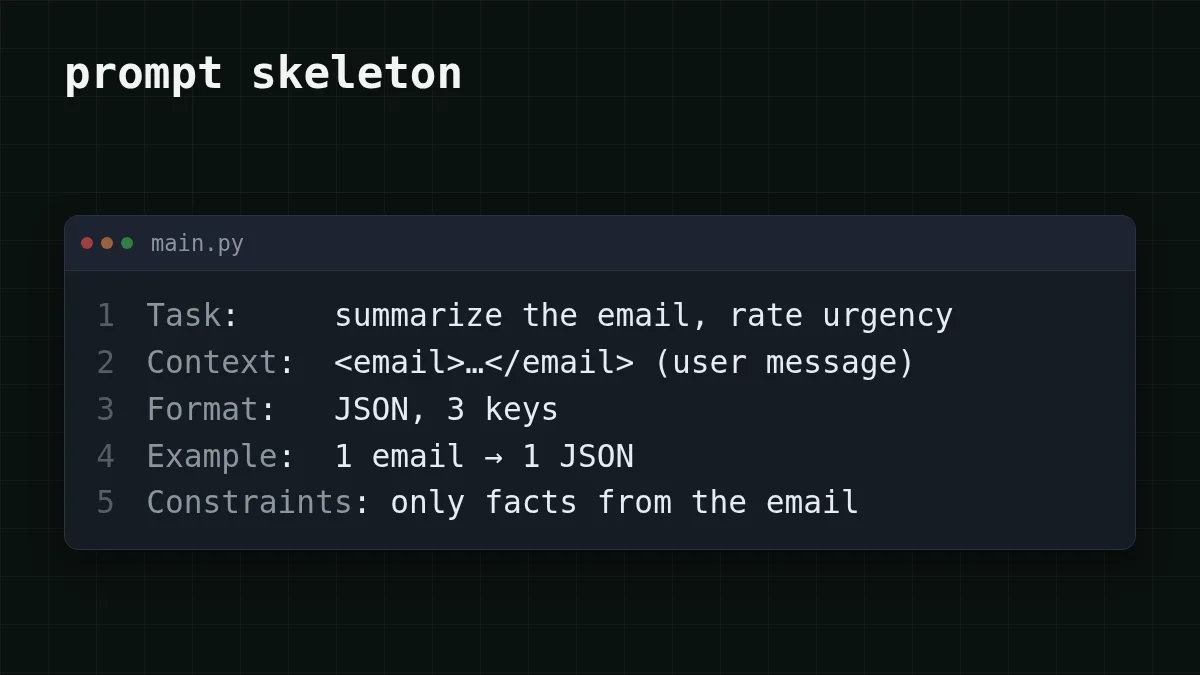
Lisez l'« après » de haut en bas et vous pouvez pointer chaque partie : la ligne d'ouverture et la tâche, la ligne de format, l'exemple, les règles. L'e-mail est absent du texte à dessein. Il change à chaque requête, donc il voyage séparément.
Envoyez-le via l'API#
Les instructions ne changent jamais, donc elles vivent dans une constante et passent en premier. L'e-mail change, donc il passe en dernier. Voici le script complet, utilisant le SDK Python d'OpenAI pointé vers CheapTokens. Le modèle est DeepSeek-V4-Flash : contexte 380K, jusqu'à 32 768 jetons de sortie par réponse, un prix à toute heure. Prenez l'URL de base et l'id du modèle dans la documentation CheapTokens ; si vous n'avez pas encore de clé, votre première requête API vous guide.
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

SYSTEM_PROMPT = """You summarize customer emails for a support team.

Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
"""

email = "Hello, I was charged twice for my subscription this month. Please fix it before Friday, my card is almost at its limit."

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": f"<email>\n{email}\n</email>"},
    ],
)

reply = response.choices[0].message.content
print(json.loads(reply))
print(response.usage.prompt_tokens, response.usage.completion_tokens)
Si la ligne de format a fait son travail, la réponse est un objet JSON avec summary, urgency et next_step, et json.loads le transforme en dictionnaire. Si cela lève une erreur, le modèle a enveloppé le JSON dans du texte supplémentaire : resserrez la dernière règle ou ajoutez un second exemple. La dernière ligne affiche combien de jetons sont entrés et sortis, ce qui est le chiffre dont parle la section suivante.
Ce que coûtent les mots en plus#
Un jeton est un morceau de mot. Vous payez par jeton ce que vous envoyez (entrée) et ce que le modèle écrit (sortie), et la sortie est le côté le plus cher. Plus de détails dans jetons d'entrée vs de sortie.
Supposons que vous faites tourner un bot de support avec 1 000 e-mails par jour, et que l'e-mail fait environ 300 jetons. La requête d'une ligne ajoute environ 10 jetons d'instruction, donc environ 310 entrent ; nous supposons qu'elle obtient un résumé libre d'environ 250 jetons. Le prompt système ci-dessus fait environ 200 jetons, plus environ 10 pour les balises <email>, donc environ 500 entrent ; nous supposons que la ligne de format maintient la réponse à un JSON d'environ 80 jetons. Sur DeepSeek-V4-Flash, cela fait $0.00003 par e-mail pour la requête d'une ligne et $0.000016 pour le prompt structuré. Le prompt s'est allongé, mais la requête est devenue moins chère, parce que la partie longue est l'entrée et la partie que vous avez raccourcie est la sortie. Lancez le script et remplacez ces hypothèses par vos propres prompt_tokens et completion_.
Voici le prompt structuré à 1 000 e-mails par jour selon les modèles. Au total, entrée et sortie comptées ensemble, CheapTokens revient moins cher que le prix de référence d'OpenRouter sur cette charge de travail ; les prix actuels sont sur la page de tarification.
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000013 | $0.0132 | $0.0234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000016 | $0.0155 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000037 | $0.037 | $0.444 |
500 tokens d'entrée et 80 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Vérifiez-vous#
Une question sur l'habitude qui rapporte le plus quand un script réutilise un prompt. Une fois que la structure fonctionne, les prochains réglages sont le message système et la température, traités dans Prompt système et température.
Vérification rapide
Votre script envoie les mêmes instructions avec un nouvel e-mail à chaque fois. Où doit aller l'e-mail ?
Afficher la réponse
Réponse: À la fin, après les instructions et l'exemple
Les instructions restent les mêmes entre les requêtes et l'e-mail change. Le guide d'OpenAI suggère de placer le contexte qui varie près de la fin du prompt.


