KI für EinsteigerAnleitung
Wie man einen guten Prompt schreibt: 5 Teile und ein Vorher/Nachher-Beispiel
Verwandle eine vage einzeilige Anfrage in einen Prompt mit Aufgabe, Kontext, Format, Beispiel und Regeln und sende ihn dann durch eine OpenAI-kompatible API.
Auf dieser Seite
Dein Modell fasst eine Kunden-E-Mail am Montag in drei Absätzen und am Dienstag in zwei Aufzählungspunkten zusammen. Gleicher Prompt, gleiches Modell. Das ist es, was eine einzeilige Anfrage bewirkt: Sie überlässt jede Entscheidung dem Modell, und das Modell entscheidet jedes Mal anders.
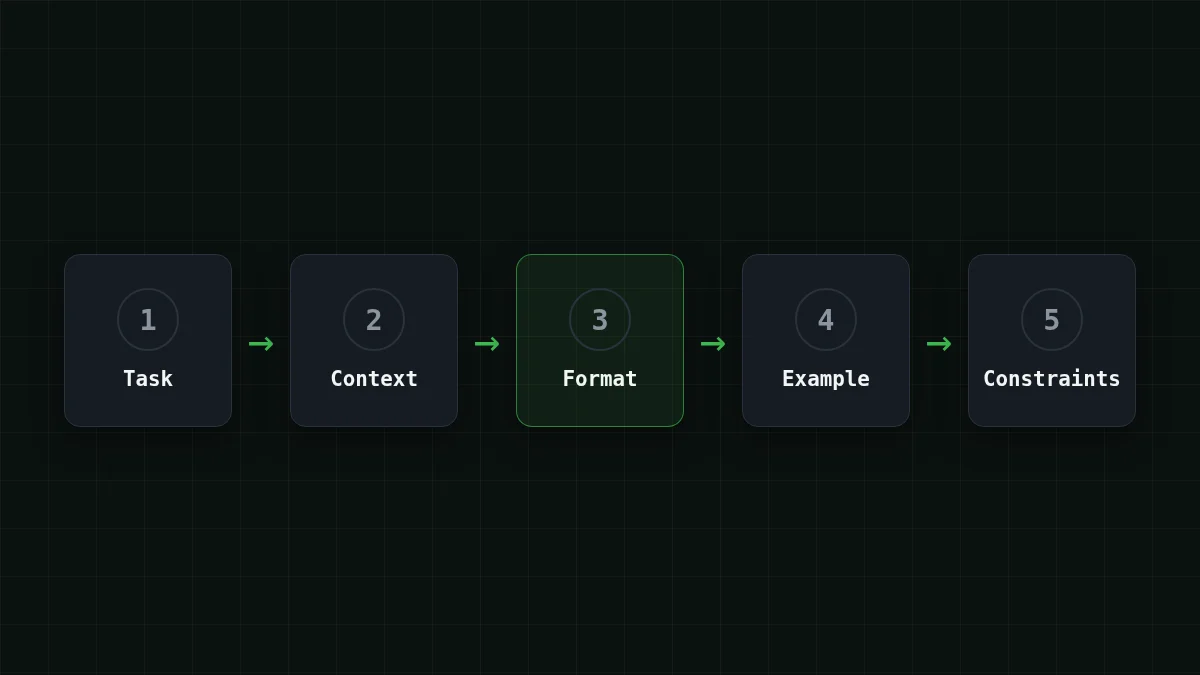
Ein guter Prompt beantwortet fünf Fragen: Was zu tun ist (Aufgabe), womit gearbeitet wird (Kontext), wie die Antwort aussehen soll (Format), wie eine gute Antwort aussieht (Beispiel) und was zu vermeiden ist (Einschränkungen). Unten wird aus einer vagen Anfrage eine strukturierte, sie geht durch die OpenAI-kompatible CheapTokens-API, und du siehst, was der längere Prompt zur Rechnung hinzufügt.
Warum "Fasse diese E-Mail zusammen" ein Glücksspiel ist#
Wenn du "Fasse diese E-Mail zusammen" eintippst, hast du bereits eine Antwort im Kopf: ein Satz, wie dringend es ist, was als Nächstes zu tun ist. Das Modell kann dieses Bild nicht sehen. Also rät es, und jeder Rateversuch ist vernünftig. Zusammen ergeben sie bei jedem Durchlauf eine andere Antwort, und ein Skript, das die Antwort liest, hat nichts Stabiles zum Parsen.
OpenAIs Prompt-Engineering-Leitfaden (gelesen am 27. Oktober 2026) bringt die Idee auf den Punkt: Prompt-Engineering ist das Schreiben effektiver Anweisungen, und GPT-Modelle schneiden besser ab, wenn du ihnen explizit sagst, wie eine Aufgabe zu erledigen ist. Die Gewohnheit beschränkt sich nicht auf Text. Am 26. Oktober 2026 teilte ein Telegram-Kanal einen Prompt für ein 30-sekündiges generiertes Video, der in Blöcke aufgeteilt war: Szene, visueller Stil, Dialog, Audio und Ausschlüsse, technische Spezifikationen. Andere Aufgabe, gleicher Zug. Der Autor benannte jede Entscheidung im Voraus, anstatt sie dem Modell zu überlassen.
Probier es selbstProbier es aus: Was müsste ein Modell aus "Fasse diese E-Mail zusammen" erraten?Antwort anzeigen
Die Länge (eine Zeile oder eine Seite), die Zielgruppe (du oder der Kunde), die Form der Antwort (Prosa, Aufzählungspunkte, JSON), was als wichtig gilt und was zu tun ist, wenn die E-Mail nichts sagt. Jedes davon kann ein Prompt klären.
Die fünf Teile, in einfachen Worten#
Stell dir vor, du weist einen neuen Kollegen an seinem ersten Tag ein. "Kümmere dich um diese" bringt dir einen Rateversuch ein. Ein Haftzettel mit der Aufgabe, dem Material, dem gewünschten Format, einem Beispiel und einem "nicht" bringt dir, was du gemeint hast.
Aufgabe ist ein Verb und ein Objekt: "Fasse die E-Mail zusammen und bewerte ihre Dringlichkeit." Sei wörtlich. "Hilf mit dieser E-Mail" ist keine Aufgabe.
Kontext ist das Material, mit dem das Modell arbeitet: die E-Mail, eine Produktbeschreibung, eine Richtlinie. Das Modell weiß nur, was es im Training gelernt hat, plus was du einfügst. Umschließe eingefügten Text mit Trennzeichen, wie XML-artigen Tags wie <email>…</email> oder Markdown-Überschriften, damit deine Anweisungen nicht mit dem Text verwechselt werden können. OpenAIs Leitfaden schlägt beides vor.
Format ist, wie die Antwort aussieht: "JSON mit den Schlüsseln summary, urgency, next_step" oder "drei Aufzählungspunkte, je höchstens 12 Wörter". Es zählt am meisten, wenn Code die Antwort liest.
Beispiel ist eine Eingabe mit der gewünschten Ausgabe. Der Leitfaden empfiehlt Few-Shot-Beispiele, die eine vielfältige Bandbreite von Eingaben mit den gewünschten Ausgaben abdecken. Ein Beispiel ist ein guter Anfang; füge ein zweites hinzu, wenn deine Eingaben stark variieren.
Einschränkungen sind die "Don'ts": nur Fakten aus der E-Mail verwenden, "unbekannt" schreiben, wenn etwas fehlt, keine Rückerstattungen oder Rabatte.
Die Reihenfolge spielt auch eine kleine Rolle. Derselbe Leitfaden sagt, dass eine Entwickler- oder Systemnachricht üblicherweise Identität, Anweisungen, Beispiele, Kontext enthält und dass Kontext nahe am Ende steht, weil er sich zwischen Anfragen ändert. Regeln gehören in die Systemnachricht; die Eingabe in die Benutzernachricht.
Paare zuordnen
Ordne jeden Teil eines Prompts der Frage zu, die er beantwortet
Tippe auf ein Element links, dann auf sein Paar
- AufgabeWas soll das Modell tun?
- KontextMit welchem Material arbeitet es?
- FormatWie soll die Antwort aussehen?
- BeispielWie sieht eine gute Antwort aus?
- EinschränkungenWas darf es nicht tun?
Vorher und nachher: eine Kunden-E-Mail#
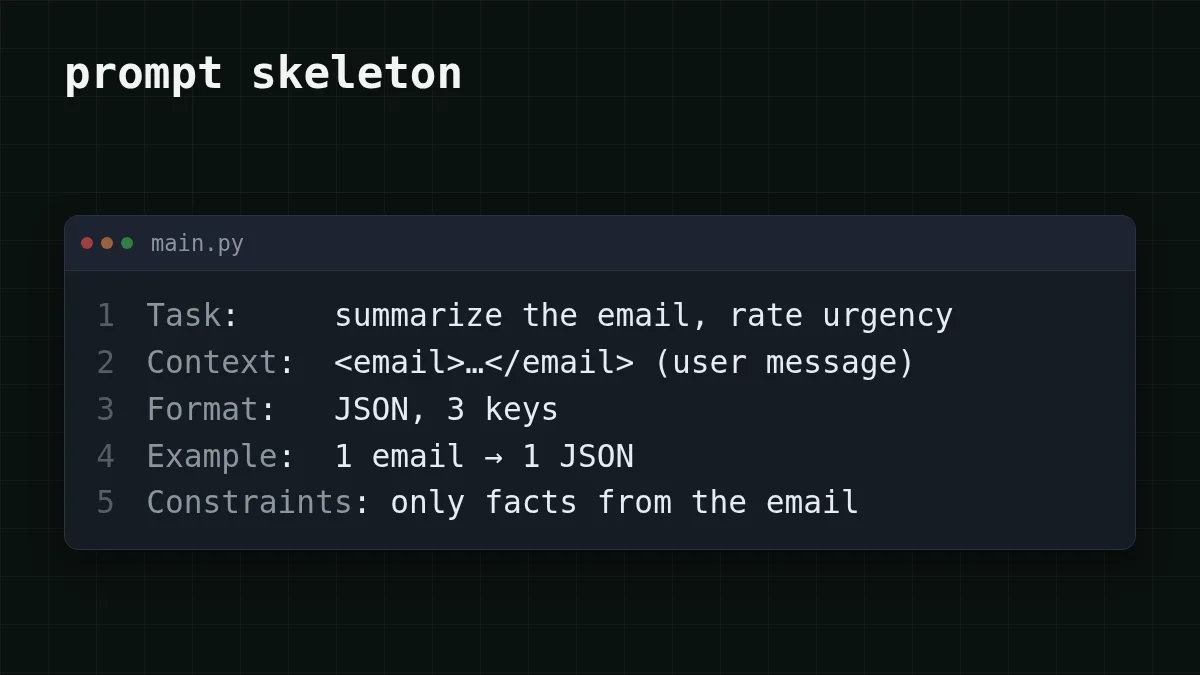
Hier ist der Einzeiler neben derselben Anfrage mit allen fünf Teilen. Die E-Mail selbst ist der Kontext, und sie kommt in die Benutzernachricht, umschlossen von <email>-Tags.
Vergleichen
Eine Anfrage, zwei Prompts
Vorher
Summarize this email.Nachher
You summarize customer emails for a support team.

Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
Lies das "Nachher" von oben nach unten und du kannst auf jeden Teil zeigen: die Eröffnungszeile und die Aufgabe, die Formatzeile, das Beispiel, die Regeln. Die E-Mail fehlt absichtlich im Text. Sie ändert sich mit jeder Anfrage, also reist sie separat.
Sende es durch die API#
Die Anweisungen ändern sich nie, also leben sie in einer Konstante und kommen zuerst. Die E-Mail ändert sich, also kommt sie zuletzt. Das ist das ganze Skript, mit dem OpenAI Python SDK, das auf CheapTokens zeigt. Das Modell ist DeepSeek-V4-Flash: 380K Kontext, bis zu 32.768 Ausgabe-Tokens pro Antwort, ein Preis zu jeder Stunde. Nimm die Basis-URL und die Modell-ID aus den CheapTokens-Dokumenten; wenn du noch keinen Schlüssel hast, führt dich deine erste API-Anfrage durch.
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

SYSTEM_PROMPT = """You summarize customer emails for a support team.

Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
"""

email = "Hello, I was charged twice for my subscription this month. Please fix it before Friday, my card is almost at its limit."

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": f"<email>\n{email}\n</email>"},
    ],
)

reply = response.choices[0].message.content
print(json.loads(reply))
print(response.usage.prompt_tokens, response.usage.completion_tokens)
Wenn die Formatzeile ihre Aufgabe erfüllt hat, ist die Antwort ein JSON-Objekt mit summary, urgency und next_step, und json.loads verwandelt es in ein Dictionary. Wenn es einen Fehler auslöst, hat das Modell das JSON in zusätzlichen Text gehüllt: verschärfe die letzte Regel oder füge ein zweites Beispiel hinzu. Die letzte Zeile gibt aus, wie viele Tokens hinein- und hinausgingen, was die Zahl ist, um die es im nächsten Abschnitt geht.
Was die zusätzlichen Wörter kosten#
Ein Token ist ein Stück eines Wortes. Du zahlst pro Token für das, was du sendest (Eingabe) und für das, was das Modell schreibt (Ausgabe), und Ausgabe ist die teurere Seite. Mehr dazu in Eingabe- vs. Ausgabe-Tokens.
Angenommen, du betreibst einen Support-Bot mit 1.000 E-Mails pro Tag, und die E-Mail umfasst etwa 300 Tokens. Der Einzeiler fügt ungefähr 10 Tokens Anweisung hinzu, also gehen etwa 310 hinein; wir nehmen an, er erhält eine freie Zusammenfassung von etwa 250 Tokens. Der obige System-Prompt umfasst etwa 200 Tokens, plus ungefähr 10 für die <email>-Tags, also gehen etwa 500 hinein; wir nehmen an, die Formatzeile hält die Antwort auf ein JSON von etwa 80 Tokens. Auf DeepSeek-V4-Flash sind das $0.00003 pro E-Mail für den Einzeiler und $0.000016 für den strukturierten Prompt. Der Prompt wurde länger, aber die Anfrage wurde günstiger, weil der lange Teil die Eingabe ist und der Teil, den du verkürzt hast, die Ausgabe. Führe das Skript aus und ersetze diese Annahmen durch deine eigenen prompt_tokens und completion_.
Hier ist der strukturierte Prompt bei 1.000 E-Mails pro Tag über die Modelle hinweg. Insgesamt, mit Eingabe und Ausgabe zusammen gezählt, kommt CheapTokens bei dieser Arbeitslast günstiger weg als der Referenzpreis von OpenRouter; die aktuellen Preise stehen auf der Preisseite.
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000013 | $0.0132 | $0.0234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000016 | $0.0155 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000037 | $0.037 | $0.444 |
500 Input- und 80 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Überprüfe dich selbst#
Eine Frage zur Gewohnheit, die sich am meisten auszahlt, wenn ein Skript einen Prompt wiederverwendet. Sobald die Struktur funktioniert, sind die nächsten Stellschrauben die Systemnachricht und die Temperatur, behandelt in System-Prompt und Temperatur.
Kurzer Check
Dein Skript sendet jedes Mal dieselben Anweisungen mit einer neuen E-Mail. Wohin sollte die E-Mail gehen?
Antwort anzeigen
Antwort: Am Ende, nach den Anweisungen und dem Beispiel
Die Anweisungen bleiben zwischen Anfragen gleich und die E-Mail ändert sich. OpenAIs Leitfaden schlägt vor, Kontext, der variiert, nahe am Ende des Prompts zu platzieren.


