AI dla początkującychPrzewodnik
Jak napisać dobry prompt: 5 części i przykład przed/po
Zamień niejasne jednowierszowe polecenie w prompt z zadaniem, kontekstem, formatem, przykładem i regułami, a potem wyślij go przez API zgodne z OpenAI.
Na tej stronie
Twój model streszcza e-mail od klienta w trzech akapitach w poniedziałek, a we wtorek w dwóch punktach. Ten sam prompt, ten sam model. To właśnie robi jednowierszowe polecenie: zostawia każdą decyzję modelowi, a model decyduje za każdym razem inaczej.
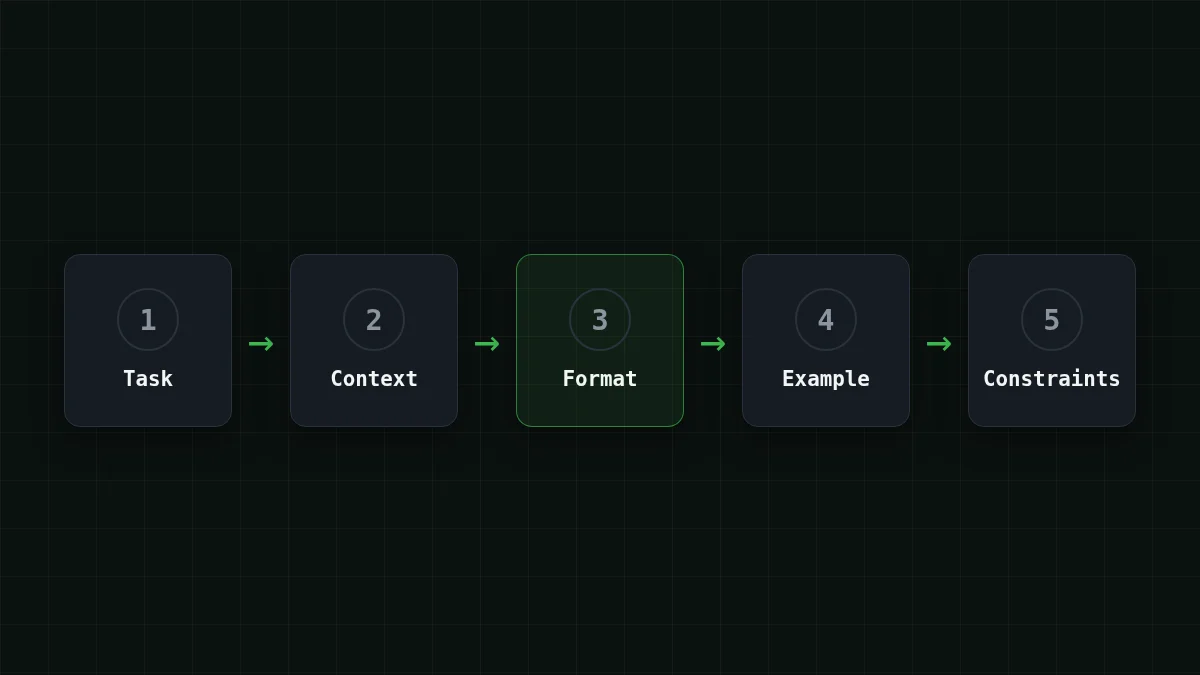
Dobry prompt odpowiada na pięć pytań: co zrobić (zadanie), z czym pracować (kontekst), jak powinna wyglądać odpowiedź (format), jak wygląda dobra odpowiedź (przykład) i czego unikać (ograniczenia). Poniżej jedno niejasne polecenie staje się uporządkowanym, przechodzi przez zgodne z OpenAI API CheapTokens, a Ty widzisz, co dłuższy prompt dodaje do rachunku.
Dlaczego „Streść ten e-mail” to loteria#
Kiedy wpisujesz „Streść ten e-mail”, masz już w głowie odpowiedź: jedno zdanie, jak pilne, co dalej zrobić. Model nie widzi tego obrazu. Więc zgaduje, a każde zgadnięcie jest sensowne. Razem dają inną odpowiedź przy każdym uruchomieniu, a skrypt, który czyta odpowiedź, nie ma nic stabilnego do sparsowania.
Przewodnik OpenAI po prompt engineeringu (przeczytany 27 października 2026) ujmuje to wprost: prompt engineering to pisanie skutecznych instrukcji, a modele GPT radzą sobie lepiej, gdy powiesz im wyraźnie, jak wykonać zadanie. Nawyk nie ogranicza się do tekstu. 26 października 2026 jeden kanał na Telegramie udostępnił prompt do 30-sekundowego wygenerowanego wideo, podzielony na bloki: scena, styl wizualny, dialog, dźwięk i wykluczenia, specyfikacje techniczne. Inne zadanie, ten sam ruch. Autor nazwał każdą decyzję z góry, zamiast zostawiać ją modelowi.
Spróbuj samWypróbuj: co model musiałby zgadnąć z „Streść ten e-mail”?Pokaż odpowiedź
Długość (jedna linia czy strona), odbiorcę (Ty czy klient), kształt odpowiedzi (proza, punkty, JSON), co się liczy jako ważne i co zrobić, gdy e-mail tego nie mówi. Każda z tych rzeczy to coś, co prompt może ustalić.
Pięć części, prostymi słowami#
Pomyśl o wprowadzaniu nowego kolegi w pierwszym dniu pracy. „Zajmij się tym” daje Ci zgadywanie. Karteczka z zadaniem, materiałem, formatem, jakiego chcesz, przykładem i „nie rób tego” daje Ci to, co miałeś na myśli.
Zadanie to jeden czasownik i jeden obiekt: „Streść e-mail i oceń jego pilność”. Bądź dosłowny. „Pomóż z tym e-mailem” to nie zadanie.
Kontekst to materiał, na którym pracuje model: e-mail, opis produktu, polityka. Model wie tylko to, czego nauczył się podczas treningu, plus to, co wkleisz. Otocz wklejony tekst delimiterami, takimi jak tagi w stylu XML, np. <email>…</email>, albo nagłówkami markdown, żeby Twoje instrukcje nie pomieszały się z tekstem. Przewodnik OpenAI sugeruje jedno i drugie.
Format to to, jak wygląda odpowiedź: „JSON z kluczami summary, urgency, next_step” albo „trzy punkty, po maksymalnie 12 słów każdy”. Ma największe znaczenie, gdy kod czyta odpowiedź.
Przykład to jedno wejście z wyjściem, jakiego chcesz. Przewodnik zaleca przykłady few-shot, które obejmują różnorodny zakres wejść z pożądanymi wyjściami. Jeden przykład to dobry początek; dodaj drugi, gdy Twoje wejścia bardzo się różnią.
Ograniczenia to „nie rób”: używaj tylko faktów z e-maila, pisz „unknown”, gdy czegoś brakuje, żadnych zwrotów ani rabatów.
Kolejność też ma trochę znaczenia. Ten sam przewodnik mówi, że wiadomość dewelopera lub systemowa zwykle idzie tak: tożsamość, instrukcje, przykłady, kontekst, a kontekst należy umieścić blisko końca, bo zmienia się między żądaniami. Reguły idą do wiadomości systemowej; wejście idzie do wiadomości użytkownika.
Dopasuj pary
Dopasuj każdą część promptu do pytania, na które odpowiada
Dotknij element po lewej, a następnie jego parę
- ZadanieCo model ma zrobić?
- KontekstNa jakim materiale pracuje?
- FormatJak powinna wyglądać odpowiedź?
- PrzykładJak wygląda dobra odpowiedź?
- OgraniczeniaCzego nie wolno mu robić?
Przed i po: e-mail od klienta#
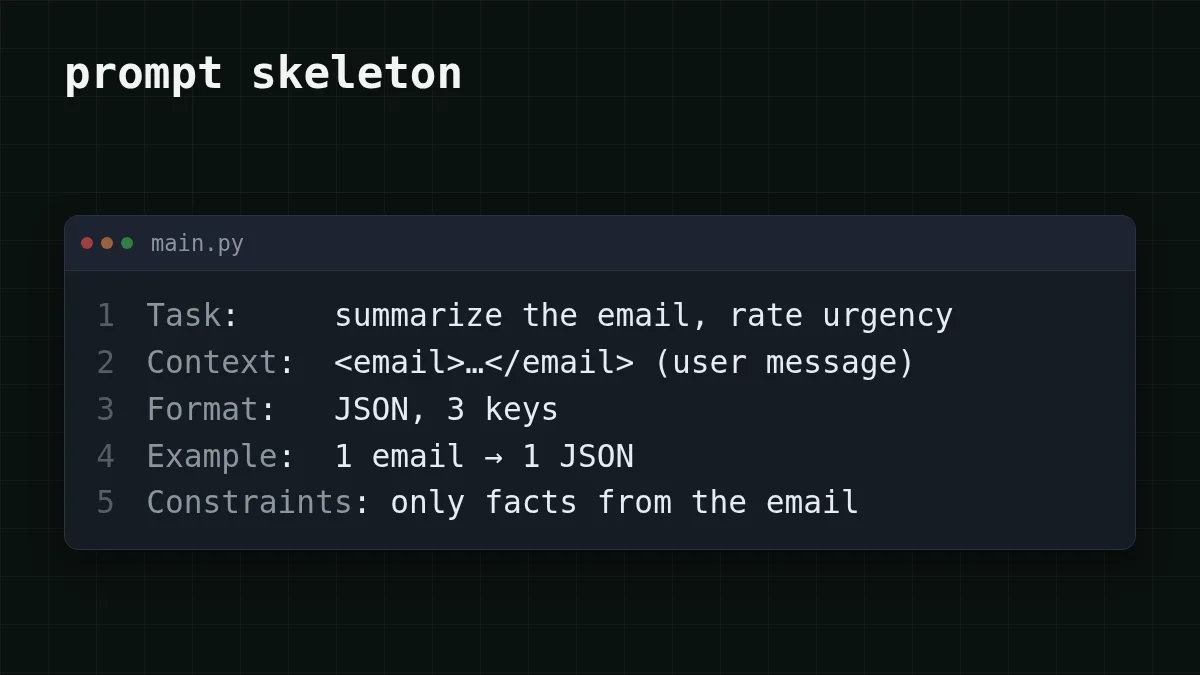
Oto jednowierszowiec obok tego samego żądania ze wszystkimi pięcioma częściami. Sam e-mail jest kontekstem i trafia do wiadomości użytkownika, owinięty tagami <email>.
Porównaj
Jedno żądanie, dwa prompty
Przed
Summarize this email.Po
You summarize customer emails for a support team.

Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
Przeczytaj „po” od góry do dołu i możesz wskazać każdą część: wiersz otwierający i zadanie, wiersz formatu, przykład, reguły. E-mail celowo nie występuje w tekście. Zmienia się przy każdym żądaniu, więc podróżuje osobno.
Wyślij to przez API#
Instrukcje nigdy się nie zmieniają, więc żyją w stałej i idą pierwsze. E-mail się zmienia, więc idzie ostatni. To cały skrypt, używający OpenAI Python SDK wskazanego na CheapTokens. Model to DeepSeek-V4-Flash: kontekst 380K, do 32 768 tokenów wyjściowych na odpowiedź, jedna cena o każdej porze. Weź bazowy URL i identyfikator modelu z dokumentacji CheapTokens; jeśli nie masz jeszcze klucza, Twoje pierwsze żądanie API przeprowadzi Cię przez to.
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

SYSTEM_PROMPT = """You summarize customer emails for a support team.

Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
"""

email = "Hello, I was charged twice for my subscription this month. Please fix it before Friday, my card is almost at its limit."

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": f"<email>\n{email}\n</email>"},
    ],
)

reply = response.choices[0].message.content
print(json.loads(reply))
print(response.usage.prompt_tokens, response.usage.completion_tokens)
Jeśli wiersz formatu zrobił swoje, odpowiedź to jeden obiekt JSON z summary, urgency i next_step, a json.loads zamienia go w słownik. Jeśli zgłosi błąd, model owinął JSON w dodatkowy tekst: zaostrz ostatnią regułę albo dodaj drugi przykład. Ostatnia linia wypisuje, ile tokenów weszło i wyszło, a to liczba, o której jest następna sekcja.
Ile kosztują dodatkowe słowa#
Token to kawałek słowa. Płacisz za token za to, co wysyłasz (wejście) i za to, co pisze model (wyjście), a wyjście jest droższą stroną. Więcej o tym w tokeny wejściowe vs wyjściowe.
Załóżmy, że prowadzisz bota wsparcia z 1000 e-maili dziennie, a e-mail ma około 300 tokenów. Jednowierszowiec dodaje około 10 tokenów instrukcji, więc wchodzi około 310; zakładamy, że dostaje swobodne streszczenie o długości około 250 tokenów. Powyższy prompt systemowy ma około 200 tokenów, plus około 10 na tagi <email>, więc wchodzi około 500; zakładamy, że wiersz formatu utrzymuje odpowiedź w JSON o długości około 80 tokenów. Na DeepSeek-V4-Flash to $0.00003 za e-mail dla jednowierszowca i $0.000016 dla uporządkowanego promptu. Prompt się wydłużył, ale żądanie potaniało, bo długa część to wejście, a część, którą skróciłeś, to wyjście. Uruchom skrypt i zamień te założenia na własne prompt_tokens i completion_.
Oto uporządkowany prompt przy 1000 e-maili dziennie w różnych modelach. W sumie, licząc wejście i wyjście razem, CheapTokens wypada taniej niż cena referencyjna OpenRouter dla tego obciążenia; aktualne ceny są na stronie z cennikiem.
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000013 | $0.0132 | $0.0234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000016 | $0.0155 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000037 | $0.037 | $0.444 |
500 tokenów wejściowych i 80 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Sprawdź się#
Jedno pytanie o nawyk, który najbardziej się opłaca, gdy skrypt ponownie używa promptu. Gdy struktura działa, kolejnymi pokrętłami są wiadomość systemowa i temperatura, omówione w Prompt systemowy i temperatura.
Szybkie sprawdzenie
Twój skrypt wysyła te same instrukcje z nowym e-mailem za każdym razem. Gdzie powinien trafić e-mail?
Pokaż odpowiedź
Odpowiedź: Na końcu, po instrukcjach i przykładzie
Instrukcje pozostają takie same między żądaniami, a e-mail się zmienia. Przewodnik OpenAI sugeruje umieszczanie kontekstu, który się zmienia, blisko końca promptu.


