AI per principiantiGuida
Come scrivere un buon prompt: 5 parti e un esempio prima/dopo
Trasforma una vaga richiesta di una riga in un prompt con task, contesto, formato, esempio e regole, poi invialo attraverso un'API compatibile con OpenAI.
In questa pagina
Il tuo modello riassume un'email di un cliente in tre paragrafi il lunedì e in due punti elenco il martedì. Stesso prompt, stesso modello. Ecco cosa fa una richiesta di una riga: lascia ogni decisione al modello, e il modello decide diversamente ogni volta.
Un buon prompt risponde a cinque domande: cosa fare (task), con cosa lavorare (contesto), che aspetto deve avere la risposta (formato), che aspetto ha una buona risposta (esempio) e cosa evitare (vincoli). Qui sotto, una richiesta vaga diventa strutturata, passa attraverso l'API CheapTokens compatibile con OpenAI, e vedi quanto il prompt più lungo aggiunge alla fattura.
Perché "Riassumi questa email" è un azzardo#
Quando scrivi "Riassumi questa email", hai già in mente una risposta: una frase, quanto è urgente, cosa fare dopo. Il modello non vede quell'immagine. Quindi tira a indovinare, e ogni ipotesi è ragionevole. Insieme ti danno una risposta diversa a ogni esecuzione, e uno script che legge la risposta non ha nulla di stabile da analizzare.
La guida al prompt engineering di OpenAI (letta il 27 ottobre 2026) mette la cosa in chiaro: il prompt engineering è scrivere istruzioni efficaci, e i modelli GPT fanno meglio quando dici loro esplicitamente come svolgere un compito. L'abitudine non è limitata al testo. Il 26 ottobre 2026 un canale Telegram ha condiviso un prompt per un video generato di 30 secondi suddiviso in blocchi: scena, stile visivo, dialogo, audio ed esclusioni, specifiche tecniche. Compito diverso, stessa mossa. L'autore ha nominato ogni decisione in anticipo invece di lasciarla al modello.
Provalo tu stessoProvalo: cosa dovrebbe indovinare un modello da "Riassumi questa email"?Mostra risposta
La lunghezza (una riga o una pagina), il pubblico (tu o il cliente), la forma della risposta (prosa, punti elenco, JSON), cosa conta come importante, e cosa fare quando l'email non lo dice. Ognuno di questi è qualcosa che un prompt può risolvere.
Le cinque parti, in parole semplici#
Pensa di istruire un nuovo collega al primo giorno. "Occupati di questa" ti dà un'ipotesi. Un post-it con il lavoro, il materiale, il formato che vuoi, un esempio e un "non fare" ti dà quello che intendevi.
Task è un verbo e un oggetto: "Riassumi l'email e valuta la sua urgenza". Sii letterale. "Aiutami con questa email" non è un task.
Contesto è il materiale su cui il modello lavora: l'email, una descrizione di prodotto, una policy. Il modello sa solo ciò che ha imparato durante l'addestramento più ciò che incolli. Racchiudi il testo incollato in delimitatori, come tag in stile XML tipo <email>…</email> o intestazioni markdown, così le tue istruzioni non possono essere confuse con il testo. La guida di OpenAI suggerisce entrambi.
Formato è che aspetto ha la risposta: "JSON con le chiavi summary, urgency, next_step" o "tre punti elenco, massimo 12 parole ciascuno". Conta soprattutto quando è il codice a leggere la risposta.
Esempio è un input con l'output che vuoi. La guida raccomanda esempi few-shot che coprono una gamma diversificata di input con gli output desiderati. Un esempio è un buon inizio; aggiungine un secondo quando i tuoi input differiscono molto.
Vincoli sono i "non fare": usa solo fatti dall'email, scrivi "unknown" quando manca qualcosa, niente rimborsi o sconti.
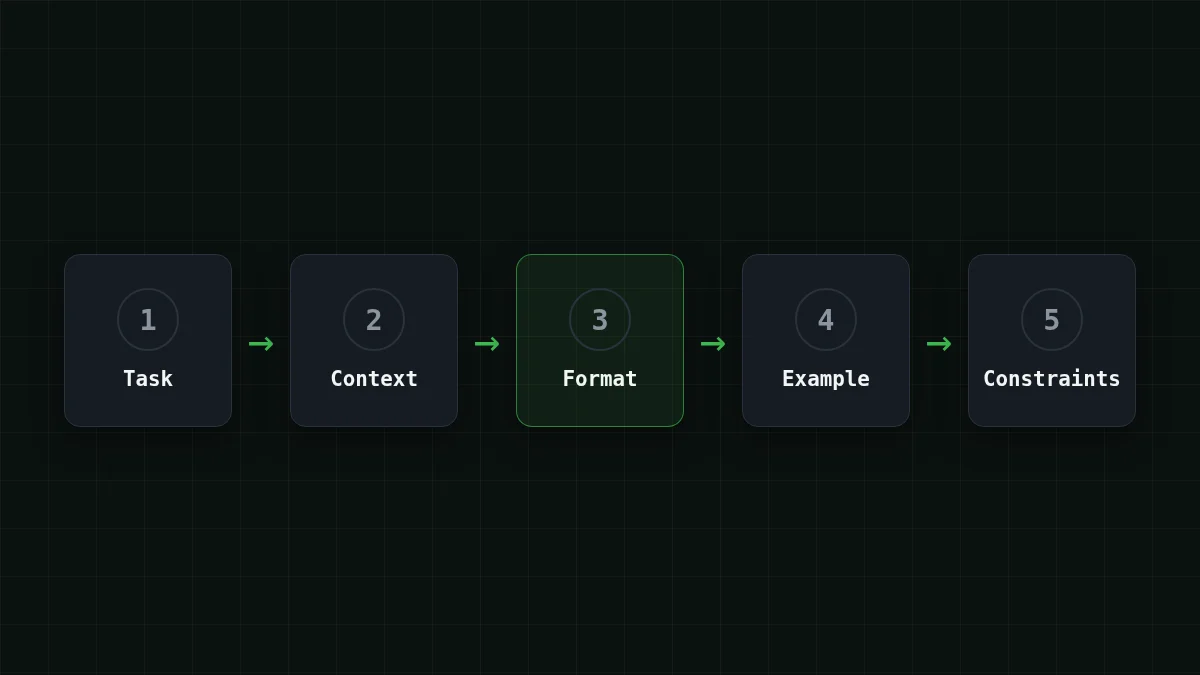
Anche l'ordine conta un po'. La stessa guida dice che un messaggio di sviluppatore o di sistema di solito va identità, istruzioni, esempi, contesto, e che il contesto sta vicino alla fine perché cambia tra le richieste. Le regole vanno nel messaggio di sistema; l'input va nel messaggio utente.
Abbina le coppie
Abbina ogni parte di un prompt alla domanda a cui risponde
Tocca un elemento a sinistra, poi il suo abbinamento
- TaskCosa dovrebbe fare il modello?
- ContestoSu quale materiale lavora?
- FormatoChe aspetto dovrebbe avere la risposta?
- EsempioChe aspetto ha una buona risposta?
- VincoliCosa non deve fare?
Prima e dopo: un'email di un cliente#
Ecco la riga singola accanto alla stessa richiesta con tutte e cinque le parti. L'email stessa è il contesto, e va nel messaggio utente, racchiusa in tag <email>.
Confronta
Una richiesta, due prompt
Prima
Summarize this email.Dopo
You summarize customer emails for a support team.

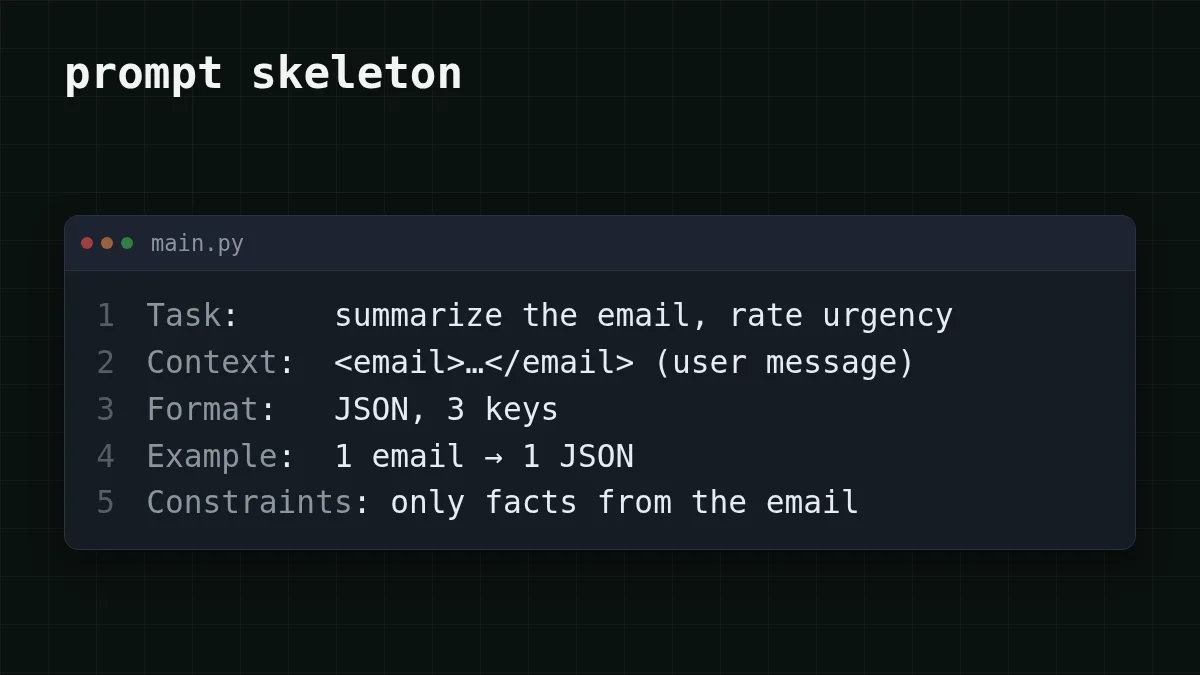
Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
Leggi il "dopo" dall'alto verso il basso e puoi indicare ogni parte: la riga di apertura e il task, la riga del formato, l'esempio, le regole. L'email manca dal testo di proposito. Cambia a ogni richiesta, quindi viaggia separatamente.
Inviarlo attraverso l'API#
Le istruzioni non cambiano mai, quindi vivono in una costante e vanno per prime. L'email cambia, quindi va per ultima. Questo è lo script completo, usando l'SDK Python di OpenAI puntato su CheapTokens. Il modello è DeepSeek-V4-Flash: contesto da 380K, fino a 32.768 token di output per risposta, un prezzo a qualsiasi ora. Prendi l'URL di base e l'id del modello dalla documentazione di CheapTokens; se non hai ancora una chiave, la tua prima richiesta API ti guida passo passo.
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

SYSTEM_PROMPT = """You summarize customer emails for a support team.

Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
"""

email = "Hello, I was charged twice for my subscription this month. Please fix it before Friday, my card is almost at its limit."

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": f"<email>\n{email}\n</email>"},
    ],
)

reply = response.choices[0].message.content
print(json.loads(reply))
print(response.usage.prompt_tokens, response.usage.completion_tokens)
Se la riga del formato ha fatto il suo lavoro, la risposta è un oggetto JSON con summary, urgency e next_step, e json.loads lo trasforma in un dizionario. Se solleva un errore, il modello ha avvolto il JSON in testo extra: stringi l'ultima regola o aggiungi un secondo esempio. L'ultima riga stampa quanti token sono entrati e usciti, che è il numero di cui parla la sezione successiva.
Quanto costano le parole in più#
Un token è un pezzo di parola. Paghi per token ciò che invii (input) e ciò che il modello scrive (output), e l'output è il lato più caro. Ne parliamo di più in token di input vs output.
Diciamo che gestisci un bot di supporto con 1.000 email al giorno, e l'email è di circa 300 token. La riga singola aggiunge all'incirca 10 token di istruzione, quindi entrano circa 310; supponiamo che ottenga un riassunto libero di circa 250 token. Il system prompt qui sopra è di circa 200 token, più all'incirca 10 per i tag <email>, quindi entrano circa 500; supponiamo che la riga del formato contenga la risposta in un JSON di circa 80 token. Su DeepSeek-V4-Flash sono $0.00003 per email per la riga singola e $0.000016 per il prompt strutturato. Il prompt si è allungato, ma la richiesta è diventata più economica, perché la parte lunga è l'input e la parte che hai accorciato è l'output. Esegui lo script e sostituisci queste ipotesi con i tuoi prompt_tokens e completion_.
Ecco il prompt strutturato a 1.000 email al giorno tra i modelli. In totale, contando input e output insieme, CheapTokens risulta più economico del prezzo di riferimento di OpenRouter su questo carico di lavoro; i prezzi attuali sono sulla pagina dei prezzi.
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000013 | $0.0132 | $0.0234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000016 | $0.0155 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000037 | $0.037 | $0.444 |
500 token di input e 80 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Verifica te stesso#
Una domanda sull'abitudine che ripaga di più quando uno script riutilizza un prompt. Una volta che la struttura funziona, le manopole successive sono il messaggio di sistema e la temperatura, trattati in System prompt e temperatura.
Verifica rapida
Il tuo script invia le stesse istruzioni con una nuova email ogni volta. Dove dovrebbe andare l'email?
Mostra risposta
Risposta: Alla fine, dopo le istruzioni e l'esempio
Le istruzioni restano le stesse tra le richieste e l'email cambia. La guida di OpenAI suggerisce di mettere il contesto che varia vicino alla fine del prompt.


