AI 入门指南
如何写出好的提示词:5 个部分和一个前后对比示例
把模糊的单行请求变成包含任务、上下文、格式、示例和规则的提示词,然后通过兼容 OpenAI 的 API 发送。
你的模型周一用三段话总结一封客户邮件,周二却用两个要点。同样的提示词,同样的模型。这就是单行请求的后果:它把每个决定都留给模型,而模型每次的决定都不一样。
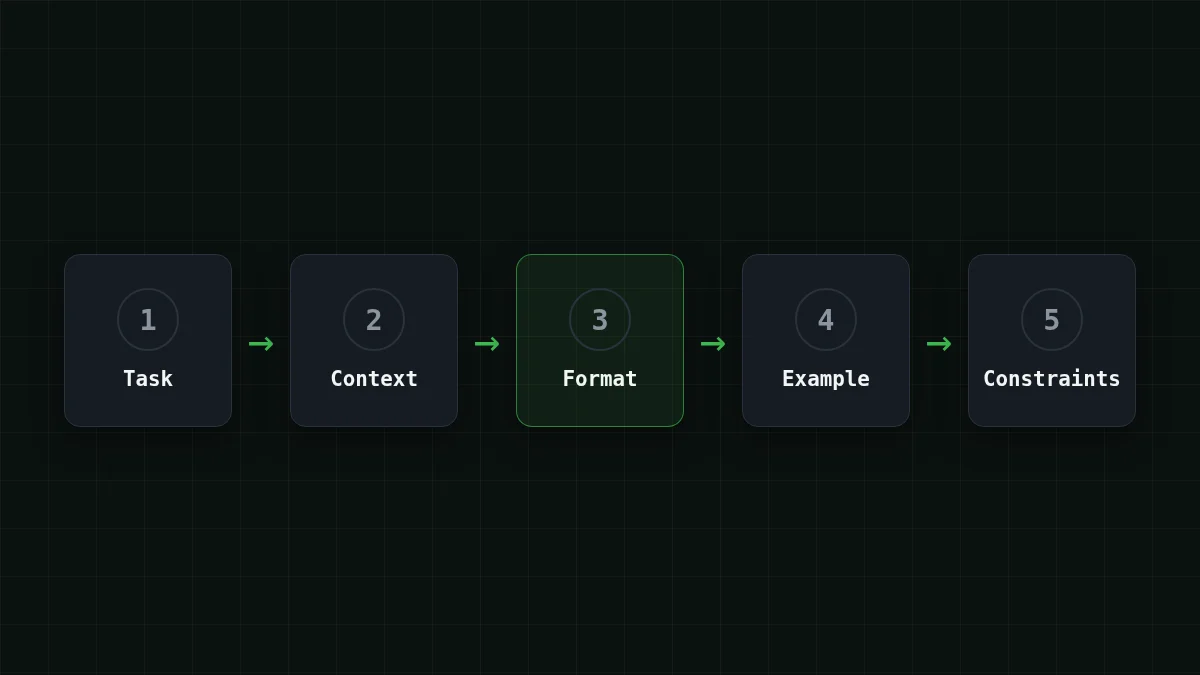
一个好的提示词回答五个问题:做什么(任务)、用什么做(上下文)、答案应该长什么样(格式)、好的答案长什么样(示例)以及要避免什么(约束)。下面,一个模糊的请求会变成一个结构化的请求,经过兼容 OpenAI 的 CheapTokens API,你会看到更长的提示词给账单增加了什么。
为什么“总结这封邮件”是一场赌博#
当你输入“总结这封邮件”时,你心里已经有了答案:一句话、有多紧急、下一步做什么。模型看不到这幅画面。所以它只能猜,而每个猜测都合理。合在一起,每次运行都会给你不同的答案,而读取答案的脚本没有任何稳定的东西可以解析。
OpenAI 的提示工程指南(2026 年 10 月 27 日阅读)把这一点说得很直白:提示工程就是编写有效的指令,当你明确告诉 GPT 模型如何完成任务时,它们表现更好。这个习惯不限于文本。2026 年 10 月 26 日,一个 Telegram 频道分享了一个 30 秒生成视频的提示词,它被拆成几个块:场景、视觉风格、对话、音频和排除项、技术规格。任务不同,做法相同。作者提前命名了每个决定,而不是留给模型。
自己试试试一试:从“总结这封邮件”中,模型必须猜出什么?显示答案
长度(一行还是一页)、受众(你还是客户)、答案的形式(散文、要点、JSON)、什么算重要,以及邮件没说时该怎么办。每一项都是提示词可以确定的东西。
五个部分,用大白话说#
想象你在新同事第一天上班时给他做简报。“处理一下这个”只会让你得到一个猜测。一张写着任务、材料、你想要的格式、一个示例和一条“不要”的便利贴,才能让你得到你想要的东西。
任务是一个动词加一个宾语:“总结这封邮件并评估其紧急程度。”要直白。“帮忙处理这封邮件”不是任务。
上下文是模型要处理的材料:邮件、产品描述、政策。模型只知道它在训练中学到的,加上你粘贴进去的内容。把粘贴的文本用分隔符包起来,比如 <email>…</email> 这样的 XML 风格标签或 markdown 标题,这样你的指令就不会和文本混在一起。OpenAI 的指南建议两者都用。
格式是答案长什么样:“包含 summary、urgency、next_step 键的 JSON”或“三个要点,每个最多 12 个词”。当代码读取回复时,这一点最重要。
示例是一个输入加上你想要的输出。指南建议使用少样本示例,覆盖多样化的输入及期望的输出。一个示例是不错的开始;当你的输入差异很大时,再加第二个。
约束是那些“不要”:只使用邮件中的事实,缺少信息时写“unknown”,不提供退款或折扣。
顺序也有一点关系。同一份指南说,开发者消息或系统消息通常按身份、指令、示例、上下文的顺序排列,而上下文应放在接近末尾的位置,因为它在不同请求之间会变化。规则放在系统消息里;输入放在用户消息里。
配对
将提示词的每个部分与它回答的问题配对
点击左侧项目,然后点击其配对项
- 任务模型应该做什么?
- 上下文它处理什么材料?
- 格式答案应该长什么样?
- 示例好的答案长什么样?
- 约束它不能做什么?
前后对比:一封客户邮件#
下面是单行请求与包含全部五个部分的同一请求的对比。邮件本身就是上下文,它放在用户消息里,用 <email> 标签包起来。
比较
一个请求,两个提示词
之前
Summarize this email.之后
You summarize customer emails for a support team.

Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
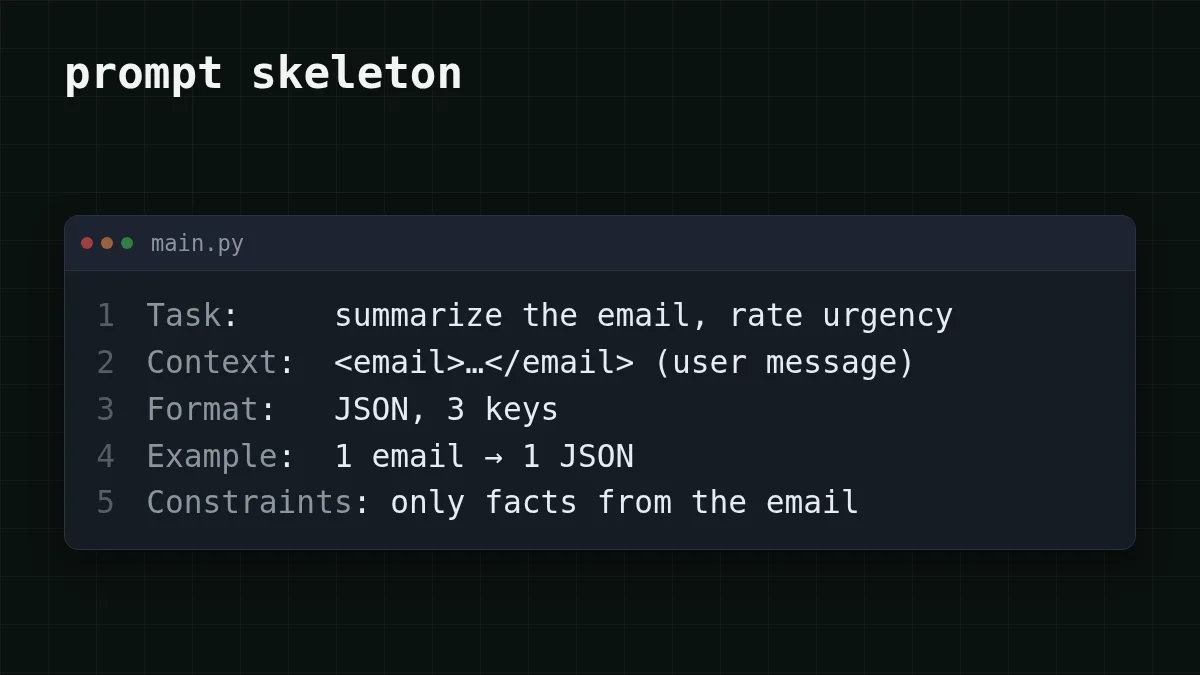
从上到下读“之后”的版本,你可以指出每个部分:开头一行和任务、格式行、示例、规则。邮件故意不在文本中。它随每个请求变化,所以单独传递。
通过 API 发送#
指令从不改变,所以它们放在一个常量里并放在最前面。邮件会变化,所以放在最后。这是完整的脚本,使用指向 CheapTokens 的 OpenAI Python SDK。模型是 DeepSeek-V4-Flash:380K 上下文,每次回答最多 32,768 个输出 token,任何时段一个价格。从 CheapTokens 文档获取基础 URL 和模型 id;如果你还没有密钥,你的第一个 API 请求会带你走一遍。
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

SYSTEM_PROMPT = """You summarize customer emails for a support team.

Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
"""

email = "Hello, I was charged twice for my subscription this month. Please fix it before Friday, my card is almost at its limit."

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": f"<email>\n{email}\n</email>"},
    ],
)

reply = response.choices[0].message.content
print(json.loads(reply))
print(response.usage.prompt_tokens, response.usage.completion_tokens)
如果格式行发挥了作用,回复就是一个 JSON 对象,包含 summary、urgency 和 next_step,而 json.loads 会把它变成字典。如果它抛出错误,说明模型把 JSON 包在了额外文本里:收紧最后一条规则或再加一个示例。最后一行打印输入和输出了多少 token,这正是下一节要讲的数字。
多出来的字要花多少钱#
一个 token 是单词的一部分。你按 token 为发送的内容(输入)和模型写出的内容(输出)付费,而输出是更贵的一侧。更多内容见输入与输出 token。
假设你运行一个支持机器人,每天处理 1,000 封邮件,每封邮件约 300 个 token。单行请求大约增加 10 个 token 的指令,所以大约 310 个 token 输入;我们假设它得到约 250 个 token 的自由形式摘要。上面的系统提示词约 200 个 token,加上 <email> 标签大约 10 个,所以大约 500 个 token 输入;我们假设格式行把答案限制在约 80 个 token 的 JSON。在 DeepSeek-V4-Flash 上,单行请求每封邮件是 $0.00003,结构化提示词是 $0.000016。提示词变长了,但请求变便宜了,因为长的部分是输入,而你缩短的部分是输出。运行脚本,把这些假设换成你自己的 prompt_tokens 和 completion_。
下面是结构化提示词在每天 1,000 封邮件、跨多个模型下的情况。总计,把输入和输出算在一起,在这个工作负载上 CheapTokens 比 OpenRouter 的参考价格更便宜;当前价格在定价页面上。
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000013 | $0.0132 | $0.0234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000016 | $0.0155 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000037 | $0.037 | $0.444 |
每次请求 500 个输入 token 和 80 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
自我检查#
一个关于这个习惯的问题,当脚本复用提示词时,它回报最大。一旦结构奏效,接下来的旋钮是系统消息和温度,见系统提示词与温度。
快速检查
你的脚本每次发送相同的指令和新的邮件。邮件应该放在哪里?
显示答案
答案: 放在末尾,在指令和示例之后
指令在请求之间保持不变,而邮件会变化。OpenAI 的指南建议把变化的上下文放在提示词接近末尾的位置。


