Como escrever um bom prompt: 5 partes e um exemplo de antes/depois
Transforme uma solicitação vaga de uma linha em um prompt com tarefa, contexto, formato, exemplo e regras, e envie-o por uma API compatível com OpenAI.
Nesta página
Seu modelo resume um e-mail de cliente em três parágrafos na segunda-feira e em dois tópicos na terça-feira. Mesmo prompt, mesmo modelo. É isso que uma solicitação de uma linha faz: deixa todas as decisões para o modelo, e o modelo decide de forma diferente a cada vez.
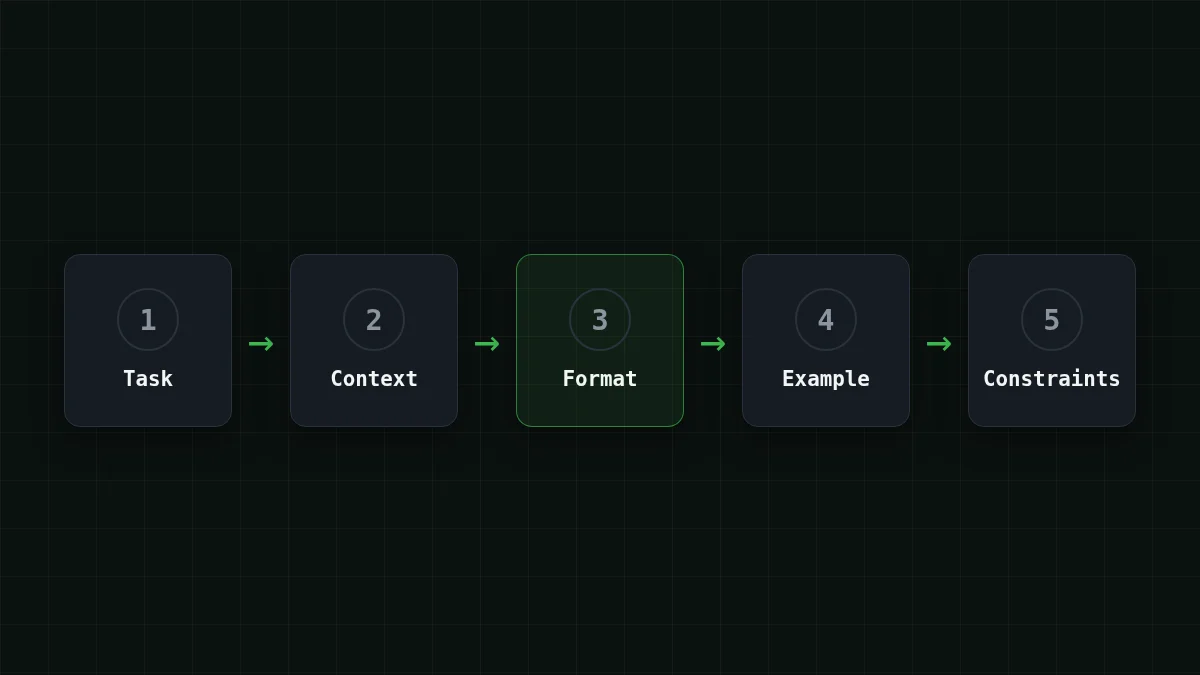
Um bom prompt responde a cinco perguntas: o que fazer (tarefa), com o que trabalhar (contexto), como a resposta deve ser (formato), como é uma boa resposta (exemplo) e o que evitar (restrições). Abaixo, uma solicitação vaga se torna estruturada, passa pela API CheapTokens compatível com OpenAI, e você vê o que o prompt mais longo acrescenta à conta.
Por que "Resuma este e-mail" é uma aposta#
Quando você digita "Resuma este e-mail", já tem uma resposta em mente: uma frase, qual a urgência, o que fazer em seguida. O modelo não consegue ver essa imagem. Então ele adivinha, e cada adivinhação é razoável. Juntas, elas dão uma resposta diferente a cada execução, e um script que lê a resposta não tem nada estável para analisar.
O guia de engenharia de prompt da OpenAI (lido em 27 de outubro de 2026) coloca a ideia de forma clara: engenharia de prompt é escrever instruções eficazes, e os modelos GPT se saem melhor quando você diz explicitamente como realizar uma tarefa. O hábito não se limita a texto. Em 26 de outubro de 2026, um canal do Telegram compartilhou um prompt para um vídeo gerado de 30 segundos que foi dividido em blocos: cena, estilo visual, diálogo, áudio e exclusões, especificações técnicas. Tarefa diferente, mesma jogada. O autor nomeou cada decisão de antemão em vez de deixá-la para o modelo.
Experimente você mesmoExperimente: o que um modelo teria que adivinhar a partir de "Resuma este e-mail"?Mostrar resposta
O comprimento (uma linha ou uma página), o público (você ou o cliente), a forma da resposta (prosa, tópicos, JSON), o que conta como importante e o que fazer quando o e-mail não diz. Cada um desses pontos é algo que um prompt pode resolver.
As cinco partes, em palavras simples#
Pense em orientar um novo colega no primeiro dia dele. "Lide com este" te dá um chute. Um post-it com a tarefa, o material, o formato que você quer, um exemplo e um "não faça" te dá o que você quis dizer.
Tarefa é um verbo e um objeto: "Resuma o e-mail e avalie sua urgência." Seja literal. "Ajude com este e-mail" não é uma tarefa.
Contexto é o material com que o modelo trabalha: o e-mail, uma descrição de produto, uma política. O modelo só sabe o que aprendeu no treinamento mais o que você cola. Envolva o texto colado em delimitadores, como tags no estilo XML como <email>…</email> ou cabeçalhos markdown, para que suas instruções não se misturem com o texto. O guia da OpenAI sugere ambos.
Formato é como a resposta se parece: "JSON com as chaves summary, urgency, next_step" ou "três tópicos, no máximo 12 palavras cada". Isso importa mais quando um código lê a resposta.
Exemplo é uma entrada com a saída que você quer. O guia recomenda exemplos few-shot que cobrem uma variedade diversa de entradas com as saídas desejadas. Um exemplo é um bom começo; adicione um segundo quando suas entradas diferem muito.
Restrições são os "nãos": use apenas fatos do e-mail, escreva "unknown" quando algo estiver faltando, sem reembolsos ou descontos.
A ordem também importa um pouco. O mesmo guia diz que uma mensagem de desenvolvedor ou de sistema geralmente segue identidade, instruções, exemplos, contexto, e que o contexto pertence perto do final porque muda entre requisições. Regras vão na mensagem de sistema; a entrada vai na mensagem de usuário.
Emparelhar os pares
Relacione cada parte de um prompt à pergunta que ela responde
Toque num item à esquerda, depois no seu par
- TarefaO que o modelo deve fazer?
- ContextoCom que material ele trabalha?
- FormatoComo a resposta deve ser?
- ExemploComo é uma boa resposta?
- RestriçõesO que ele não deve fazer?
Antes e depois: um e-mail de cliente#
Aqui está a solicitação de uma linha ao lado da mesma solicitação com todas as cinco partes. O e-mail em si é o contexto, e vai na mensagem de usuário, envolto em tags <email>.
Comparar
Uma solicitação, dois prompts
Antes
Summarize this email.Depois
You summarize customer emails for a support team.

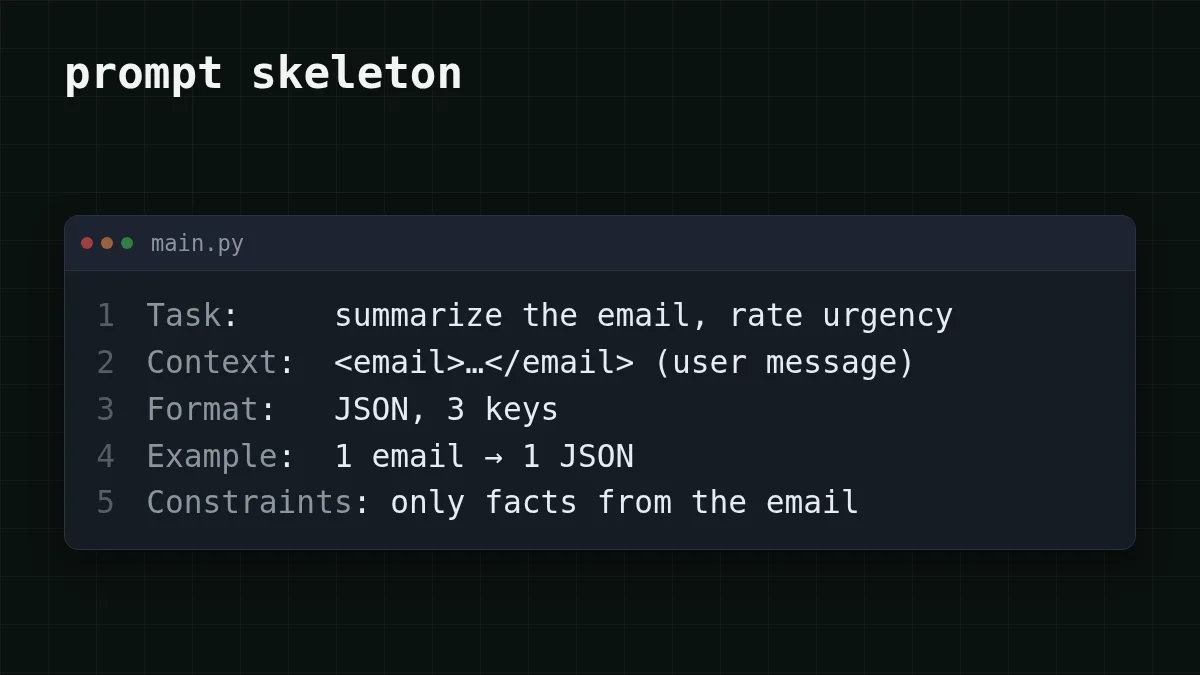
Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
Leia o "depois" de cima a baixo e você consegue apontar cada parte: a linha de abertura e a tarefa, a linha de formato, o exemplo, as regras. O e-mail está ausente do texto de propósito. Ele muda a cada requisição, então viaja separadamente.
Envie pela API#
As instruções nunca mudam, então ficam em uma constante e vão primeiro. O e-mail muda, então vai por último. Este é o script completo, usando o SDK Python da OpenAI apontado para a CheapTokens. O modelo é DeepSeek-V4-Flash: contexto de 380K, até 32.768 tokens de saída por resposta, um preço a qualquer hora. Pegue a URL base e o id do modelo na documentação da CheapTokens; se você ainda não tem uma chave, sua primeira requisição à API explica o processo.
import json
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

SYSTEM_PROMPT = """You summarize customer emails for a support team.

Task: Summarize the email in the <email> tags and rate how urgent it is.

Format: Reply with JSON only, using the keys "summary" (one sentence), "urgency" ("low", "medium" or "high") and "next_step" (one short sentence).

Example:
<email>Hi, order 1042 was due Monday and it's Thursday. Where is it?</email>
{"summary": "Order 1042 is three days late and the customer asks where it is.", "urgency": "medium", "next_step": "Check the carrier tracking for order 1042 and reply with the status."}

Rules:
- Use only what the email says. If something is missing, write "unknown".
- Don't offer refunds or discounts.
- Output nothing outside the JSON.
"""

email = "Hello, I was charged twice for my subscription this month. Please fix it before Friday, my card is almost at its limit."

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": f"<email>\n{email}\n</email>"},
    ],
)

reply = response.choices[0].message.content
print(json.loads(reply))
print(response.usage.prompt_tokens, response.usage.completion_tokens)
Se a linha de formato fez seu trabalho, a resposta é um objeto JSON com summary, urgency e next_step, e json.loads o transforma em um dicionário. Se gerar um erro, o modelo envolveu o JSON em texto extra: reforce a última regra ou adicione um segundo exemplo. A última linha imprime quantos tokens entraram e saíram, que é o número sobre o qual a próxima seção trata.
Quanto custam as palavras extras#
Um token é um pedaço de uma palavra. Você paga por token pelo que envia (entrada) e pelo que o modelo escreve (saída), e a saída é o lado mais caro. Mais sobre isso em tokens de entrada vs saída.
Digamos que você rode um bot de suporte com 1.000 e-mails por dia, e o e-mail tenha cerca de 300 tokens. A solicitação de uma linha adiciona aproximadamente 10 tokens de instrução, então cerca de 310 entram; assumimos que ela obtém um resumo de forma livre de cerca de 250 tokens. O prompt de sistema acima tem cerca de 200 tokens, mais aproximadamente 10 para as tags <email>, então cerca de 500 entram; assumimos que a linha de formato mantém a resposta em um JSON de cerca de 80 tokens. No DeepSeek-V4-Flash isso é $0.00003 por e-mail para a solicitação de uma linha e $0.000016 para o prompt estruturado. O prompt ficou mais longo, mas a requisição ficou mais barata, porque a parte longa é a entrada e a parte que você encurtou é a saída. Rode o script e troque essas suposições pelos seus próprios prompt_tokens e completion_.
Aqui está o prompt estruturado a 1.000 e-mails por dia entre os modelos. No total, com entrada e saída contadas juntas, a CheapTokens sai mais barata que o preço de referência do OpenRouter nesta carga de trabalho; os preços atuais estão na página de preços.
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000013 | $0.0132 | $0.0234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000016 | $0.0155 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000037 | $0.037 | $0.444 |
500 tokens de entrada e 80 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Teste você mesmo#
Uma pergunta sobre o hábito que mais compensa quando um script reutiliza um prompt. Depois que a estrutura funciona, os próximos ajustes são a mensagem de sistema e a temperatura, abordados em Prompt de sistema e temperatura.
Verificação rápida
Seu script envia as mesmas instruções com um novo e-mail a cada vez. Onde o e-mail deve ir?
Mostrar resposta
Resposta: No final, depois das instruções e do exemplo
As instruções permanecem as mesmas entre requisições e o e-mail muda. O guia da OpenAI sugere colocar o contexto que varia perto do final do prompt.


