AI для початківцівПосібник
Позначайте кожен документ у промпті, щоб модель їх не сплутала
Як дати кожному вставленому тексту назву й роль, з промптом до і після та робочим запитом chat completion мовами Python і curl.
На цій сторінці
Ви вставили два тексти в одне повідомлення й попросили модель порівняти їх. Якщо ви не сказали, який з них який, їй доведеться вгадувати. Виправлення невелике: дайте кожному тексту назву й завдання та обгорніть кожен у власний тег. Посібник Anthropic із промптингу (жива сторінка, перевірена 31 жовтня 2026 року) радить позначати кожен тип вмісту тегом, щоб модель не сплутала, що є інструкцією, що — контекстом, а що — вхідними даними. Нижче — промпт до і після та робочий запит chat completion, який можна надіслати до CheapTokens API.
Що йде не так, коли ви просто вставляєте текст#
Візьмімо найпростіший випадок. Постачальник надсилає новий опис товару, і ви хочете дізнатися, що змінилося порівняно з описом на вашій сторінці магазину. Ви вставляєте обидва під запитанням «Що змінилося?» і натискаєте надіслати. Для вас порядок очевидний. Для моделі це два блоки тексту без нічого між ними, а в запитанні не сказано, який із них старий. Вона може вгадати правильно. А може й назвати новий текст старим і видати вам список змін у зворотному напрямку — цілком упевненим голосом.
Та сама пастка чатує в повсякденних задачах:
- дві версії договору, і ви питаєте, що змінила інша сторона;
- три нотатки із зустрічей, і ви питаєте, які рішення суперечать одне одному;
- зразок стилю плюс чернетка: який наслідувати, який переписувати?
- лог помилок, вставлений разом із кодом, і запитання «виправ це».
У кожному з них моделі потрібні дві речі для кожного тексту: назва (що це і звідки воно) та роль (що з ним зробити).
Дайте кожному тексту назву й завдання#
Три невеликі кроки:
- Помістіть кожен текст у власний тег. Посібник Anthropic пропонує обгортку
<documents>з одним<document index="1">на текст, а всередині —<source>для назви та<document_для самого тексту.content> - Скажіть, що є що, в інструкції, поза тегами: «Документ 1 — це СТАРИЙ текст із нашого магазину. Документ 2 — це НОВИЙ текст від постачальника».
- Поставте запитання тими самими словами. «Перелічи кожен факт, що змінився, у форматі старе -> нове» тепер має старе й нове, на які можна вказати.
Ось приклад із пляшкою до і після:
Порівняйте
Той самий запит, до і після
До
What changed?

Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.

Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
Після
Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
</document_content>
</document>
</documents>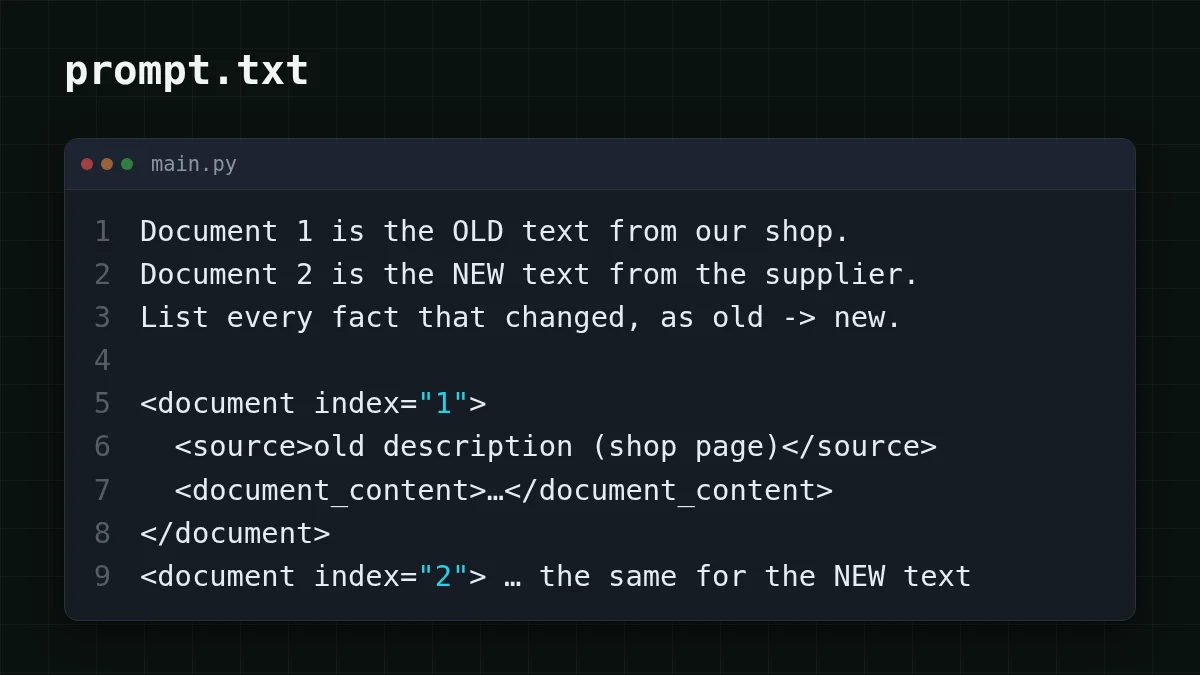
Мітки коштують кілька токенів і прибирають вгадування. Anthropic написав цю пораду для своїх моделей Claude, але мітки — це звичайний текст, тож ніщо не заважає надіслати ту саму розмітку іншій чат-моделі.
Надішліть це як справжній запит#
Ось промпт «після» у вигляді виклику API. Адреса — https:/, API сумісний з OpenAI, а модель — deepseek-. Беріть ідентифікатори моделей із документації CheapTokens: назви різняться між провайдерами. DeepSeek-V4-Flash має контекстне вікно 380K і до 32 768 вихідних токенів на відповідь, що залишає місце для купи довгих текстів. Ключ береться зі змінної середовища, ніколи з коду.
Той самий запит у двох інструментах
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

old = "Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe."
new = "Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only."

prompt = f"""Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
{old}
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
{new}
</document_content>
</document>
</documents>"""

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": prompt}],
    max_tokens=300,
)
print(response.choices[0].message.content)
print(response.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 300,
    "messages": [{
      "role": "user",
      "content": "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.\n\n<documents>\n<document index=\"1\">\n<source>old description (current shop page)</source>\n<document_content>\nSteel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.\n</document_content>\n</document>\n<document index=\"2\">\n<source>new description (from the supplier)</source>\n<document_content>\nSteel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.\n</document_content>\n</document>\n</documents>"
    }]
  }'
Відповідь — звичайний текст у choices[0]., а usage поруч рахує токени. Гарна відповідь перелічує три зміни: 500 мл -> 750 мл, 12 годин -> 24 години, можна мити в посудомийній машині -> лише ручне миття. Якщо стрілки йдуть у зворотний бік, модель втратила орієнтацію в мітках. Перевірте, чи інструкція називає документи так само, як теги.
Скільки коштують мітки#
Теги — це текст, а текст тарифікується. Скажімо, тімлід подає три нотатки із зустрічей приблизно по 2 000 токенів кожна й питає, які рішення суперечать одне одному. Три нотатки: 3 × 2 000 = 6 000 токенів. Додайте близько 150 токенів на інструкцію та теги (припущення), і запит несе 6 150 токенів на вході з відповіддю на 300 токенів на виході. На DeepSeek-V4-Flash цей один запит коштує $0.00012, а самі теги — похибка округлення порівняно з нотатками. Ось той самий запит, надісланий 1 000 разів, разом з OpenRouter:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 1 000 запитів | OpenRouter, 1 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.135 | $0.231 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00012 | $0.122 | $0.473 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00035 | $0.353 | $4.23 |
6 150 вхідних і 300 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Усі 6 150 токенів вміщуються у вікно 380K із запасом (що таке контекстне вікно). Якщо рахувати загалом, вхід і вихід разом, запит виходить дешевшим, ніж в OpenRouter. Вхід і вихід тарифікуються за різними ставками, і вхідні vs вихідні токени пояснює чому. Актуальні цифри для кожної моделі — на сторінці цін.
Звички для більших обсягів тексту#
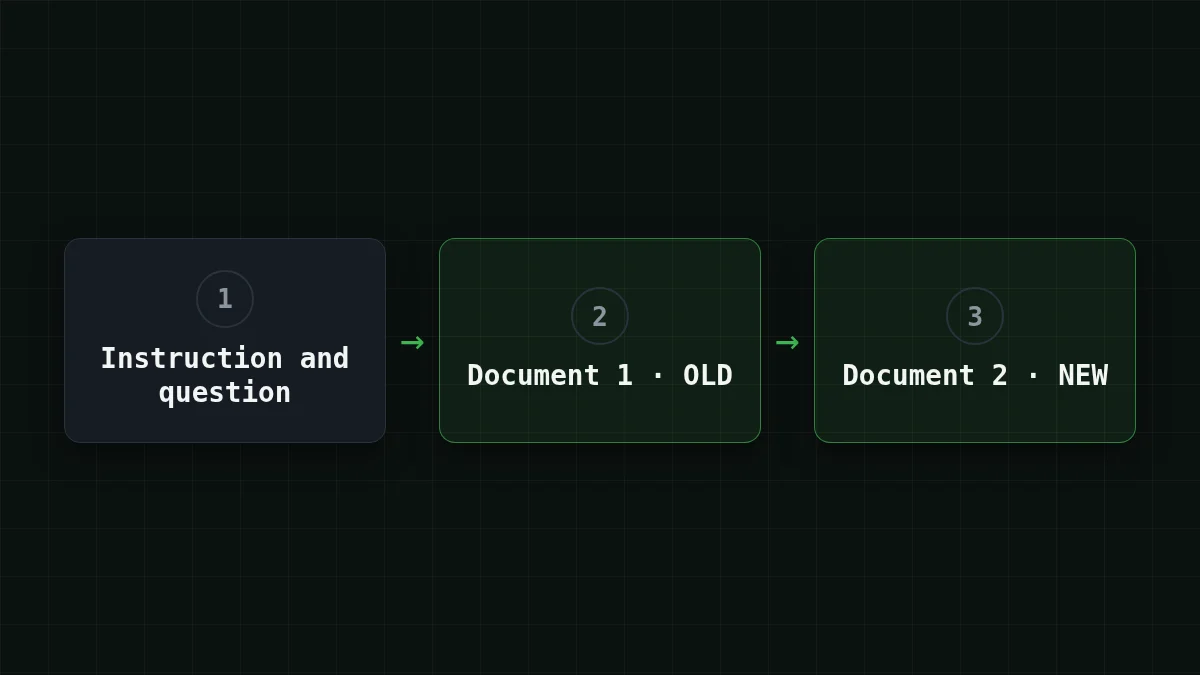
Коли текстів більше двох, самих лише номерів недостатньо: кожному потрібна власна назва. На зображенні нижче показано розмітку з прикладу: спершу інструкція із запитанням, потім кожен документ у власному тезі.
- Називайте за змістом, а не лише за номером.
<source>contract v2, sent by the client</краще заsource> document 2, коли відповідь цитує його вам. - Тримайте інструкцію поза тегами, щоб рядок усередині вставленого тексту не сприйняли як наказ.
- Один текст — один тег. Довгий файл — це все ще один тег; два файли — два.
- Повторіть назви в запитанні: «які рішення в monday-notes суперечать wednesday-notes?»
- Давайте ролі й прикладам. «Документ 1 — це зразок стилю: скопіюй його тон, а не факти. Документ 2 — це чернетка для переписування».
Спробуйте саміСпробуйте: у вас є лог помилок і код, що його спричинив, в одному промпті. Що ви додасте до кожного?Показати відповідь
Назву й завдання. Для логу: <source>error log from the last run</ плюс «це симптом, не редагуй його». Для коду: <source>app. плюс «це те, що треба виправити». Потім попросіть виправлення за цими назвами.
Про основи решти промпту (мета, контекст, формат) дивіться як написати хороший промпт.


