प्रॉम्प्ट में हर दस्तावेज़ को लेबल करें ताकि मॉडल उन्हें मिला न दे
हर पेस्ट किए गए टेक्स्ट को नाम और भूमिका कैसे दें, पहले/बाद के प्रॉम्प्ट और Python और curl में एक काम करने वाले चैट कम्प्लीशन अनुरोध के साथ।
इस पृष्ठ पर
आपने एक ही संदेश में दो टेक्स्ट पेस्ट किए और मॉडल से उनकी तुलना करने को कहा। जब तक आपने यह नहीं बताया कि कौन सा कौन है, उसे अनुमान लगाना पड़ेगा। समाधान छोटा है: हर टेक्स्ट को एक नाम और एक काम दें, और हर एक को अपने टैग में लपेटें। Anthropic की प्रॉम्प्टिंग गाइड (एक जीवंत पेज, 31 अक्टूबर 2026 को जाँचा गया) हर प्रकार की सामग्री को टैग करने की सलाह देती है ताकि मॉडल यह न समझे कि क्या निर्देश है, क्या पृष्ठभूमि है और क्या इनपुट है। नीचे एक पहले/बाद का प्रॉम्प्ट और एक काम करने वाला चैट कम्प्लीशन अनुरोध है जिसे आप CheapTokens API पर भेज सकते हैं।
जब आप सिर्फ पेस्ट करते हैं तो क्या गलत होता है#
सबसे सीधा मामला लें। एक आपूर्तिकर्ता नया उत्पाद विवरण भेजता है, और आप जानना चाहते हैं कि आपके शॉप पेज पर मौजूद विवरण की तुलना में क्या बदला। आप दोनों को "क्या बदला?" के नीचे पेस्ट करते हैं और भेज दबाते हैं। आपके लिए क्रम स्पष्ट है। मॉडल के लिए यह दो टेक्स्ट ब्लॉक हैं जिनके बीच कुछ नहीं है, और प्रश्न कभी नहीं कहता कि कौन सा पुराना है। यह सही अनुमान लगा सकता है। यह नए टेक्स्ट को पुराना कह सकता है और आपको उल्टी दिशा में चलने वाले परिवर्तनों की सूची पूरी आत्मविश्वास भरी आवाज़ में दे सकता है।
यही जाल रोज़मर्रा के कामों में छिपा रहता है:
- एक अनुबंध के दो संस्करण, और आप पूछते हैं कि दूसरे पक्ष ने क्या बदला;
- तीन मीटिंग नोट्स, और आप पूछते हैं कि कौन से निर्णय एक-दूसरे का खंडन करते हैं;
- एक स्टाइल नमूना और एक ड्राफ्ट: किसकी नकल करनी है, किसे फिर से लिखना है?
- एक एरर लॉग को कोड के साथ पेस्ट किया गया, और प्रश्न है "इसे ठीक करें"।
इनमें से प्रत्येक में मॉडल को प्रति टेक्स्ट दो चीज़ें चाहिए: एक नाम (यह क्या है और कहाँ से आया) और एक भूमिका (आप इसके साथ क्या करना चाहते हैं)।
हर टेक्स्ट को एक नाम और एक काम दें#
तीन छोटे कदम:
- हर टेक्स्ट को अपने टैग में रखें। Anthropic की गाइड एक
<documents>रैपर का सुझाव देती है जिसमें प्रति टेक्स्ट एक<document index="1">हो, और उसके अंदर नाम के लिए<source>और टेक्स्ट के लिए<document_हो।content> - निर्देश में, टैग के बाहर, बताएं कि प्रत्येक क्या है: "दस्तावेज़ 1 हमारी शॉप से पुराना टेक्स्ट है। दस्तावेज़ 2 आपूर्तिकर्ता से नया टेक्स्ट है।"
- प्रश्न उन्हीं शब्दों में पूछें। "हर तथ्य को सूचीबद्ध करें जो बदला, पुराना -> नया के रूप में" अब इंगित करने के लिए एक पुराना और एक नया है।
यहाँ बोतल का उदाहरण पहले और बाद में है:
तुलना करें
वही अनुरोध, पहले और बाद में
पहले
What changed?

Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.

Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
बाद में
Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
</document_content>
</document>
</documents>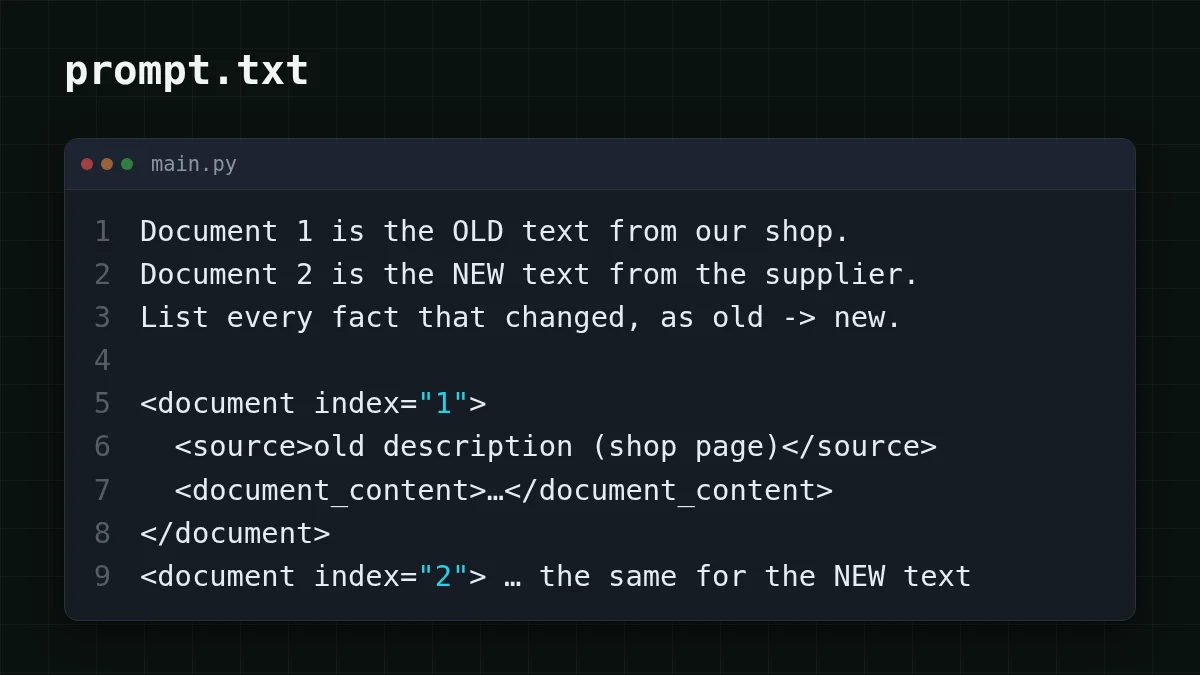
लेबल कुछ टोकन खर्च करते हैं और अनुमान को हटा देते हैं। Anthropic ने यह सलाह अपने Claude मॉडल के लिए लिखी, लेकिन लेबल सादा टेक्स्ट हैं, इसलिए कोई भी आपको वही लेआउट किसी अन्य चैट मॉडल को भेजने से नहीं रोकता।
इसे एक वास्तविक अनुरोध के रूप में भेजें#
यहाँ "बाद" वाला प्रॉम्प्ट एक API कॉल के रूप में है। पता https:/ है, API OpenAI-संगत है, और मॉडल deepseek- है। मॉडल आईडी CheapTokens डॉक्स से लें: नाम प्रदाताओं के बीच भिन्न होते हैं। DeepSeek-V4-Flash में 380K कॉन्टेक्स्ट विंडो और प्रति उत्तर अधिकतम 32,768 आउटपुट टोकन हैं, जो लंबे टेक्स्ट के ढेर के लिए जगह छोड़ता है। कुंजी एक एनवायरनमेंट वेरिएबल से आती है, कभी कोड से नहीं।
दो टूल में वही अनुरोध
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

old = "Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe."
new = "Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only."

prompt = f"""Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
{old}
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
{new}
</document_content>
</document>
</documents>"""

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": prompt}],
    max_tokens=300,
)
print(response.choices[0].message.content)
print(response.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 300,
    "messages": [{
      "role": "user",
      "content": "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.\n\n<documents>\n<document index=\"1\">\n<source>old description (current shop page)</source>\n<document_content>\nSteel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.\n</document_content>\n</document>\n<document index=\"2\">\n<source>new description (from the supplier)</source>\n<document_content>\nSteel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.\n</document_content>\n</document>\n</documents>"
    }]
  }'
उत्तर choices[0]. में सादा टेक्स्ट है, और उसके बगल में usage टोकन गिनता है। एक अच्छा उत्तर तीन परिवर्तन सूचीबद्ध करता है: 500 ml -> 750 ml, 12 घंटे -> 24 घंटे, डिशवॉशर सुरक्षित -> केवल हाथ से धोएं। यदि तीर दूसरी दिशा में चलते हैं, तो मॉडल ने लेबल का ट्रैक खो दिया। जाँचें कि निर्देश दस्तावेज़ों को वही नाम देता है जो टैग देते हैं।
लेबल की लागत#
टैग टेक्स्ट हैं, और टेक्स्ट का बिल आता है। मान लें एक टीम लीड लगभग 2,000 टोकन प्रत्येक के तीन मीटिंग नोट्स डालता है और पूछता है कि कौन से निर्णय टकराते हैं। तीन नोट्स: 3 × 2,000 = 6,000 टोकन। निर्देश और टैग के लिए लगभग 150 टोकन जोड़ें (एक अनुमान) और अनुरोध में 6,150 टोकन इन, और 300-टोकन उत्तर आउट होता है। DeepSeek-V4-Flash पर उस एक अनुरोध की लागत $0.00012 है, और टैग स्वयं नोट्स के मुकाबले एक राउंडिंग एरर हैं। यहाँ वही अनुरोध 1,000 बार भेजा गया है, साथ में OpenRouter भी:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.135 | $0.231 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00012 | $0.122 | $0.473 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00035 | $0.353 | $4.23 |
प्रति अनुरोध 6,150 इनपुट और 300 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
सभी 6,150 टोकन 380K विंडो में बहुत जगह के साथ फिट हो जाते हैं (कॉन्टेक्स्ट विंडो क्या है)। कुल मिलाकर, इनपुट और आउटपुट एक साथ गिने जाने पर, अनुरोध OpenRouter से सस्ता निकलता है। इनपुट और आउटपुट अलग-अलग दरों पर बिल किए जाते हैं, और इनपुट बनाम आउटपुट टोकन बताता है क्यों। हर मॉडल के वर्तमान नंबर प्राइसिंग पेज पर हैं।
टेक्स्ट के बड़े ढेर के लिए आदतें#
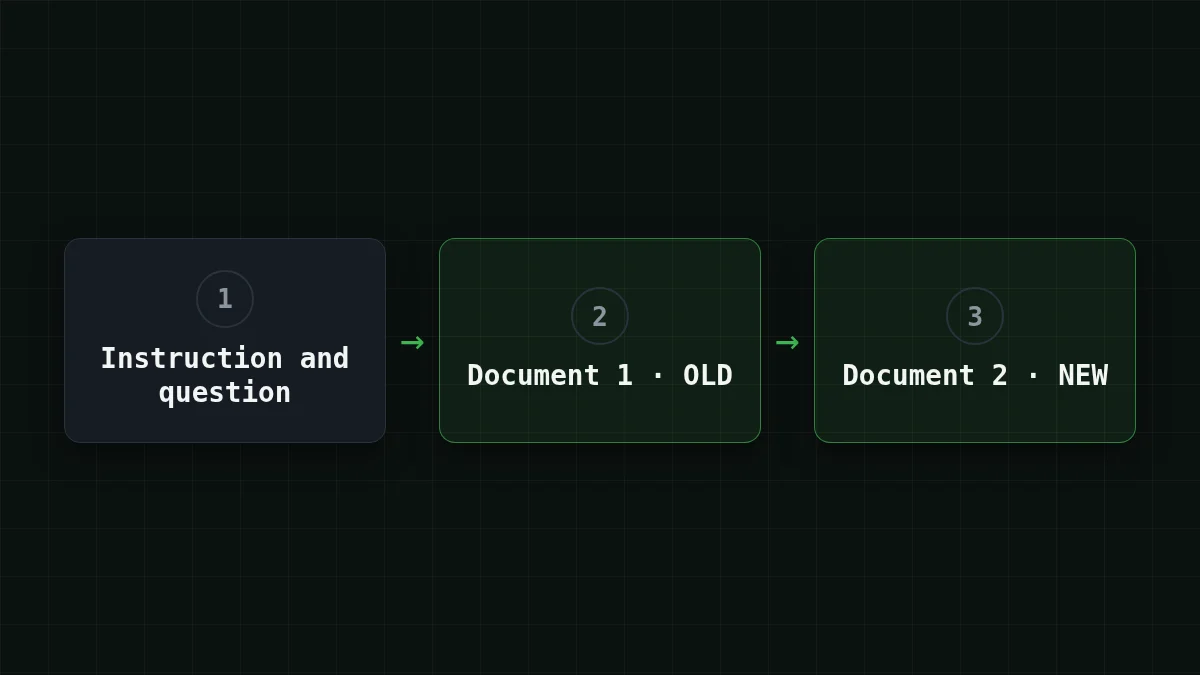
एक बार जब दो से अधिक टेक्स्ट हो जाएं, तो केवल संख्याएँ पर्याप्त नहीं हैं: प्रत्येक को अपना नाम चाहिए। नीचे दी गई तस्वीर उदाहरण से लेआउट दिखाती है: पहले प्रश्न के साथ निर्देश, फिर प्रत्येक दस्तावेज़ अपने टैग में।
- केवल संख्या से नहीं, सामग्री से नाम दें। जब उत्तर आपको वापस उद्धृत करता है तो
<source>contract v2, sent by the client</source> document 2से बेहतर है। - अपना निर्देश टैग के बाहर रखें, ताकि पेस्ट किए गए टेक्स्ट के अंदर की कोई पंक्ति आदेश न समझी जाए।
- एक टेक्स्ट, एक टैग। एक लंबी फ़ाइल अभी भी एक टैग है; दो फ़ाइलें दो हैं।
- प्रश्न में नाम दोहराएं: "monday-notes में कौन से निर्णय wednesday-notes का खंडन करते हैं?"
- उदाहरणों को भी भूमिकाएँ दें। "दस्तावेज़ 1 एक स्टाइल नमूना है: इसका लहजा कॉपी करें, इसके तथ्य नहीं। दस्तावेज़ 2 वह ड्राफ्ट है जिसे फिर से लिखना है।"
स्वयं आज़माएँइसे आज़माएं: आपके पास एक प्रॉम्प्ट में एक एरर लॉग और वह कोड है जिसने इसे उत्पन्न किया। आप प्रत्येक में क्या जोड़ते हैं?उत्तर दिखाएँ
एक नाम और एक काम। लॉग के लिए: <source>error log from the last run</ और "यह लक्षण है, इसे संपादित न करें"। कोड के लिए: <source>app. और "यह वह है जिसे ठीक करना है"। फिर उन नामों से समाधान मांगें।
प्रॉम्प्ट के बाकी हिस्से (लक्ष्य, संदर्भ, प्रारूप) की मूल बातों के लिए, अच्छा प्रॉम्प्ट कैसे लिखें देखें।


