AI 入门指南
为提示词中的每份文档打上标签,模型就不会把它们弄混
如何给每段粘贴的文本一个名称和角色,附修改前后的提示词,以及 Python 和 curl 中可用的聊天补全请求。
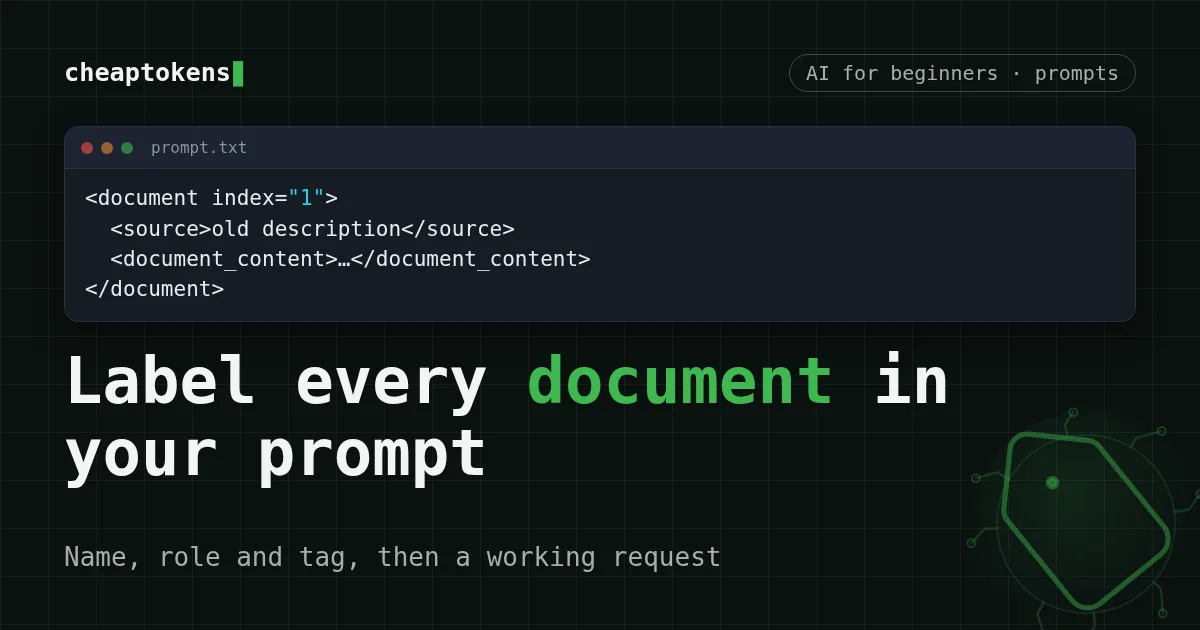
你把两段文本粘贴到一条消息里,让模型去比较它们。除非你说明哪段是哪段,否则它只能靠猜。解决办法很简单:给每段文本一个名称和一个用途,并把每段分别包在自己的标签里。Anthropic 的提示指南(一个持续更新的页面,查阅于 2026 年 10 月 31 日)建议为每种内容打上标签,这样模型就不会误读哪部分是指令、哪部分是背景、哪部分是输入。下面是一个修改前后的提示词,以及一个可直接发送到 CheapTokens API 的可用聊天补全请求。
直接粘贴时会出现什么问题#
举个最简单的例子。供应商发来一份新的产品描述,你想知道它和店铺页面上那份相比改了什么。你把两段都粘贴在“改了什么?”下面,然后按下发送。对你来说顺序显而易见。对模型来说,这只是两段之间没有任何区分的文本,而问题里从未说明哪段是旧的。它可能猜对,也可能把新文本当成旧文本,然后用十足自信的语气给你一份方向完全反过来的变更清单。
同样的陷阱也藏在日常工作中:
- 合同的两个版本,你问对方改了什么;
- 三份会议记录,你问哪些决定互相矛盾;
- 一份风格样本加一份草稿:该模仿哪份,该改写哪份?
- 错误日志和代码粘贴在一起,问题是“修好它”。
在每一种情况下,模型对每段文本都需要两样东西:一个名称(它是什么、来自哪里)和一个角色(你想用它做什么)。
给每段文本一个名称和一个用途#
三个小动作:
- 把每段文本放进自己的标签。Anthropic 的指南建议用一个
<documents>包裹,每段文本对应一个<document index="1">,里面用<source>写名称,用<document_放文本本身。content> - 在标签外的指令中说明每段是什么:“文档 1 是我们店铺的旧文本。文档 2 是供应商发来的新文本。”
- 用同样的措辞提问。“列出所有发生变化的事实,格式为旧 -> 新”现在就有了可指向的旧和新。
下面是瓶子示例的修改前后:
比较
同一个请求,修改前后
修改前
What changed?

Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.

Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
修改后
Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
</document_content>
</document>
</documents>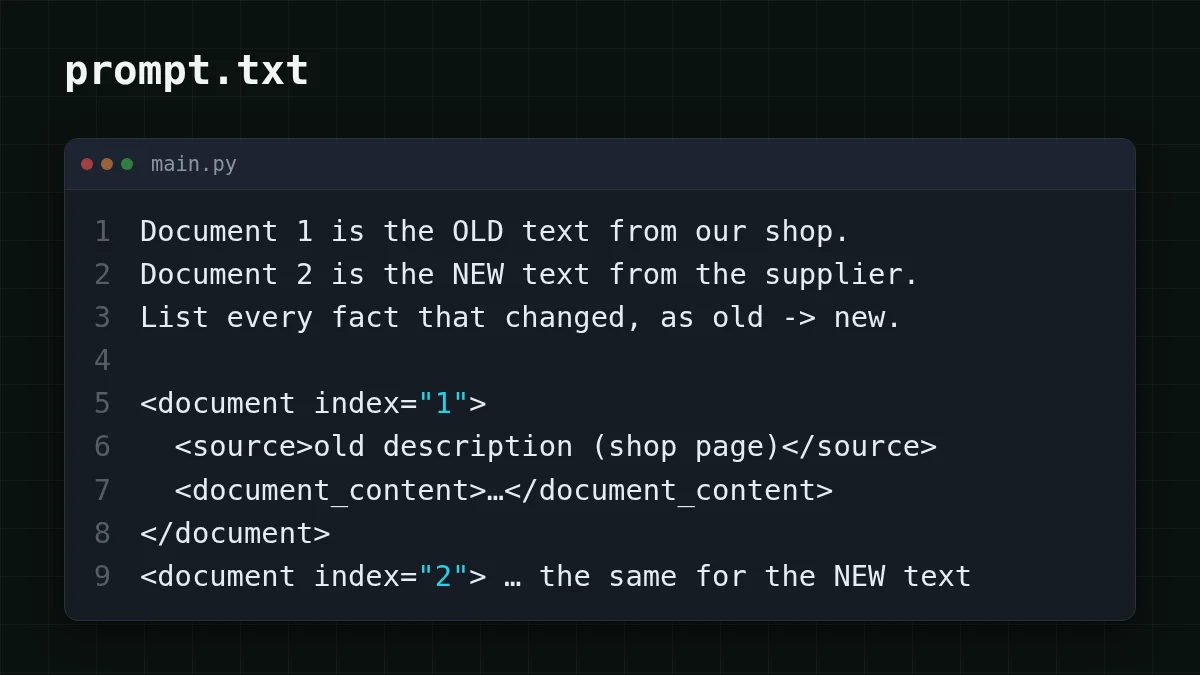
这些标签只花几个 token,却能消除猜测。Anthropic 是写给自家 Claude 模型的建议,但标签只是纯文本,所以你完全可以把同样的布局发给其他聊天模型。
作为真实请求发送#
下面是“修改后”提示词对应的 API 调用。地址是 https:/,API 兼容 OpenAI,模型是 deepseek-。模型 id 请从 CheapTokens 文档中获取:不同提供商的名称不同。DeepSeek-V4-Flash 有 380K 上下文窗口,每次回答最多 32,768 个输出 token,足以容纳大量长文本。密钥来自环境变量,绝不写在代码里。
同一个请求在两种工具中的写法
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

old = "Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe."
new = "Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only."

prompt = f"""Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
{old}
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
{new}
</document_content>
</document>
</documents>"""

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": prompt}],
    max_tokens=300,
)
print(response.choices[0].message.content)
print(response.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 300,
    "messages": [{
      "role": "user",
      "content": "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.\n\n<documents>\n<document index=\"1\">\n<source>old description (current shop page)</source>\n<document_content>\nSteel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.\n</document_content>\n</document>\n<document index=\"2\">\n<source>new description (from the supplier)</source>\n<document_content>\nSteel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.\n</document_content>\n</document>\n</documents>"
    }]
  }'
回复是 choices[0]. 中的纯文本,旁边的 usage 会统计 token 数。好的回答会列出三处变化:500 ml -> 750 ml、12 小时 -> 24 小时、可洗碗机清洗 -> 仅可手洗。如果箭头方向反了,说明模型弄丢了标签。检查指令中对文档的称呼是否与标签一致。
标签的成本#
标签也是文本,文本就要计费。假设一位团队负责人输入三份会议记录,每份约 2,000 个 token,并询问哪些决定互相冲突。三份记录:3 × 2,000 = 6,000 个 token。再加上约 150 个 token 用于指令和标签(这是一个假设),请求输入共 6,150 个 token,输出回答 300 个 token。在 DeepSeek-V4-Flash 上,这一次请求花费 $0.00012,而标签本身相对于会议记录只是零头。下面是同一请求发送 1,000 次的情况,并附上 OpenRouter 的对比:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.135 | $0.231 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00012 | $0.122 | $0.473 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00035 | $0.353 | $4.23 |
每次请求 6,150 个输入 token 和 300 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
全部 6,150 个 token 都能轻松放进 380K 窗口(什么是上下文窗口)。按输入和输出合计计算,该请求比 OpenRouter 更便宜。输入和输出的计费费率不同,输入 token 与输出 token 解释了原因。每个模型的最新数字都在定价页面上。
处理更大批量文本的习惯#
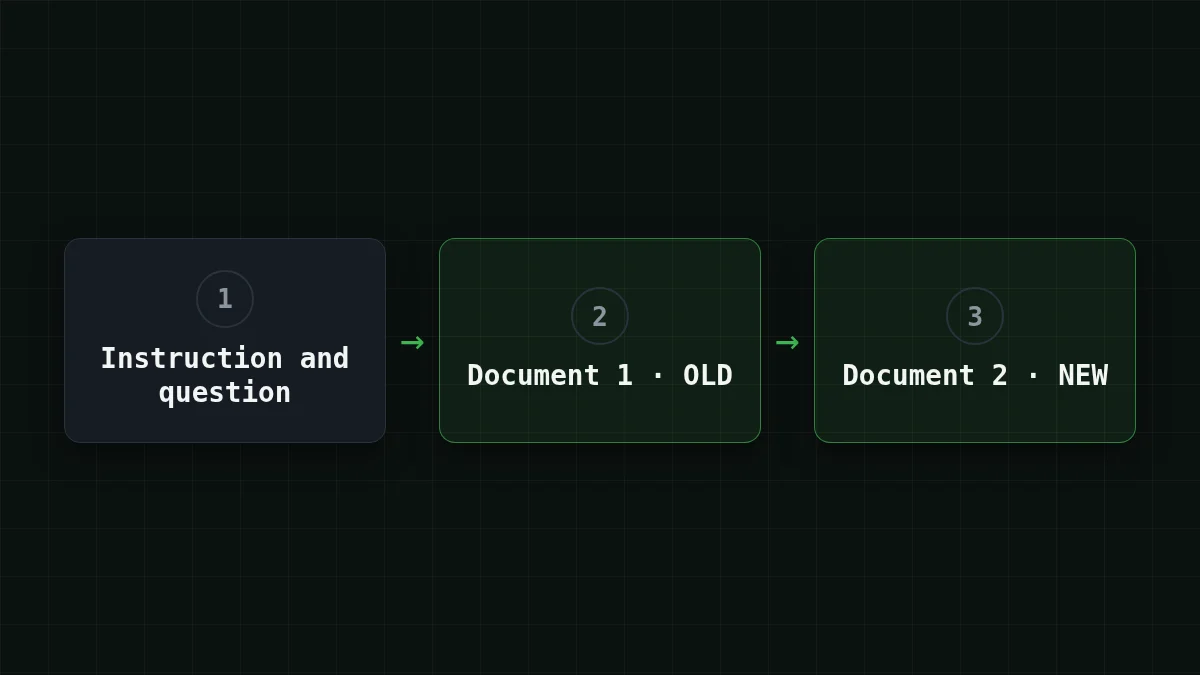
一旦文本超过两段,光靠编号就不够了:每段都需要自己的名称。下图展示了示例中的布局:先是带问题的指令,然后每份文档在自己的标签中。
- 按内容命名,而不只是按编号。当回答把名称引用回给你时,
<source>contract v2, sent by the client</比source> document 2更好。 - 把指令放在标签外,这样粘贴文本中的某一行就不会被当成命令。
- 一段文本一个标签。一个长文件仍是一个标签;两个文件就是两个。
- 在问题中复用这些名称:“monday-notes 中的哪些决定与 wednesday-notes 矛盾?”
- 也给示例分配角色。“文档 1 是风格样本:模仿它的语气,而不是它的事实。文档 2 是要改写的草稿。”
自己试试试一试:你在一个提示词里同时有错误日志和产生它的代码。你要给每样加什么?显示答案
一个名称和一个用途。对日志:<source>error log from the last run</ 加上“这是症状,不要修改它”。对代码:<source>app. 加上“这是要修复的内容”。然后用这些名称来请求修复。
关于提示词其余部分的基础知识(目标、上下文、格式),请参阅如何写出好的提示词。


