AI dla początkującychPrzewodnik
Oznacz każdy dokument w promptcie, żeby model ich nie pomylił
Jak nadać każdemu wklejonemu tekstowi nazwę i rolę, z promptem przed i po oraz działającym żądaniem chat completion w Pythonie i curl.
Na tej stronie
Wkleiłeś dwa teksty do jednej wiadomości i poprosiłeś model o ich porównanie. Jeśli nie powiedziałeś, który jest który, model musi zgadywać. Poprawka jest niewielka: nadaj każdemu tekstowi nazwę i zadanie, i opakuj każdy z nich we własny tag. Przewodnik po promptowaniu Anthropic (strona na bieżąco aktualizowana, sprawdzona 31 października 2026) zaleca oznaczanie każdego typu treści tagiem, aby model nie pomylił, co jest instrukcją, co tłem, a co danymi wejściowymi. Poniżej znajduje się prompt przed i po oraz działające żądanie chat completion, które możesz wysłać do CheapTokens API.
Co się psuje, gdy tylko wklejasz#
Weź najprostszy przypadek. Dostawca przysyła nowy opis produktu, a ty chcesz wiedzieć, co się zmieniło względem tego na twojej stronie sklepu. Wklejasz oba pod "Co się zmieniło?" i wysyłasz. Dla ciebie kolejność jest oczywista. Dla modelu to dwa bloki tekstu bez niczego pomiędzy, a pytanie nigdzie nie mówi, który jest stary. Może zgadnąć dobrze. Może też nazwać nowy tekst starym i podać ci listę zmian biegnącą wstecz, doskonale pewnym głosem.
Ta sama pułapka czai się w codziennych zadaniach:
- dwie wersje umowy, a ty pytasz, co zmieniła druga strona;
- trzy notatki ze spotkań, a ty pytasz, które decyzje są ze sobą sprzeczne;
- próbka stylu plus szkic: który naśladować, który przepisać?
- log błędów wklejony razem z kodem, a pytanie brzmi "napraw to".
W każdym z nich model potrzebuje dwóch rzeczy na tekst: nazwy (czym jest i skąd pochodzi) oraz roli (co ma z nim zrobić).
Nadaj każdemu tekstowi nazwę i zadanie#
Trzy drobne kroki:
- Umieść każdy tekst we własnym tagu. Przewodnik Anthropic sugeruje opakowanie
<documents>z jednym<document index="1">na tekst, a w środku<source>na nazwę i<document_na sam tekst.content> - Powiedz w instrukcji, poza tagami, czym jest każdy z nich: "Dokument 1 to STARY tekst z naszego sklepu. Dokument 2 to NOWY tekst od dostawcy."
- Zadaj pytanie tymi samymi słowami. "Wypisz każdy fakt, który się zmienił, jako stary -> nowy" ma teraz stary i nowy, na które można wskazać.
Oto przykład z butelką przed i po:
Porównaj
To samo żądanie, przed i po
Przed
What changed?

Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.

Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
Po
Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
</document_content>
</document>
</documents>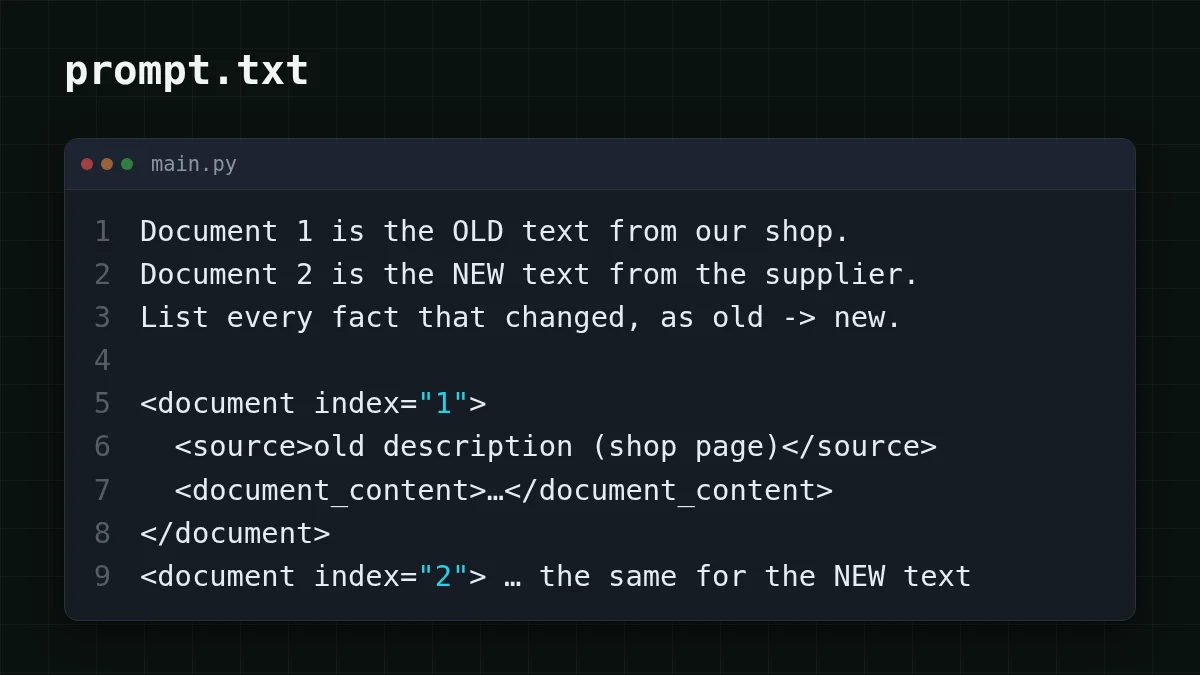
Etykiety kosztują kilka tokenów i usuwają zgadywanie. Anthropic napisał tę radę dla swoich modeli Claude, ale etykiety to zwykły tekst, więc nic nie stoi na przeszkodzie, by wysłać ten sam układ do innego modelu czatu.
Wyślij to jako prawdziwe żądanie#
Oto prompt "po" jako wywołanie API. Adres to https:/, API jest zgodne z OpenAI, a model to deepseek-. Identyfikatory modeli bierz z dokumentacji CheapTokens: nazwy różnią się między dostawcami. DeepSeek-V4-Flash ma okno kontekstu 380K i do 32 768 tokenów wyjściowych na odpowiedź, co zostawia miejsce na stos długich tekstów. Klucz pochodzi ze zmiennej środowiskowej, nigdy z kodu.
To samo żądanie w dwóch narzędziach
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

old = "Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe."
new = "Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only."

prompt = f"""Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
{old}
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
{new}
</document_content>
</document>
</documents>"""

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": prompt}],
    max_tokens=300,
)
print(response.choices[0].message.content)
print(response.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 300,
    "messages": [{
      "role": "user",
      "content": "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.\n\n<documents>\n<document index=\"1\">\n<source>old description (current shop page)</source>\n<document_content>\nSteel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.\n</document_content>\n</document>\n<document index=\"2\">\n<source>new description (from the supplier)</source>\n<document_content>\nSteel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.\n</document_content>\n</document>\n</documents>"
    }]
  }'
Odpowiedź to zwykły tekst w choices[0]., a usage obok liczy tokeny. Dobra odpowiedź wymienia trzy zmiany: 500 ml -> 750 ml, 12 godzin -> 24 godziny, zmywarka -> tylko ręczne mycie. Jeśli strzałki biegną w drugą stronę, model zgubił etykiety. Sprawdź, czy instrukcja nazywa dokumenty tak samo jak tagi.
Ile kosztują etykiety#
Tagi to tekst, a tekst jest rozliczany. Powiedzmy, że lider zespołu wrzuca trzy notatki ze spotkań po około 2000 tokenów każda i pyta, które decyzje są sprzeczne. Trzy notatki: 3 × 2000 = 6000 tokenów. Dodaj około 150 tokenów na instrukcję i tagi (założenie), a żądanie niesie 6150 tokenów na wejściu, z odpowiedzią 300 tokenów na wyjściu. W DeepSeek-V4-Flash to jedno żądanie kosztuje $0.00012, a same tagi to błąd zaokrąglenia przy notatkach. Oto to samo żądanie wysłane 1000 razy, z OpenRouter obok:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.135 | $0.231 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00012 | $0.122 | $0.473 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00035 | $0.353 | $4.23 |
6150 tokenów wejściowych i 300 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Wszystkie 6150 tokenów mieszczą się w oknie 380K z zapasem (czym jest okno kontekstu). Licząc łącznie, wejście i wyjście razem, żądanie wychodzi taniej niż w OpenRouter. Wejście i wyjście są rozliczane według różnych stawek, a tokeny wejściowe vs wyjściowe wyjaśniają dlaczego. Aktualne liczby dla każdego modelu są na stronie z cennikiem.
Nawyków na większe stosy tekstów#
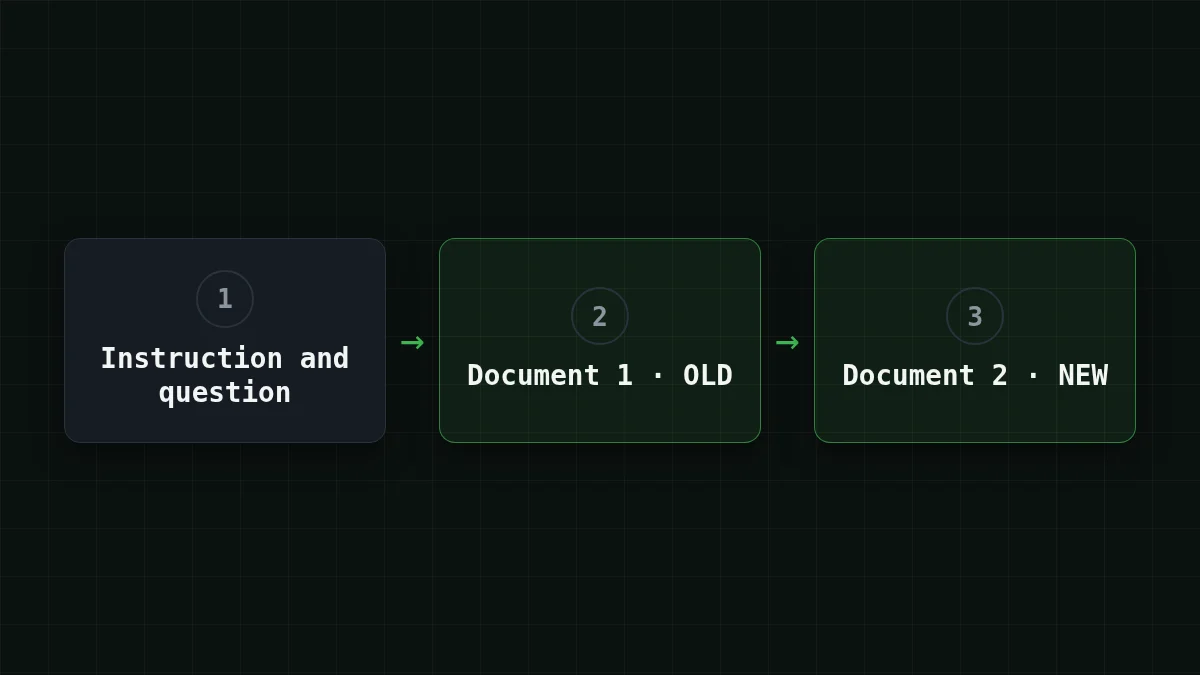
Gdy tekstów jest więcej niż dwa, same numery nie wystarczą: każdy potrzebuje własnej nazwy. Poniższy obrazek pokazuje układ z przykładu: najpierw instrukcja z pytaniem, potem każdy dokument we własnym tagu.
- Nazywaj po treści, nie tylko po numerze.
<source>contract v2, sent by the client</bijesource> document 2, gdy odpowiedź cytuje to z powrotem do ciebie. - Trzymaj instrukcję poza tagami, żeby wiersz wewnątrz wklejonego tekstu nie został wzięty za polecenie.
- Jeden tekst, jeden tag. Długi plik to nadal jeden tag; dwa pliki to dwa.
- Używaj tych samych nazw w pytaniu: "które decyzje w monday-notes są sprzeczne z wednesday-notes?"
- Nadawaj role także przykładom. "Dokument 1 to próbka stylu: naśladuj jego ton, nie fakty. Dokument 2 to szkic do przepisania."
Spróbuj samSpróbuj: masz log błędów i kod, który go wywołał, w jednym promptcie. Co dodajesz do każdego?Pokaż odpowiedź
Nazwę i zadanie. Do logu: <source>error log from the last run</ plus "to jest objaw, nie edytuj go". Do kodu: <source>app. plus "to jest do naprawienia". Potem poproś o poprawkę, używając tych nazw.
Podstawy reszty promptu (cel, kontekst, format) znajdziesz w jak napisać dobry prompt.


