KI für EinsteigerAnleitung
Benenne jedes Dokument in einem Prompt, damit das Modell sie nicht verwechselt
Wie du jedem eingefügten Text einen Namen und eine Rolle gibst, mit einem Vorher/Nachher-Prompt und einer funktionierenden Chat-Completion-Anfrage in Python und curl.
Auf dieser Seite
Du hast zwei Texte in eine Nachricht eingefügt und das Modell gebeten, sie zu vergleichen. Wenn du nicht sagst, welcher welcher ist, muss es raten. Die Lösung ist klein: Gib jedem Text einen Namen und eine Aufgabe und packe jeden in sein eigenes Tag. Anthropics Prompting-Leitfaden (eine lebende Seite, geprüft am 31. Oktober 2026) empfiehlt, jeden Inhaltstyp zu taggen, damit das Modell nicht falsch versteht, was eine Anweisung, was Hintergrund und was die Eingabe ist. Unten findest du einen Vorher/Nachher-Prompt und eine funktionierende Chat-Completion-Anfrage, die du an die CheapTokens API senden kannst.
Was schiefgeht, wenn du einfach einfügst#
Nimm den einfachsten Fall. Ein Lieferant schickt eine neue Produktbeschreibung, und du willst wissen, was sich gegenüber der auf deiner Shop-Seite geändert hat. Du fügst beide unter „Was hat sich geändert?“ ein und drückst Senden. Für dich ist die Reihenfolge offensichtlich. Für das Modell sind es zwei Textblöcke ohne alles dazwischen, und die Frage sagt nie, welcher der alte ist. Es kann richtig raten. Es kann aber auch den neuen Text für den alten halten und dir eine Liste von Änderungen rückwärts liefern, in perfekt selbstsicherem Ton.
Dieselbe Falle steckt in alltäglichen Aufgaben:
- zwei Versionen eines Vertrags, und du fragst, was die andere Seite geändert hat;
- drei Meeting-Notizen, und du fragst, welche Entscheidungen sich widersprechen;
- ein Stilbeispiel plus ein Entwurf: welchen nachahmen, welchen umschreiben?
- ein Fehlerprotokoll zusammen mit dem Code eingefügt, und die Frage lautet „behebe das“.
In jedem Fall braucht das Modell pro Text zwei Dinge: einen Namen (was es ist und woher es kommt) und eine Rolle (was du damit tun willst).
Gib jedem Text einen Namen und eine Aufgabe#
Drei kleine Schritte:
- Packe jeden Text in sein eigenes Tag. Anthropics Leitfaden schlägt einen
<documents>-Wrapper mit einem<document index="1">pro Text vor, und darin ein<source>für den Namen und<document_für den Text selbst.content> - Sag in der Anweisung, außerhalb der Tags, was jedes ist: „Dokument 1 ist der ALTE Text aus unserem Shop. Dokument 2 ist der NEUE Text vom Lieferanten.“
- Stelle die Frage mit denselben Worten. „Liste jede geänderte Tatsache auf, als alt -> neu“ hat jetzt ein Alt und ein Neu, auf die es sich beziehen kann.
Hier ist das Flaschenbeispiel vorher und nachher:
Vergleichen
Dieselbe Anfrage, vorher und nachher
Vorher
What changed?

Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.

Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
Nachher
Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
</document_content>
</document>
</documents>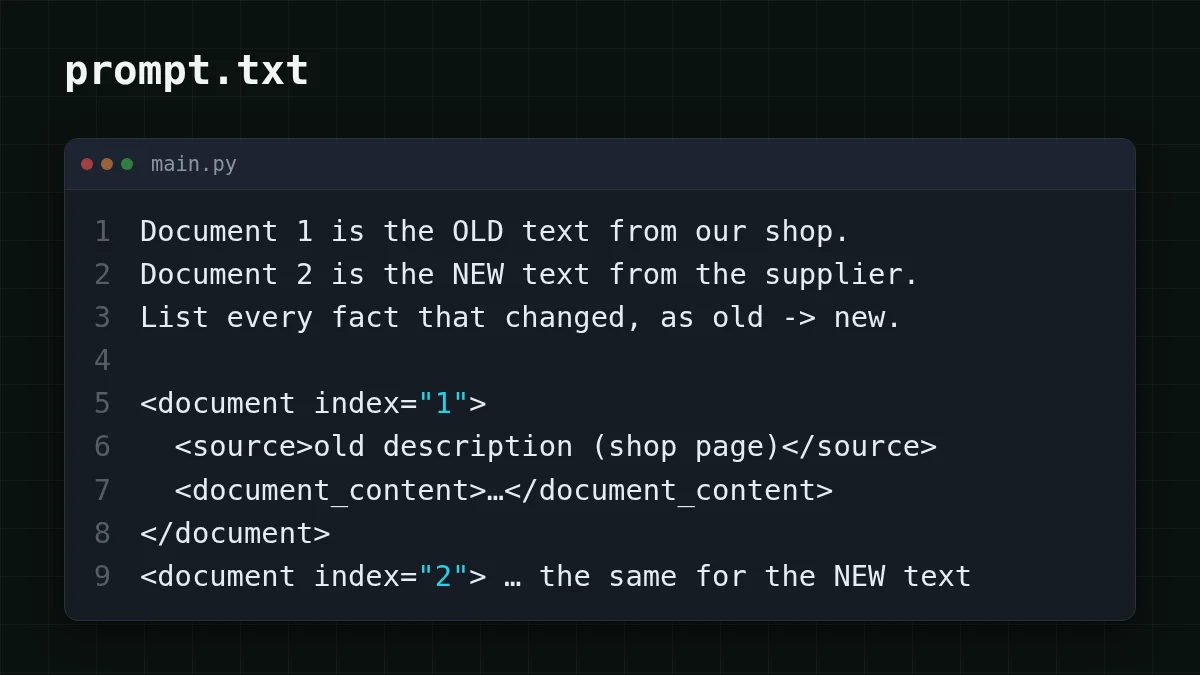
Die Labels kosten ein paar Tokens und nehmen das Raten heraus. Anthropic hat diesen Rat für seine Claude-Modelle geschrieben, aber die Labels sind reiner Text, also hindert dich nichts daran, dasselbe Layout an ein anderes Chat-Modell zu senden.
Sende es als echte Anfrage#
Hier ist der „Nachher“-Prompt als API-Aufruf. Die Adresse ist https:/, die API ist OpenAI-kompatibel, und das Modell ist deepseek-. Nimm Modell-IDs aus der CheapTokens-Doku: Die Namen unterscheiden sich zwischen den Anbietern. DeepSeek-V4-Flash hat ein Kontextfenster von 380K und bis zu 32.768 Ausgabe-Tokens pro Antwort, was Platz für einen Haufen langer Texte lässt. Der Schlüssel kommt aus einer Umgebungsvariable, nie aus dem Code.
Dieselbe Anfrage in zwei Tools
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

old = "Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe."
new = "Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only."

prompt = f"""Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
{old}
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
{new}
</document_content>
</document>
</documents>"""

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": prompt}],
    max_tokens=300,
)
print(response.choices[0].message.content)
print(response.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 300,
    "messages": [{
      "role": "user",
      "content": "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.\n\n<documents>\n<document index=\"1\">\n<source>old description (current shop page)</source>\n<document_content>\nSteel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.\n</document_content>\n</document>\n<document index=\"2\">\n<source>new description (from the supplier)</source>\n<document_content>\nSteel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.\n</document_content>\n</document>\n</documents>"
    }]
  }'
Die Antwort ist reiner Text in choices[0]., und usage daneben zählt die Tokens. Eine gute Antwort listet drei Änderungen auf: 500 ml -> 750 ml, 12 Stunden -> 24 Stunden, spülmaschinenfest -> nur Handwäsche. Wenn die Pfeile in die andere Richtung laufen, hat das Modell die Labels verloren. Prüfe, ob die Anweisung die Dokumente genauso nennt wie die Tags.
Was die Labels kosten#
Tags sind Text, und Text wird berechnet. Angenommen, eine Teamleitung gibt drei Meeting-Notizen von je etwa 2.000 Tokens ein und fragt, welche Entscheidungen sich widersprechen. Drei Notizen: 3 × 2.000 = 6.000 Tokens. Füge etwa 150 Tokens für die Anweisung und die Tags hinzu (eine Annahme), und die Anfrage trägt 6.150 Tokens hinein, mit einer 300-Token-Antwort heraus. Auf DeepSeek-V4-Flash kostet diese eine Anfrage $0.00012, und die Tags selbst sind ein Rundungsfehler neben den Notizen. Hier ist dieselbe Anfrage 1.000-mal gesendet, mit OpenRouter daneben:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.135 | $0.231 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00012 | $0.122 | $0.473 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00035 | $0.353 | $4.23 |
6.150 Input- und 300 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Alle 6.150 Tokens passen mit reichlich Platz in das 380K-Fenster (was ein Kontextfenster ist). Insgesamt gezählt, Eingabe und Ausgabe zusammen, kommt die Anfrage günstiger heraus als bei OpenRouter. Eingabe und Ausgabe werden zu unterschiedlichen Sätzen berechnet, und Eingabe- vs. Ausgabe-Tokens erklärt warum. Aktuelle Zahlen für jedes Modell stehen auf der Preisseite.
Gewohnheiten für größere Textmengen#
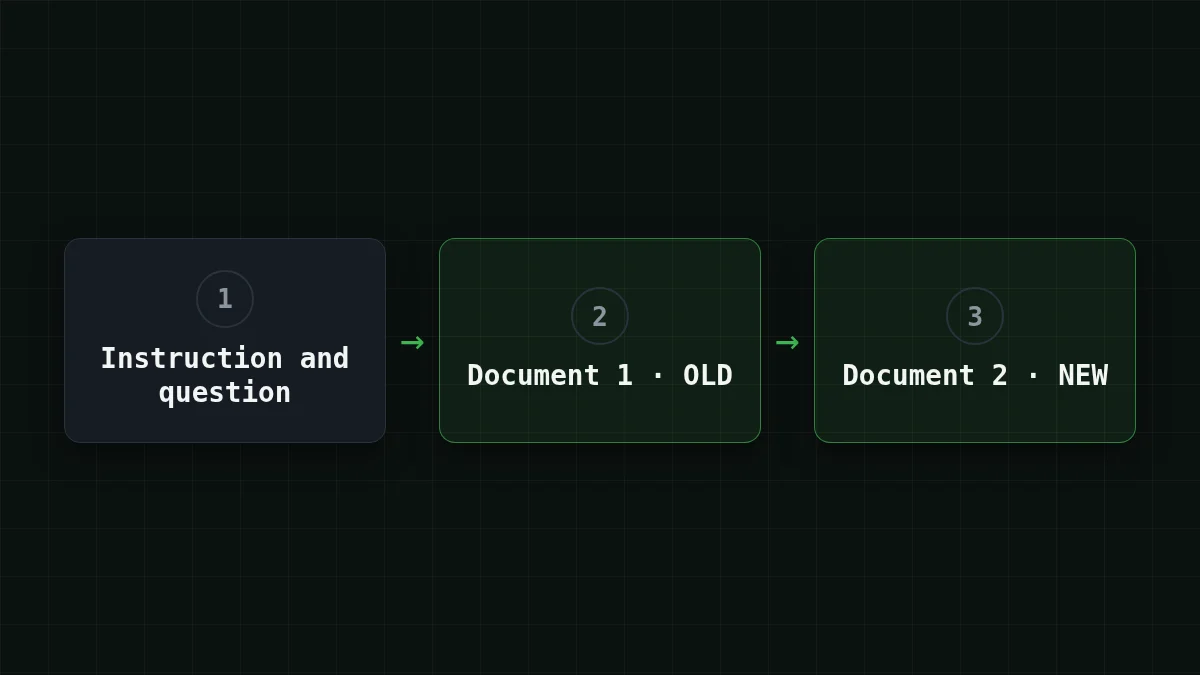
Sobald es mehr als zwei Texte gibt, reichen Nummern allein nicht: Jeder braucht seinen eigenen Namen. Das Bild unten zeigt das Layout aus dem Beispiel: zuerst die Anweisung mit der Frage, dann jedes Dokument in seinem eigenen Tag.
- Benenne nach Inhalt, nicht nur nach Nummer.
<source>contract v2, sent by the client</schlägtsource> document 2, wenn die Antwort es dir zurückzitiert. - Halte deine Anweisung außerhalb der Tags, damit eine Zeile in einem eingefügten Text nicht für einen Befehl gehalten wird.
- Ein Text, ein Tag. Eine lange Datei ist immer noch ein Tag; zwei Dateien sind zwei.
- Verwende die Namen in der Frage wieder: „welche Entscheidungen in monday-notes widersprechen wednesday-notes?“
- Gib auch Beispielen Rollen. „Dokument 1 ist ein Stilbeispiel: übernimm seinen Ton, nicht seine Fakten. Dokument 2 ist der Entwurf zum Umschreiben.“
Probier es selbstProbier es aus: Du hast ein Fehlerprotokoll und den Code, der es erzeugt hat, in einem Prompt. Was fügst du jedem hinzu?Antwort anzeigen
Einen Namen und eine Aufgabe. Für das Protokoll: <source>error log from the last run</ plus „das ist das Symptom, nicht bearbeiten“. Für den Code: <source>app. plus „das ist zu beheben“. Dann frage nach der Behebung mit diesen Namen.
Für die Grundlagen des restlichen Prompts (Ziel, Kontext, Format) siehe wie man einen guten Prompt schreibt.


