Lagyan ng label ang bawat dokumento sa isang prompt para hindi ito paghalo-haluin ng modelo
Paano bigyan ang bawat na-paste na teksto ng pangalan at papel, na may before/after na prompt at gumaganang chat completion request sa Python at curl.
Sa pahinang ito
Nag-paste ka ng dalawang teksto sa isang mensahe at hiniling sa modelo na ihambing ang mga ito. Maliban kung sinabi mo kung alin ang alin, kailangan nitong hulaan. Maliit lang ang solusyon: bigyan ang bawat teksto ng pangalan at trabaho, at balutin ang bawat isa sa sarili nitong tag. Inirerekomenda ng prompting guide ng Anthropic (isang live na pahina, sinuri noong 31 Oktubre 2026) na i-tag ang bawat uri ng nilalaman upang hindi maling basahin ng modelo kung ano ang instruksyon, ano ang background, at ano ang input. Nasa ibaba ang before/after na prompt at isang gumaganang chat completion request na maaari mong ipadala sa CheapTokens API.
Ano ang mali kapag nag-paste ka lang#
Kunin ang pinakasimpleng kaso. Nagpadala ang isang supplier ng bagong paglalarawan ng produkto, at gusto mong malaman kung ano ang nagbago kumpara sa nasa pahina ng iyong shop. I-paste mo ang dalawa sa ilalim ng "What changed?" at pindutin ang send. Para sa iyo, malinaw ang pagkakasunod-sunod. Para sa modelo, dalawang bloke ito ng teksto na walang namamagitan, at hindi sinasabi ng tanong kung alin ang luma. Maaaring tama ang hula nito. Maaari rin nitong tawagin ang bagong teksto na luma at bigyan ka ng listahan ng mga pagbabago na pabaliktad, sa isang lubos na kumpiyansang boses.
Nakatago ang parehong bitag sa araw-araw na gawain:
- dalawang bersyon ng kontrata, at itatanong mo kung ano ang binago ng kabilang panig;
- tatlong tala ng miting, at itatanong mo kung aling mga desisyon ang nagkakasalungatan;
- isang halimbawa ng estilo kasama ng isang draft: alin ang gagayahin, alin ang isusulat muli?
- isang error log na na-paste kasama ng code, at ang tanong ay "ayusin ito".
Sa bawat isa sa kanila, kailangan ng modelo ng dalawang bagay sa bawat teksto: isang pangalan (ano ito at saan ito galing) at isang papel (ano ang gusto mong gawin dito).
Bigyan ang bawat teksto ng pangalan at trabaho#
Tatlong maliliit na hakbang:
- Ilagay ang bawat teksto sa sarili nitong tag. Iminumungkahi ng guide ng Anthropic ang isang
<documents>wrapper na may isang<document index="1">bawat teksto, at sa loob nito ay isang<source>para sa pangalan at<document_para sa teksto mismo.content> - Sabihin kung ano ang bawat isa sa instruksyon, sa labas ng mga tag: "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier."
- Itanong ang tanong sa parehong mga salita. Ang "List every fact that changed, as old -> new" ay mayroon nang old at new na matutukoy.
Narito ang halimbawa ng bote bago at pagkatapos:
Ihambing
Parehong request, bago at pagkatapos
Bago
What changed?

Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.

Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
Pagkatapos
Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
</document_content>
</document>
</documents>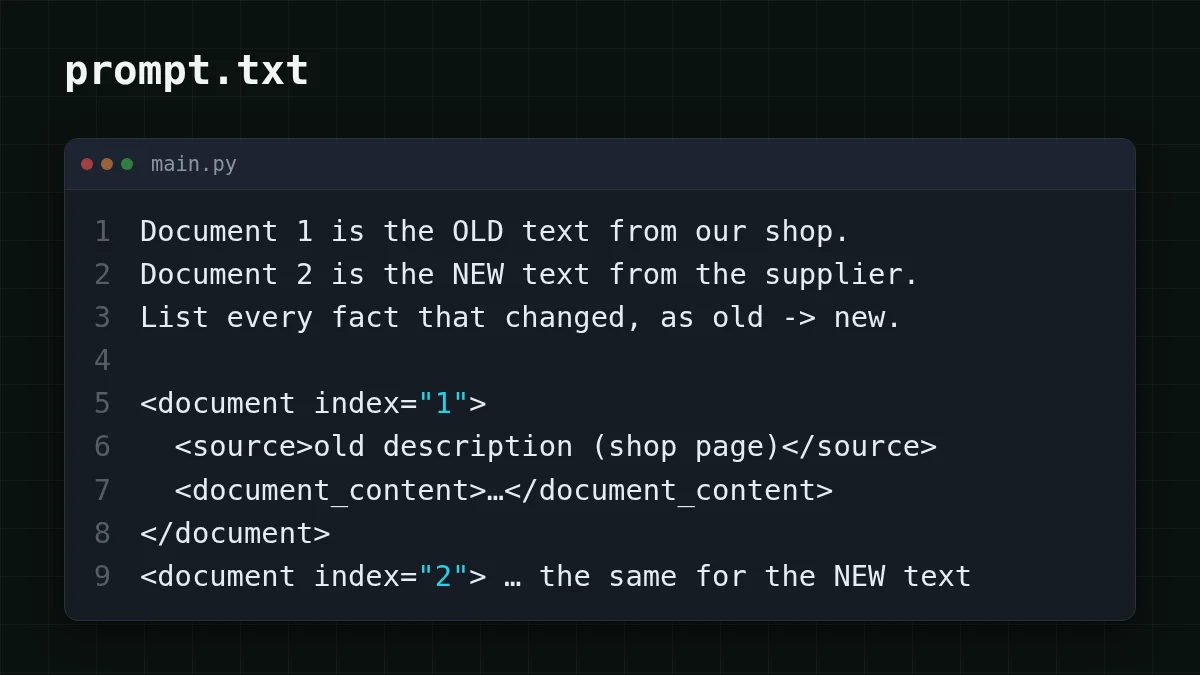
Ang mga label ay nagkakahalaga ng ilang token at inaalis ang hula. Isinulat ng Anthropic ang payong ito para sa mga modelong Claude nito, ngunit ang mga label ay plain text, kaya walang pumipigil sa iyo na ipadala ang parehong layout sa ibang chat model.
Ipadala ito bilang tunay na request#
Narito ang "pagkatapos" na prompt bilang isang API call. Ang address ay https:/, ang API ay OpenAI-compatible, at ang modelo ay deepseek-. Kunin ang mga model id mula sa mga doc ng CheapTokens: nagkakaiba ang mga pangalan sa pagitan ng mga provider. Ang DeepSeek-V4-Flash ay may 380K context window at hanggang 32,768 output token bawat sagot, na nag-iiwan ng espasyo para sa isang tumpok ng mahahabang teksto. Ang key ay galing sa isang environment variable, hindi kailanman mula sa code.
Ang parehong request sa dalawang tool
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

old = "Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe."
new = "Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only."

prompt = f"""Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
{old}
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
{new}
</document_content>
</document>
</documents>"""

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": prompt}],
    max_tokens=300,
)
print(response.choices[0].message.content)
print(response.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 300,
    "messages": [{
      "role": "user",
      "content": "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.\n\n<documents>\n<document index=\"1\">\n<source>old description (current shop page)</source>\n<document_content>\nSteel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.\n</document_content>\n</document>\n<document index=\"2\">\n<source>new description (from the supplier)</source>\n<document_content>\nSteel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.\n</document_content>\n</document>\n</documents>"
    }]
  }'
Ang sagot ay plain text sa choices[0]., at ang usage sa tabi nito ay nagbibilang ng mga token. Ang isang magandang sagot ay naglilista ng tatlong pagbabago: 500 ml -> 750 ml, 12 hours -> 24 hours, dishwasher safe -> hand wash only. Kung pabaliktad ang mga arrow, nawala ang track ng modelo sa mga label. Tiyakin na ang instruksyon ay tumatawag sa mga dokumento ng parehong pangalan na ginagamit ng mga tag.
Magkano ang gastos ng mga label#
Ang mga tag ay teksto, at ang teksto ay sinisingil. Sabihin nating ang isang team lead ay nagpapasok ng tatlong tala ng miting na mga 2,000 token bawat isa at nagtatanong kung aling mga desisyon ang nagkakasalungatan. Tatlong tala: 3 × 2,000 = 6,000 token. Magdagdag ng mga 150 token para sa instruksyon at mga tag (isang pagpapalagay) at ang request ay may 6,150 token na pumapasok, na may 300-token na sagot na lumalabas. Sa DeepSeek-V4-Flash, ang isang request na iyon ay nagkakahalaga ng $0.00012, at ang mga tag mismo ay isang rounding error kumpara sa mga tala. Narito ang parehong request na ipinadala ng 1,000 beses, kasama ang OpenRouter:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.135 | $0.231 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00012 | $0.122 | $0.473 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00035 | $0.353 | $4.23 |
6,150 input at 300 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Lahat ng 6,150 token ay kasya sa 380K window na may labis pang espasyo (ano ang context window). Kung bibilangin sa kabuuan, input at output na magkasama, ang request ay lumalabas na mas mura kaysa sa OpenRouter. Ang input at output ay sinisingil sa magkaibang rate, at ipinapaliwanag ng input vs output tokens kung bakit. Ang kasalukuyang mga numero para sa bawat modelo ay nasa pricing page.
Mga gawi para sa mas malalaking tumpok ng teksto#
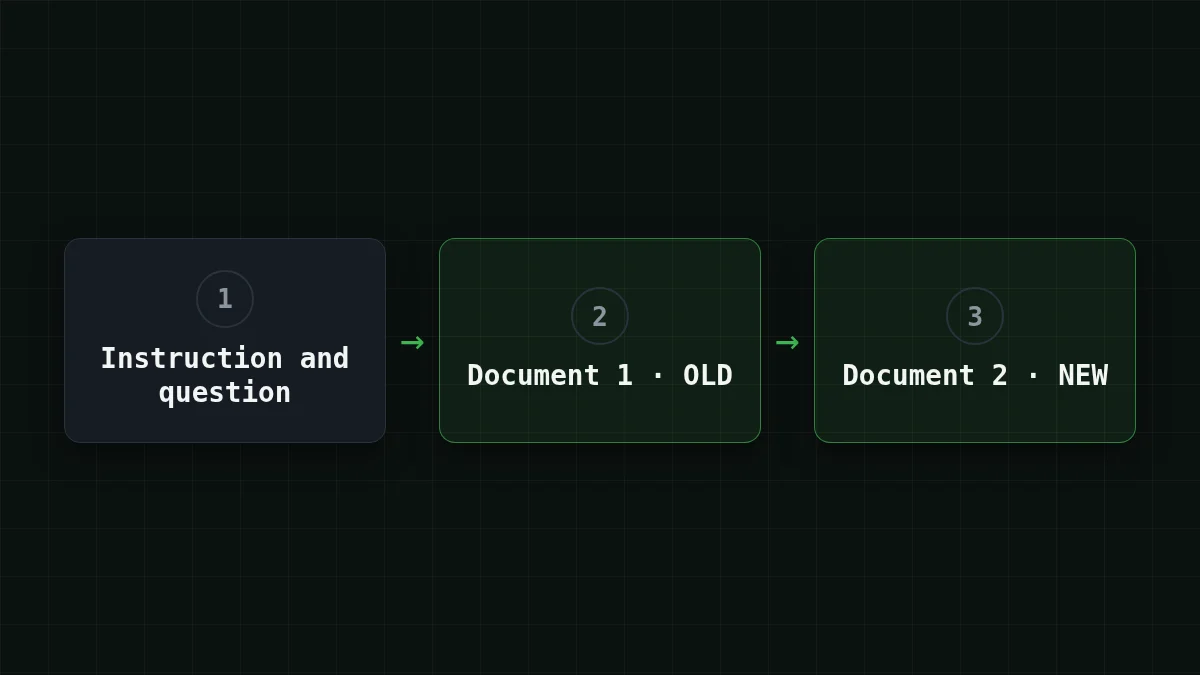
Kapag higit sa dalawa ang teksto, hindi sapat ang mga numero lang: kailangan ng bawat isa ng sariling pangalan. Ipinapakita ng larawan sa ibaba ang layout mula sa halimbawa: ang instruksyon na may tanong muna, pagkatapos ang bawat dokumento sa sarili nitong tag.
- Pangalanan ayon sa nilalaman, hindi ayon sa numero lang. Mas mainam ang
<source>contract v2, sent by the client</kaysa sasource> document 2kapag sinipi ito pabalik sa iyo ng sagot. - Panatilihin ang iyong instruksyon sa labas ng mga tag, upang ang isang linya sa loob ng na-paste na teksto ay hindi mapagkamalang utos.
- Isang teksto, isang tag. Ang mahabang file ay isang tag pa rin; ang dalawang file ay dalawa.
- Gamitin muli ang mga pangalan sa tanong: "which decisions in monday-notes contradict wednesday-notes?"
- Bigyan din ng papel ang mga halimbawa. "Document 1 is a style sample: copy its tone, not its facts. Document 2 is the draft to rewrite."
Subukan mo mismoSubukan: mayroon kang isang error log at ang code na gumawa nito sa isang prompt. Ano ang idadagdag mo sa bawat isa?Ipakita ang sagot
Isang pangalan at isang trabaho. Para sa log: <source>error log from the last run</ kasama ang "this is the symptom, don't edit it". Para sa code: <source>app. kasama ang "this is what to fix". Pagkatapos, hilingin ang pag-aayos gamit ang mga pangalang iyon.
Para sa mga pangunahing kaalaman sa natitirang bahagi ng prompt (layunin, konteksto, format), tingnan ang how to write a good prompt.


