IA pour débutantsGuide
Étiquetez chaque document d'un prompt pour que le modèle ne les confonde pas
Comment donner à chaque texte collé un nom et un rôle, avec un prompt avant/après et une requête de chat completion fonctionnelle en Python et curl.
Sur cette page
Vous avez collé deux textes dans un seul message et demandé au modèle de les comparer. Sauf si vous avez précisé lequel est lequel, il doit deviner. La correction est simple : donnez à chaque texte un nom et un rôle, et entourez chacun de sa propre balise. Le guide de prompting d'Anthropic (une page évolutive, consultée le 31 octobre 2026) recommande de baliser chaque type de contenu pour que le modèle ne confonde pas ce qui est une instruction, ce qui est du contexte et ce qui est l'entrée. Voici un prompt avant/après et une requête de chat completion fonctionnelle que vous pouvez envoyer à l'API CheapTokens.
Ce qui casse quand on se contente de coller#
Prenez le cas le plus simple. Un fournisseur envoie une nouvelle description de produit, et vous voulez savoir ce qui a changé par rapport à celle de votre page boutique. Vous collez les deux sous « Qu'est-ce qui a changé ? » et vous envoyez. Pour vous, l'ordre est évident. Pour le modèle, ce sont deux blocs de texte sans rien entre eux, et la question ne dit jamais lequel est l'ancien. Il peut tomber juste. Il peut aussi prendre le nouveau texte pour l'ancien et vous rendre une liste de changements à l'envers, d'une voix parfaitement assurée.
Le même piège se cache dans les tâches du quotidien :
- deux versions d'un contrat, et vous demandez ce que l'autre partie a modifié ;
- trois comptes rendus de réunion, et vous demandez quelles décisions se contredisent ;
- un échantillon de style plus un brouillon : lequel imiter, lequel réécrire ?
- un journal d'erreurs collé avec le code, et la question est « corrige ça ».
Dans chacun de ces cas, le modèle a besoin de deux choses par texte : un nom (ce que c'est et d'où ça vient) et un rôle (ce que vous voulez en faire).
Donnez à chaque texte un nom et un rôle#
Trois petits gestes :
- Placez chaque texte dans sa propre balise. Le guide d'Anthropic suggère un conteneur
<documents>avec un<document index="1">par texte, et à l'intérieur un<source>pour le nom et<document_pour le texte lui-même.content> - Dites ce qu'est chacun dans l'instruction, en dehors des balises : « Le document 1 est l'ANCIEN texte de notre boutique. Le document 2 est le NOUVEAU texte du fournisseur. »
- Posez la question avec les mêmes mots. « Liste chaque fait qui a changé, sous la forme ancien -> nouveau » a désormais un ancien et un nouveau auxquels se référer.
Voici l'exemple de la bouteille avant et après :
Comparer
Même requête, avant et après
Avant
What changed?

Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.

Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
Après
Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
</document_content>
</document>
</documents>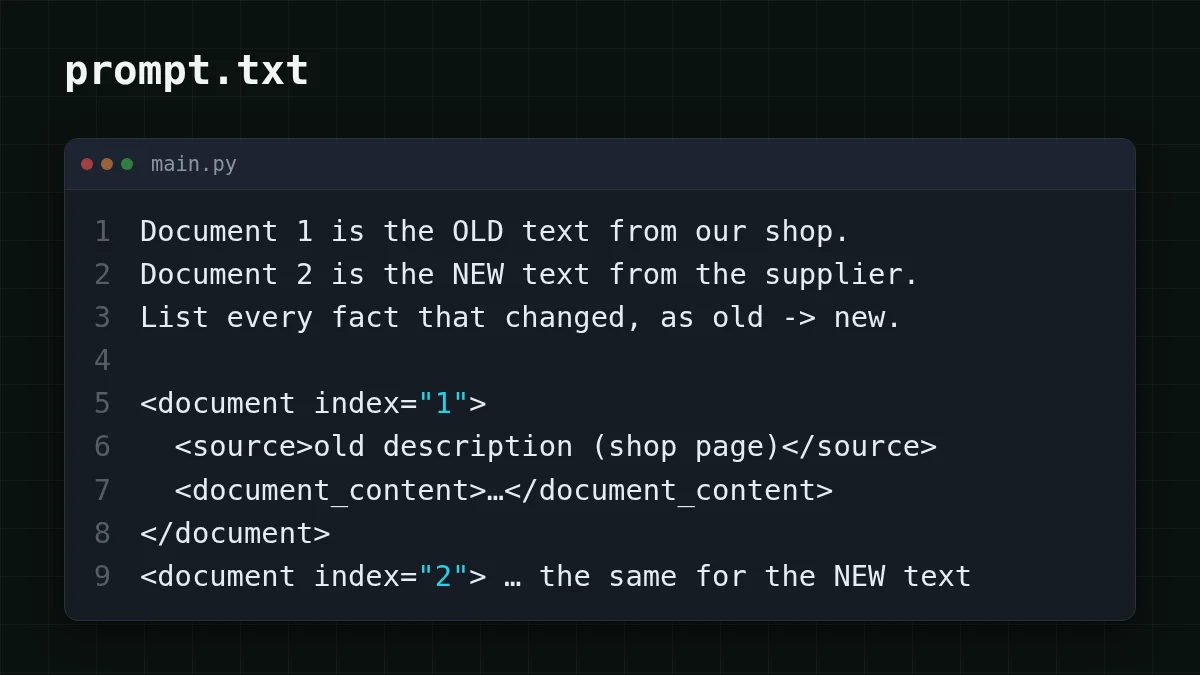
Les étiquettes coûtent quelques tokens et éliminent les devinettes. Anthropic a écrit ce conseil pour ses modèles Claude, mais les étiquettes sont du texte brut, donc rien ne vous empêche d'envoyer la même disposition à un autre modèle de chat.
Envoyez-le comme une vraie requête#
Voici le prompt « après » sous forme d'appel API. L'adresse est https:/, l'API est compatible OpenAI, et le modèle est deepseek-. Prenez les identifiants de modèle dans la doc CheapTokens : les noms diffèrent selon les fournisseurs. DeepSeek-V4-Flash a une fenêtre de contexte de 380K et jusqu'à 32 768 tokens de sortie par réponse, ce qui laisse de la place pour une pile de longs textes. La clé vient d'une variable d'environnement, jamais du code.
La même requête dans deux outils
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

old = "Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe."
new = "Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only."

prompt = f"""Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
{old}
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
{new}
</document_content>
</document>
</documents>"""

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": prompt}],
    max_tokens=300,
)
print(response.choices[0].message.content)
print(response.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 300,
    "messages": [{
      "role": "user",
      "content": "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.\n\n<documents>\n<document index=\"1\">\n<source>old description (current shop page)</source>\n<document_content>\nSteel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.\n</document_content>\n</document>\n<document index=\"2\">\n<source>new description (from the supplier)</source>\n<document_content>\nSteel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.\n</document_content>\n</document>\n</documents>"
    }]
  }'
La réponse est du texte brut dans choices[0]., et usage à côté compte les tokens. Une bonne réponse liste trois changements : 500 ml -> 750 ml, 12 heures -> 24 heures, compatible lave-vaisselle -> lavage à la main uniquement. Si les flèches vont dans l'autre sens, le modèle a perdu le fil des étiquettes. Vérifiez que l'instruction nomme les documents exactement comme les balises.
Ce que coûtent les étiquettes#
Les balises sont du texte, et le texte est facturé. Disons qu'un chef d'équipe fournit trois comptes rendus de réunion d'environ 2 000 tokens chacun et demande quelles décisions entrent en conflit. Trois comptes rendus : 3 × 2 000 = 6 000 tokens. Ajoutez environ 150 tokens pour l'instruction et les balises (une hypothèse) et la requête transporte 6 150 tokens en entrée, avec une réponse de 300 tokens en sortie. Sur DeepSeek-V4-Flash, cette requête coûte $0.00012, et les balises elles-mêmes sont une erreur d'arrondi à côté des comptes rendus. Voici la même requête envoyée 1 000 fois, avec OpenRouter en parallèle :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.135 | $0.231 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00012 | $0.122 | $0.473 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00035 | $0.353 | $4.23 |
6 150 tokens d'entrée et 300 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Les 6 150 tokens tiennent tous dans la fenêtre de 380K avec de la marge (ce qu'est une fenêtre de contexte). En comptant le total, entrée et sortie ensemble, la requête revient moins cher qu'OpenRouter. L'entrée et la sortie sont facturées à des tarifs différents, et tokens d'entrée vs de sortie explique pourquoi. Les chiffres actuels pour chaque modèle sont sur la page de tarifs.
Habitudes pour de plus grosses piles de texte#
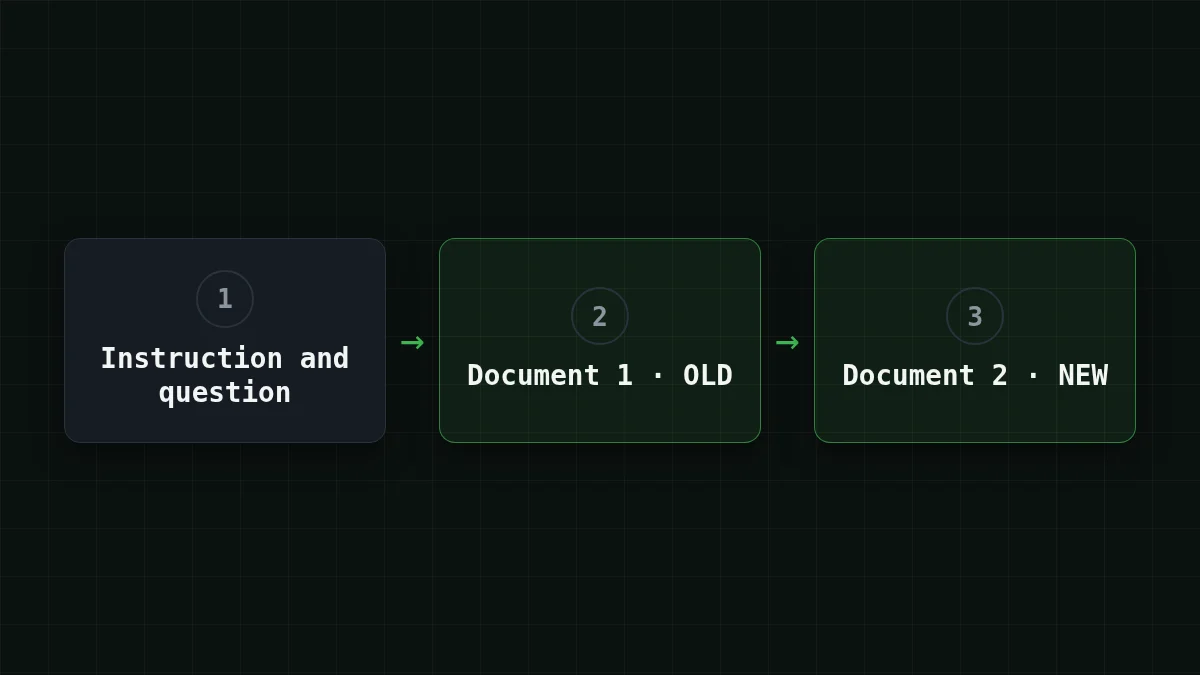
Dès qu'il y a plus de deux textes, les numéros seuls ne suffisent plus : chacun a besoin de son propre nom. L'image ci-dessous montre la disposition de l'exemple : l'instruction avec la question d'abord, puis chaque document dans sa propre balise.
- Nommez par contenu, pas par numéro seul.
<source>contract v2, sent by the client</vaut mieux quesource> document 2quand la réponse vous le cite. - Gardez votre instruction en dehors des balises, pour qu'une ligne dans un texte collé ne soit pas prise pour un ordre.
- Un texte, une balise. Un long fichier reste une balise ; deux fichiers font deux balises.
- Réutilisez les noms dans la question : « quelles décisions dans monday-notes contredisent wednesday-notes ? »
- Donnez aussi des rôles aux exemples. « Le document 1 est un échantillon de style : copie son ton, pas ses faits. Le document 2 est le brouillon à réécrire. »
Essayez vous-mêmeEssayez : vous avez un journal d'erreurs et le code qui l'a produit dans un seul prompt. Qu'ajoutez-vous à chacun ?Afficher la réponse
Un nom et un rôle. Pour le journal : <source>error log from the last run</ plus « c'est le symptôme, ne le modifie pas ». Pour le code : <source>app. plus « c'est ce qu'il faut corriger ». Demandez ensuite la correction par ces noms.
Pour les bases du reste du prompt (objectif, contexte, format), voir comment écrire un bon prompt.


