AI per principiantiGuida
Etichetta ogni documento in un prompt così il modello non li confonde
Come dare a ogni testo incollato un nome e un ruolo, con un prompt prima/dopo e una richiesta chat completion funzionante in Python e curl.
In questa pagina
Hai incollato due testi in un unico messaggio e hai chiesto al modello di confrontarli. A meno che tu non abbia detto quale è quale, deve indovinare. La soluzione è semplice: dai a ogni testo un nome e un compito, e avvolgi ciascuno nel proprio tag. La guida al prompting di Anthropic (una pagina viva, consultata il 31 ottobre 2026) consiglia di etichettare ogni tipo di contenuto così che il modello non fraintenda cos'è un'istruzione, cos'è il contesto e cos'è l'input. Qui sotto trovi un prompt prima/dopo e una richiesta chat completion funzionante che puoi inviare alla CheapTokens API.
Cosa va storto quando incolli e basta#
Prendi il caso più semplice. Un fornitore invia una nuova descrizione di prodotto e tu vuoi sapere cosa è cambiato rispetto a quella sulla pagina del tuo negozio. Incolli entrambe sotto "Cosa è cambiato?" e premi invio. Per te l'ordine è ovvio. Per il modello sono due blocchi di testo senza nulla in mezzo, e la domanda non dice mai quale sia il vecchio. Può indovinare bene. Può anche chiamare il nuovo testo il vecchio e restituirti un elenco di modifiche al contrario, con una voce perfettamente sicura.
La stessa trappola si nasconde nei lavori di tutti i giorni:
- due versioni di un contratto, e chiedi cosa ha cambiato l'altra parte;
- tre note di riunione, e chiedi quali decisioni si contraddicono;
- un campione di stile più una bozza: quale imitare, quale riscrivere?
- un log di errori incollato insieme al codice, e la domanda è "aggiusta questo".
In ognuno di questi casi il modello ha bisogno di due cose per ogni testo: un nome (cos'è e da dove viene) e un ruolo (cosa vuoi che ci venga fatto).
Dai a ogni testo un nome e un compito#
Tre piccole mosse:
- Metti ogni testo nel proprio tag. La guida di Anthropic suggerisce un wrapper
<documents>con un<document index="1">per testo, e al suo interno un<source>per il nome e<document_per il testo stesso.content> - Dì cos'è ciascuno nell'istruzione, fuori dai tag: "Il Documento 1 è il testo VECCHIO del nostro negozio. Il Documento 2 è il testo NUOVO del fornitore."
- Fai la domanda con le stesse parole. "Elenca ogni fatto che è cambiato, come vecchio -> nuovo" ora ha un vecchio e un nuovo a cui riferirsi.
Ecco l'esempio della bottiglia prima e dopo:
Confronta
Stessa richiesta, prima e dopo
Prima
What changed?

Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.

Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
Dopo
Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
</document_content>
</document>
</documents>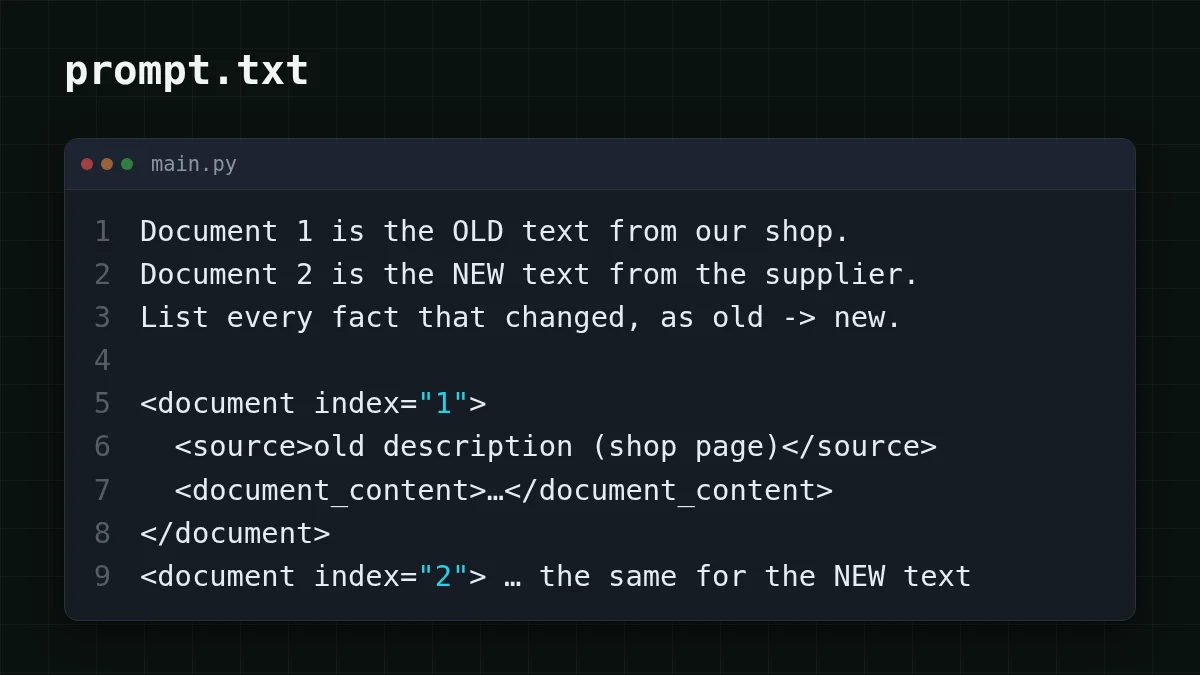
Le etichette costano qualche token e tolgono di mezzo le congetture. Anthropic ha scritto questo consiglio per i suoi modelli Claude, ma le etichette sono testo semplice, quindi nulla ti impedisce di inviare la stessa struttura a un altro modello chat.
Invialo come richiesta reale#
Ecco il prompt "dopo" come chiamata API. L'indirizzo è https:/, l'API è compatibile con OpenAI e il modello è deepseek-. Prendi gli id dei modelli dalla documentazione di CheapTokens: i nomi cambiano tra i provider. DeepSeek-V4-Flash ha una finestra di contesto di 380K e fino a 32.768 token di output per risposta, il che lascia spazio per una pila di testi lunghi. La chiave viene da una variabile d'ambiente, mai dal codice.
La stessa richiesta in due strumenti
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

old = "Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe."
new = "Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only."

prompt = f"""Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
{old}
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
{new}
</document_content>
</document>
</documents>"""

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": prompt}],
    max_tokens=300,
)
print(response.choices[0].message.content)
print(response.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 300,
    "messages": [{
      "role": "user",
      "content": "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.\n\n<documents>\n<document index=\"1\">\n<source>old description (current shop page)</source>\n<document_content>\nSteel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.\n</document_content>\n</document>\n<document index=\"2\">\n<source>new description (from the supplier)</source>\n<document_content>\nSteel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.\n</document_content>\n</document>\n</documents>"
    }]
  }'
La risposta è testo semplice in choices[0]., e usage accanto conta i token. Una buona risposta elenca tre modifiche: 500 ml -> 750 ml, 12 ore -> 24 ore, lavabile in lavastoviglie -> solo lavaggio a mano. Se le frecce vanno nell'altro verso, il modello ha perso di vista le etichette. Controlla che l'istruzione chiami i documenti con lo stesso nome che usano i tag.
Quanto costano le etichette#
I tag sono testo, e il testo si paga. Supponi che un team lead inserisca tre note di riunione da circa 2.000 token ciascuna e chieda quali decisioni sono in conflitto. Tre note: 3 × 2.000 = 6.000 token. Aggiungi circa 150 token per l'istruzione e i tag (una stima) e la richiesta porta 6.150 token in ingresso, con 300 token di risposta in uscita. Su DeepSeek-V4-Flash quella singola richiesta costa $0.00012, e i tag stessi sono un errore di arrotondamento rispetto alle note. Ecco la stessa richiesta inviata 1.000 volte, con OpenRouter accanto:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.135 | $0.231 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00012 | $0.122 | $0.473 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00035 | $0.353 | $4.23 |
6150 token di input e 300 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Tutti i 6.150 token stanno nella finestra da 380K con spazio in abbondanza (cos'è una finestra di contesto). Contando il totale, input e output insieme, la richiesta risulta più economica di OpenRouter. Input e output sono fatturati a tariffe diverse, e token di input vs output spiega perché. I numeri aggiornati per ogni modello sono sulla pagina dei prezzi.
Abitudini per pile di testo più grandi#
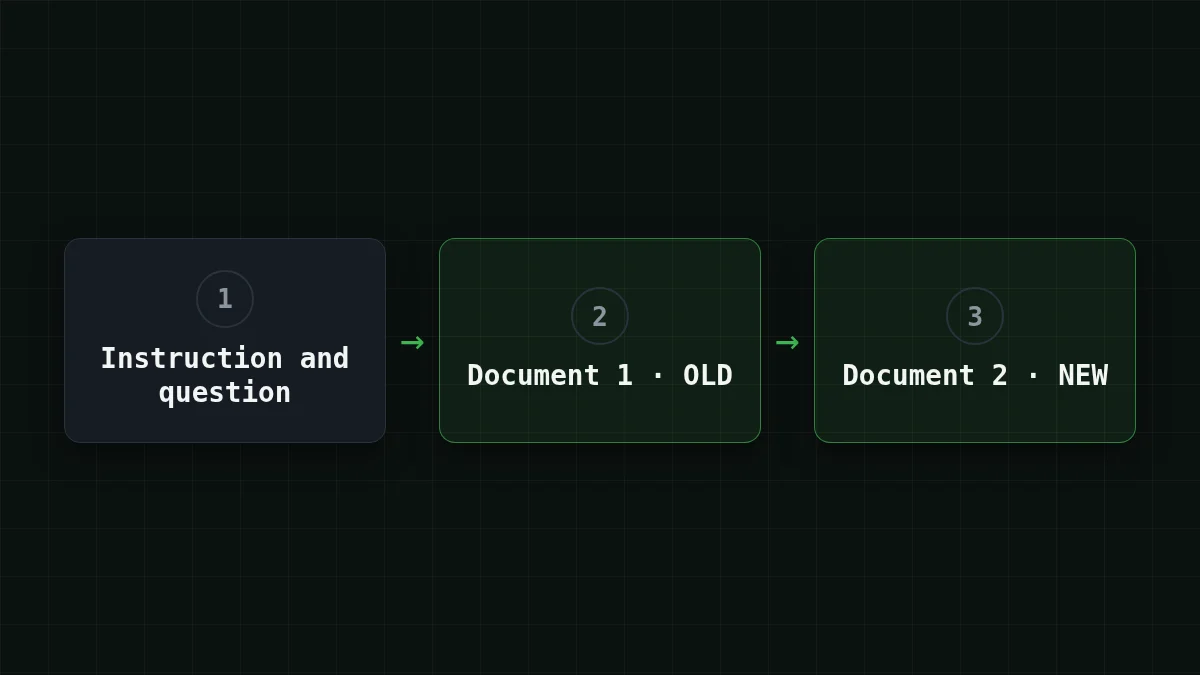
Quando i testi sono più di due, i numeri da soli non bastano: ognuno ha bisogno del proprio nome. L'immagine qui sotto mostra la struttura dell'esempio: prima l'istruzione con la domanda, poi ogni documento nel proprio tag.
- Nomina per contenuto, non solo per numero.
<source>contract v2, sent by the client</battesource> document 2quando la risposta te lo cita. - Tieni l'istruzione fuori dai tag, così una riga dentro un testo incollato non viene presa per un ordine.
- Un testo, un tag. Un file lungo è comunque un tag; due file sono due.
- Riusa i nomi nella domanda: "quali decisioni in monday-notes contraddicono wednesday-notes?"
- Dai un ruolo anche agli esempi. "Il Documento 1 è un campione di stile: copiane il tono, non i fatti. Il Documento 2 è la bozza da riscrivere."
Provalo tu stessoProva: hai un log di errori e il codice che l'ha prodotto in un unico prompt. Cosa aggiungi a ciascuno?Mostra risposta
Un nome e un compito. Per il log: <source>error log from the last run</ più "questo è il sintomo, non modificarlo". Per il codice: <source>app. più "questo è ciò che va corretto". Poi chiedi la correzione usando quei nomi.
Per le basi del resto del prompt (obiettivo, contesto, formato), vedi come scrivere un buon prompt.


