AI untuk pemulaPanduan
Beri label setiap dokumen dalam prompt agar model tidak mencampuradukkannya
Cara memberi setiap teks yang ditempel nama dan peran, dengan prompt sebelum/sesudah dan permintaan chat completion yang berfungsi dalam Python dan curl.
Di halaman ini
Anda menempelkan dua teks ke dalam satu pesan dan meminta model membandingkannya. Kecuali Anda menyebutkan mana yang mana, model harus menebak. Perbaikannya kecil: beri setiap teks nama dan tugas, dan bungkus masing-masing dalam tag-nya sendiri. Panduan prompting Anthropic (halaman yang terus diperbarui, diperiksa 31 Oktober 2026) merekomendasikan penandaan setiap jenis konten agar model tidak salah membaca mana yang instruksi, mana yang latar belakang, dan mana yang input. Berikut adalah prompt sebelum/sesudah dan permintaan chat completion yang berfungsi yang dapat Anda kirim ke CheapTokens API.
Apa yang salah saat Anda hanya menempel#
Ambil kasus paling sederhana. Pemasok mengirim deskripsi produk baru, dan Anda ingin tahu apa yang berubah dibandingkan dengan yang ada di halaman toko Anda. Anda menempelkan keduanya di bawah "Apa yang berubah?" dan tekan kirim. Bagi Anda urutannya jelas. Bagi model itu dua blok teks tanpa pemisah, dan pertanyaannya tidak pernah menyebut mana yang lama. Model mungkin menebak dengan benar. Mungkin juga menyebut teks baru sebagai yang lama dan memberi Anda daftar perubahan yang terbalik, dengan suara yang sangat percaya diri.
Jebakan yang sama tersembunyi dalam pekerjaan sehari-hari:
- dua versi kontrak, dan Anda bertanya apa yang diubah pihak lain;
- tiga catatan rapat, dan Anda bertanya keputusan mana yang saling bertentangan;
- contoh gaya plus draf: mana yang harus ditiru, mana yang harus ditulis ulang?
- log error ditempel bersama kode, dan pertanyaannya adalah "perbaiki ini".
Dalam setiap kasus, model membutuhkan dua hal per teks: nama (apa itu dan dari mana asalnya) dan peran (apa yang ingin Anda lakukan dengannya).
Beri setiap teks nama dan tugas#
Tiga langkah kecil:
- Letakkan setiap teks dalam tag-nya sendiri. Panduan Anthropic menyarankan pembungkus
<documents>dengan satu<document index="1">per teks, dan di dalamnya ada<source>untuk nama dan<document_untuk teks itu sendiri.content> - Sebutkan apa masing-masing dalam instruksi, di luar tag: "Dokumen 1 adalah teks LAMA dari toko kami. Dokumen 2 adalah teks BARU dari pemasok."
- Ajukan pertanyaan dengan kata-kata yang sama. "Sebutkan setiap fakta yang berubah, sebagai lama -> baru" sekarang memiliki lama dan baru untuk dirujuk.
Berikut contoh botol sebelum dan sesudah:
Bandingkan
Permintaan yang sama, sebelum dan sesudah
Sebelum
What changed?

Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.

Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
Sesudah
Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
</document_content>
</document>
</documents>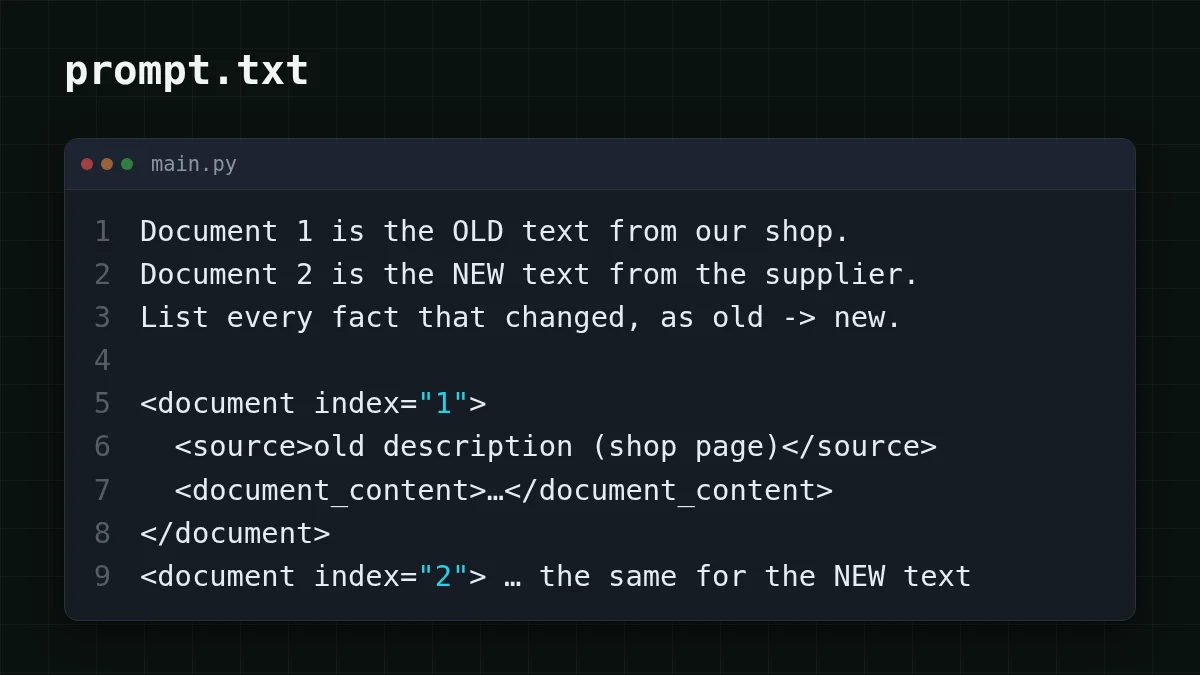
Label memakan beberapa token dan menghilangkan tebakan. Anthropic menulis saran ini untuk model Claude mereka, tetapi label adalah teks biasa, jadi tidak ada yang menghalangi Anda mengirim tata letak yang sama ke model chat lain.
Kirim sebagai permintaan nyata#
Berikut prompt "sesudah" sebagai panggilan API. Alamatnya adalah https:/, API-nya kompatibel dengan OpenAI, dan modelnya adalah deepseek-. Ambil id model dari dokumentasi CheapTokens: nama berbeda antar penyedia. DeepSeek-V4-Flash memiliki jendela konteks 380K dan hingga 32.768 token output per jawaban, yang menyisakan ruang untuk banyak teks panjang. Kunci berasal dari variabel lingkungan, tidak pernah dari kode.
Permintaan yang sama di dua alat
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

old = "Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe."
new = "Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only."

prompt = f"""Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
{old}
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
{new}
</document_content>
</document>
</documents>"""

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": prompt}],
    max_tokens=300,
)
print(response.choices[0].message.content)
print(response.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 300,
    "messages": [{
      "role": "user",
      "content": "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.\n\n<documents>\n<document index=\"1\">\n<source>old description (current shop page)</source>\n<document_content>\nSteel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.\n</document_content>\n</document>\n<document index=\"2\">\n<source>new description (from the supplier)</source>\n<document_content>\nSteel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.\n</document_content>\n</document>\n</documents>"
    }]
  }'
Balasannya adalah teks biasa di choices[0]., dan usage di sebelahnya menghitung token. Jawaban yang baik mencantumkan tiga perubahan: 500 ml -> 750 ml, 12 jam -> 24 jam, aman untuk mesin pencuci piring -> hanya cuci tangan. Jika panahnya terbalik, model kehilangan jejak label. Periksa bahwa instruksi menyebut dokumen dengan nama yang sama seperti yang digunakan tag.
Berapa biaya label#
Tag adalah teks, dan teks ditagih. Katakanlah seorang team lead memasukkan tiga catatan rapat masing-masing sekitar 2.000 token dan bertanya keputusan mana yang bertentangan. Tiga catatan: 3 × 2.000 = 6.000 token. Tambahkan sekitar 150 token untuk instruksi dan tag (asumsi) dan permintaan membawa 6.150 token masuk, dengan jawaban 300 token keluar. Pada DeepSeek-V4-Flash, satu permintaan itu berbiaya $0.00012, dan tag itu sendiri adalah kesalahan pembulatan dibandingkan catatan. Berikut permintaan yang sama dikirim 1.000 kali, dengan OpenRouter di sampingnya:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.135 | $0.231 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00012 | $0.122 | $0.473 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00035 | $0.353 | $4.23 |
6.150 token input dan 300 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Semua 6.150 token masuk ke jendela 380K dengan sisa ruang (apa itu jendela konteks). Dihitung secara total, input dan output bersama, permintaan menjadi lebih murah daripada OpenRouter. Input dan output ditagih dengan tarif berbeda, dan token input vs output menjelaskan mengapa. Angka terkini untuk setiap model ada di halaman harga.
Kebiasaan untuk tumpukan teks yang lebih besar#
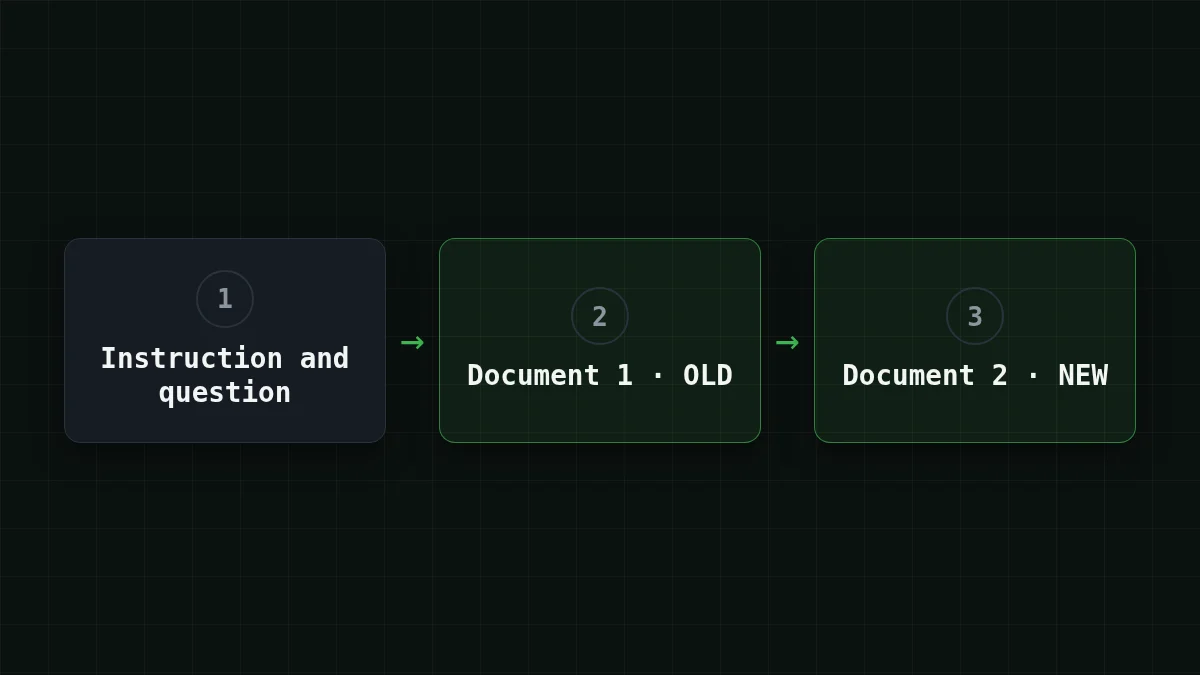
Setelah ada lebih dari dua teks, angka saja tidak cukup: masing-masing membutuhkan namanya sendiri. Gambar di bawah menunjukkan tata letak dari contoh: instruksi dengan pertanyaan terlebih dahulu, lalu setiap dokumen dalam tag-nya sendiri.
- Beri nama berdasarkan konten, bukan hanya angka.
<source>contract v2, sent by the client</lebih baik daripadasource> document 2ketika jawaban mengutipnya kembali kepada Anda. - Letakkan instruksi Anda di luar tag, agar baris di dalam teks yang ditempel tidak dianggap perintah.
- Satu teks, satu tag. File panjang tetap satu tag; dua file berarti dua tag.
- Gunakan kembali nama-nama dalam pertanyaan: "keputusan mana di monday-notes yang bertentangan dengan wednesday-notes?"
- Beri peran pada contoh juga. "Dokumen 1 adalah contoh gaya: tiru nadanya, bukan faktanya. Dokumen 2 adalah draf yang harus ditulis ulang."
Coba sendiriCoba: Anda memiliki log error dan kode yang menghasilkannya dalam satu prompt. Apa yang Anda tambahkan ke masing-masing?Tampilkan jawaban
Nama dan tugas. Untuk log: <source>error log from the last run</ plus "ini adalah gejalanya, jangan edit". Untuk kode: <source>app. plus "ini yang harus diperbaiki". Lalu minta perbaikan dengan nama-nama itu.
Untuk dasar-dasar sisa prompt (tujuan, konteks, format), lihat cara menulis prompt yang baik.


