AI для новичковИнструкция
Подпишите каждый документ в промпте, чтобы модель их не путала
Как дать каждому вставленному тексту имя и роль: промпт «было → стало» и рабочий chat completion запрос на Python и curl.
Содержание
Вы вставили в одно сообщение два текста и попросили модель их сравнить. Если не сказали, какой из них какой, ей придётся гадать. Лечится просто: дайте каждому тексту имя и роль и оберните его в отдельный тег. Руководство Anthropic по промптам (живая страница, сверено 31 октября 2026) советует именно это: размечать тегами каждый тип содержимого, чтобы модель не путала, где инструкция, где фон, а где то, что нужно обработать. Ниже — промпт «было → стало» и рабочий chat completion запрос к API CheapTokens.
Что ломается, когда просто вставляешь тексты#
Возьмём самый простой случай. Поставщик прислал новое описание товара, и вы хотите понять, что изменилось по сравнению с текстом на странице магазина. Вы вставляете оба под вопросом «Что изменилось?» и отправляете. Вам порядок очевиден. Для модели это два куска текста без какой-либо границы, а в вопросе не сказано, какой из них старый. Она может угадать. А может принять новый текст за старый и уверенным тоном выдать список изменений наоборот.
Та же ловушка сидит в обычных задачах:
- две версии договора, и вы спрашиваете, что поменяла другая сторона;
- три протокола встреч, и вы спрашиваете, какие решения противоречат друг другу;
- образец стиля и черновик: что копировать, а что переписывать?
- лог ошибки, вставленный вместе с кодом, и вопрос «почини».
Везде модели нужно по две вещи на каждый текст: имя (что это и откуда) и роль (что с ним сделать).
Дайте каждому тексту имя и задачу#
Три небольших шага:
- Положите каждый текст в свой тег. Руководство Anthropic предлагает обёртку
<documents>и по одному<document index="1">на текст; внутри —<source>для имени и<document_для самого текста.content> - Скажите в инструкции, вне тегов, что есть что: «Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier.»
- Задайте вопрос теми же словами. У просьбы «List every fact that changed, as old -> new» теперь есть и старое, и новое, на что опереться.
Пример с бутылкой, было и стало:
Сравнение
Один и тот же запрос: было и стало
Before
What changed?

Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.

Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
After
Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
</document_content>
</document>
</documents>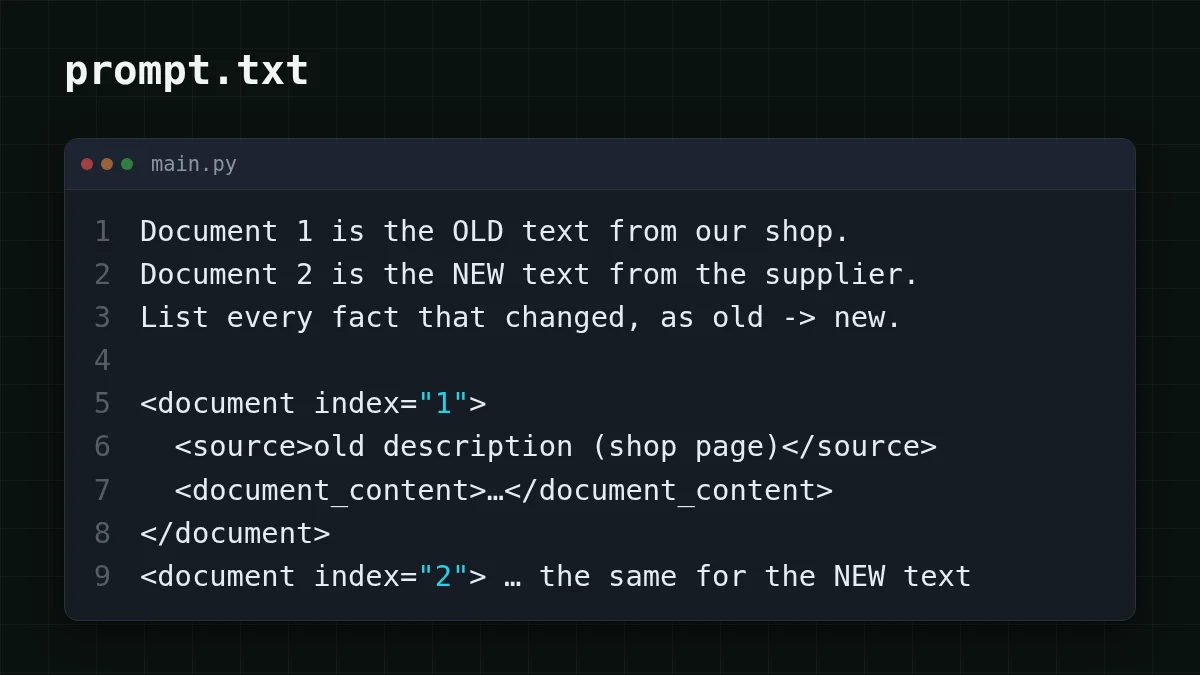
Метки стоят нескольких токенов и убирают гадание. Anthropic писала этот совет для своих моделей Claude, но метки — обычный текст, так что ничто не мешает отправить такую же раскладку другой чат-модели.
Отправьте это настоящим запросом#
Вот промпт «после» как вызов API. Адрес — https:/, API совместим с OpenAI, модель — deepseek-. Id моделей берите из документации CheapTokens: у разных провайдеров названия отличаются. У DeepSeek-V4-Flash окно контекста 380K и до 32 768 токенов в ответе, так что для стопки длинных текстов места хватает. Ключ берётся из переменной окружения, а не из кода.
Один запрос в двух инструментах
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

old = "Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe."
new = "Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only."

prompt = f"""Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
{old}
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
{new}
</document_content>
</document>
</documents>"""

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": prompt}],
    max_tokens=300,
)
print(response.choices[0].message.content)
print(response.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 300,
    "messages": [{
      "role": "user",
      "content": "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.\n\n<documents>\n<document index=\"1\">\n<source>old description (current shop page)</source>\n<document_content>\nSteel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.\n</document_content>\n</document>\n<document index=\"2\">\n<source>new description (from the supplier)</source>\n<document_content>\nSteel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.\n</document_content>\n</document>\n</documents>"
    }]
  }'
Ответ приходит обычным текстом в choices[0]., а рядом в usage — счётчик токенов. Хороший ответ перечисляет три изменения: 500 ml -> 750 ml, 12 hours -> 24 hours, dishwasher safe -> hand wash only. Если стрелки смотрят в другую сторону, модель потеряла метки. Проверьте, что в инструкции документы названы так же, как в тегах.
Сколько стоят метки#
Теги — это текст, а текст тарифицируется. Допустим, руководитель команды загружает три протокола встреч примерно по 2 000 токенов и спрашивает, какие решения конфликтуют. Три протокола: 3 × 2 000 = 6 000 токенов. Добавим около 150 токенов на инструкцию и теги (допущение) — получится запрос на 6 150 токенов на входе и ответ в 300 токенов. На DeepSeek-V4-Flash такой запрос стоит $0.00012, а сами теги на фоне протоколов — погрешность. Вот тот же запрос, отправленный 1 000 раз, рядом с OpenRouter:
| Модель | Вход $/1M | Выход $/1M | За запрос | 1 000 запросов | OpenRouter, 1 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.135 | $0.231 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00012 | $0.122 | $0.473 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00035 | $0.353 | $4.23 |
6 150 входных и 300 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Все 6 150 токенов спокойно помещаются в окно 380K (что такое окно контекста). В сумме, с учётом входа и выхода, запрос выходит дешевле, чем на OpenRouter. Вход и выход тарифицируются по разным ставкам; почему, объясняет статья входные и выходные токены. Актуальные цены по всем моделям — на странице цен.
Привычки для больших стопок текста#
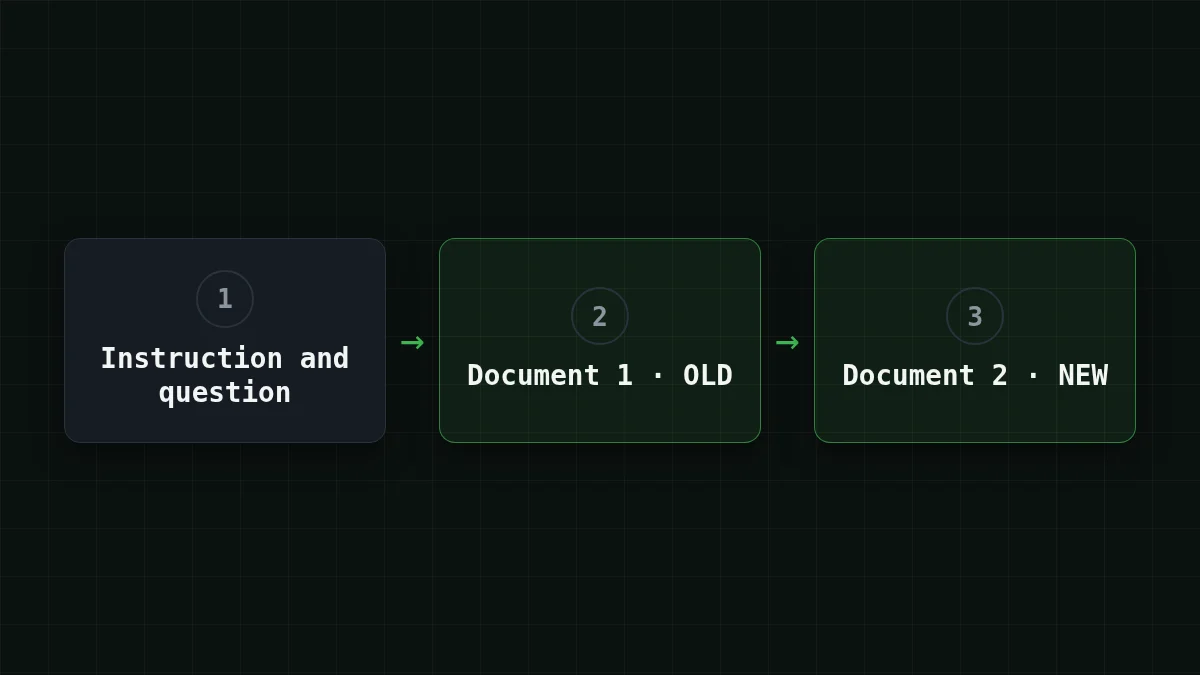
Когда текстов больше двух, одних номеров мало: у каждого должно быть своё имя. Схема ниже показывает раскладку из примера: сначала инструкция с вопросом, затем каждый документ в своём теге.
- Называйте по содержанию, а не только по номеру.
<source>contract v2, sent by the client</лучше, чемsource> document 2, когда ответ цитирует документ. - Держите инструкцию вне тегов, чтобы строка внутри вставленного текста не сошла за приказ.
- Один текст — один тег. Длинный файл — всё равно один тег, два файла — два.
- Повторяйте имена в вопросе: «which decisions in monday-notes contradict wednesday-notes?»
- Раздавайте роли и примерам. «Document 1 is a style sample: copy its tone, not its facts. Document 2 is the draft to rewrite.»
Попробуйте самиПопробуйте: в одном промпте лог ошибки и код, который её дал. Что добавить к каждому?Показать ответ
Имя и задачу. Для лога: <source>error log from the last run</ и пометку «это симптом, не правь его». Для кода: <source>app. и «вот что чинить». А потом просите исправление, называя их по этим именам.
Остальные части промпта (цель, контекст, формат) разобраны в статье как написать хороший промпт.


