Rotule cada documento em um prompt para o modelo não confundi-los
Como dar a cada texto colado um nome e uma função, com um prompt de antes/depois e uma requisição de chat completion funcional em Python e curl.
Nesta página
Você colou dois textos em uma única mensagem e pediu ao modelo que os comparasse. A menos que você tenha dito qual é qual, ele precisa adivinhar. A correção é pequena: dê um nome e uma função a cada texto, e envolva cada um em sua própria tag. O guia de prompting da Anthropic (uma página viva, verificada em 31 de outubro de 2026) recomenda marcar cada tipo de conteúdo com tags para que o modelo não interprete errado o que é instrução, o que é contexto e o que é entrada. Abaixo há um prompt de antes/depois e uma requisição de chat completion funcional que você pode enviar para a CheapTokens API.
O que dá errado quando você apenas cola#
Pegue o caso mais simples. Um fornecedor envia uma nova descrição de produto, e você quer saber o que mudou em relação à que está na página da sua loja. Você cola as duas sob "O que mudou?" e aperta enviar. Para você a ordem é óbvia. Para o modelo são dois blocos de texto sem nada entre eles, e a pergunta nunca diz qual é o antigo. Ele pode acertar. Também pode chamar o texto novo de antigo e te entregar uma lista de mudanças ao contrário, com uma voz perfeitamente confiante.
A mesma armadilha se esconde em tarefas do dia a dia:
- duas versões de um contrato, e você pergunta o que o outro lado mudou;
- três notas de reunião, e você pergunta quais decisões se contradizem;
- uma amostra de estilo mais um rascunho: qual imitar, qual reescrever?
- um log de erro colado junto com o código, e a pergunta é "corrija isso".
Em cada um deles o modelo precisa de duas coisas por texto: um nome (o que é e de onde veio) e uma função (o que você quer fazer com ele).
Dê a cada texto um nome e uma função#
Três movimentos pequenos:
- Coloque cada texto em sua própria tag. O guia da Anthropic sugere um invólucro
<documents>com um<document index="1">por texto, e dentro dele um<source>para o nome e<document_para o texto em si.content> - Diga o que cada um é na instrução, fora das tags: "Documento 1 é o texto ANTIGO da nossa loja. Documento 2 é o texto NOVO do fornecedor."
- Faça a pergunta com as mesmas palavras. "Liste todo fato que mudou, como antigo -> novo" agora tem um antigo e um novo para apontar.
Aqui está o exemplo da garrafa antes e depois:
Comparar
Mesma requisição, antes e depois
Antes
What changed?

Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.

Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
Depois
Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.
</document_content>
</document>
</documents>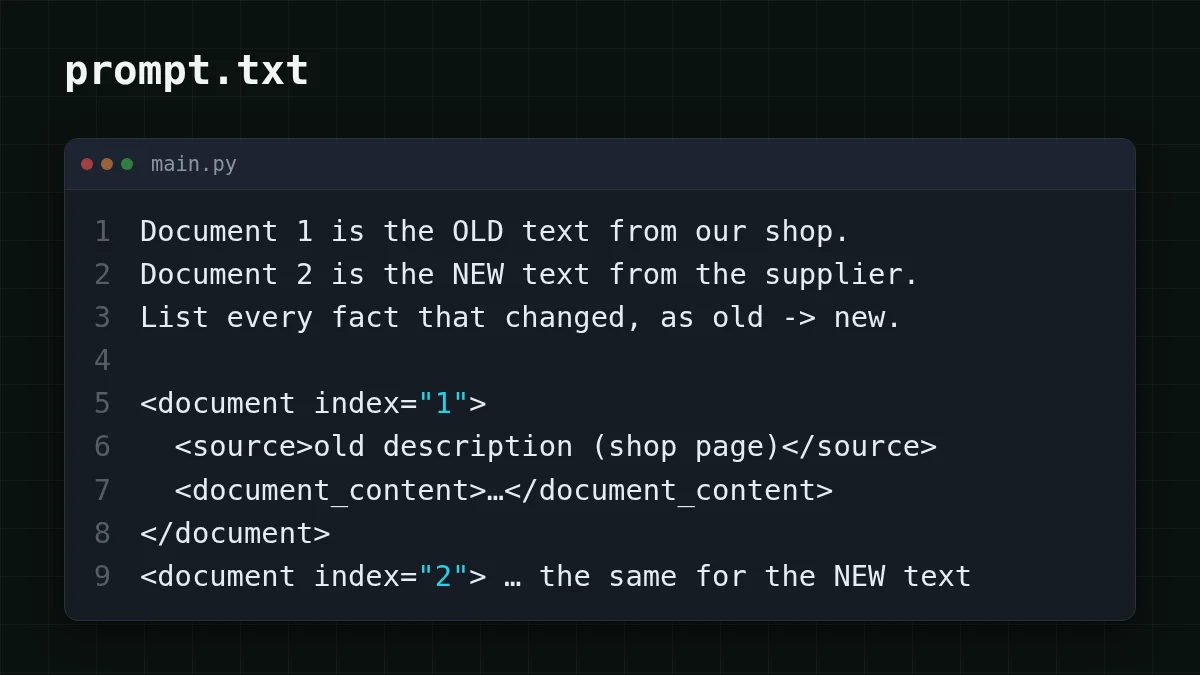
Os rótulos custam alguns tokens e eliminam a adivinhação. A Anthropic escreveu esse conselho para seus modelos Claude, mas os rótulos são texto puro, então nada impede você de enviar o mesmo layout para outro modelo de chat.
Envie como uma requisição real#
Aqui está o prompt "depois" como uma chamada de API. O endereço é https:/, a API é compatível com OpenAI, e o modelo é deepseek-. Pegue os ids de modelo na documentação da CheapTokens: os nomes variam entre provedores. O DeepSeek-V4-Flash tem uma janela de contexto de 380K e até 32.768 tokens de saída por resposta, o que deixa espaço para um monte de textos longos. A chave vem de uma variável de ambiente, nunca do código.
A mesma requisição em duas ferramentas
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

old = "Steel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe."
new = "Steel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only."

prompt = f"""Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.

<documents>
<document index="1">
<source>old description (current shop page)</source>
<document_content>
{old}
</document_content>
</document>
<document index="2">
<source>new description (from the supplier)</source>
<document_content>
{new}
</document_content>
</document>
</documents>"""

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": prompt}],
    max_tokens=300,
)
print(response.choices[0].message.content)
print(response.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 300,
    "messages": [{
      "role": "user",
      "content": "Document 1 is the OLD text from our shop. Document 2 is the NEW text from the supplier. List every fact that changed, one per line, as old -> new.\n\n<documents>\n<document index=\"1\">\n<source>old description (current shop page)</source>\n<document_content>\nSteel water bottle, 500 ml. Keeps drinks cold for 12 hours. Dishwasher safe.\n</document_content>\n</document>\n<document index=\"2\">\n<source>new description (from the supplier)</source>\n<document_content>\nSteel water bottle, 750 ml. Keeps drinks cold for 24 hours. Hand wash only.\n</document_content>\n</document>\n</documents>"
    }]
  }'
A resposta é texto puro em choices[0]., e usage ao lado conta os tokens. Uma boa resposta lista três mudanças: 500 ml -> 750 ml, 12 horas -> 24 horas, pode ir à lava-louças -> lavar somente à mão. Se as setas correrem ao contrário, o modelo perdeu o rastro dos rótulos. Verifique se a instrução chama os documentos pelo mesmo nome que as tags usam.
Quanto custam os rótulos#
Tags são texto, e texto é cobrado. Digamos que um líder de equipe insira três notas de reunião de cerca de 2.000 tokens cada e pergunte quais decisões conflitam. Três notas: 3 × 2.000 = 6.000 tokens. Adicione cerca de 150 tokens para a instrução e as tags (uma suposição) e a requisição carrega 6.150 tokens de entrada, com uma resposta de 300 tokens de saída. No DeepSeek-V4-Flash essa única requisição custa $0.00012, e as tags em si são um erro de arredondamento perto das notas. Aqui está a mesma requisição enviada 1.000 vezes, com o OpenRouter ao lado:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.135 | $0.231 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00012 | $0.122 | $0.473 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00035 | $0.353 | $4.23 |
6.150 tokens de entrada e 300 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Todos os 6.150 tokens cabem na janela de 380K com folga (o que é uma janela de contexto). Contado no total, entrada e saída juntas, a requisição sai mais barata que no OpenRouter. Entrada e saída são cobradas a taxas diferentes, e tokens de entrada vs saída explica por quê. Os números atuais de cada modelo estão na página de preços.
Hábitos para pilhas maiores de texto#
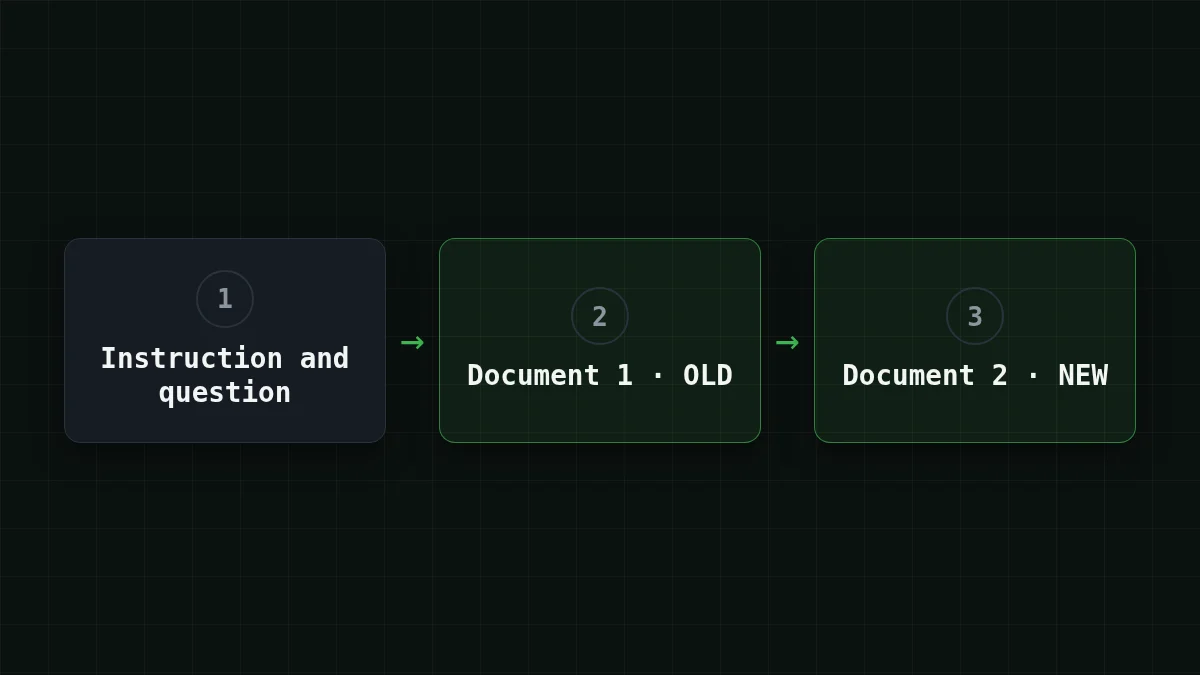
Quando há mais de dois textos, números sozinhos não bastam: cada um precisa do seu próprio nome. A imagem abaixo mostra o layout do exemplo: a instrução com a pergunta primeiro, depois cada documento em sua própria tag.
- Nomeie pelo conteúdo, não só pelo número.
<source>contract v2, sent by the client</é melhor quesource> document 2quando a resposta cita isso de volta para você. - Mantenha sua instrução fora das tags, para que uma linha dentro de um texto colado não seja tomada como uma ordem.
- Um texto, uma tag. Um arquivo longo ainda é uma tag; dois arquivos são duas.
- Reutilize os nomes na pergunta: "quais decisões em monday-notes contradizem wednesday-notes?"
- Dê funções aos exemplos também. "Documento 1 é uma amostra de estilo: copie o tom, não os fatos. Documento 2 é o rascunho a reescrever."
Experimente você mesmoExperimente: você tem um log de erro e o código que o produziu em um único prompt. O que você adiciona a cada um?Mostrar resposta
Um nome e uma função. Para o log: <source>error log from the last run</ mais "este é o sintoma, não edite". Para o código: <source>app. mais "isto é o que corrigir". Depois peça a correção por esses nomes.
Para o básico do resto do prompt (objetivo, contexto, formato), veja como escrever um bom prompt.


