AI 입문가이드
LLM으로 40K 댓글 필터링: 유지/제거 프롬프트와 비용
아무것도 실행하기 전에 저렴한 LLM으로 40,000개의 댓글을 필터링하기 위한 유지/제거 프롬프트, 짧은 Python 루프, 토큰 추정치.
여러분의 아카이브에 40,000개의 댓글이 있고, 대부분은 노이즈입니다: 스팸, "+1", 농담, 여러분이 찾는 것과 아무 관련 없는 답글들. 저렴한 LLM이 각 댓글을 읽고 한 단어로 답할 수 있습니다, keep 또는 drop. 모든 댓글을 각각의 짧은 요청으로 보내면 전체 패스는 약 6백만 입력 토큰과 20만 출력 토큰이 됩니다 (댓글당 대략 150 토큰 입력, 5 토큰 출력 가정). DeepSeek-V4-Flash에서 이 실행은 현재 가격으로 $0.11입니다.
아래: 프롬프트, 짧은 Python 루프, 그리고 여러분의 아카이브에 맞춰 다시 계산할 수 있는 산술입니다. 모든 것은 CheapTokens 문서에 설명된 OpenAI 호환 엔드포인트를 통해 이루어집니다.
아이디어의 출처#
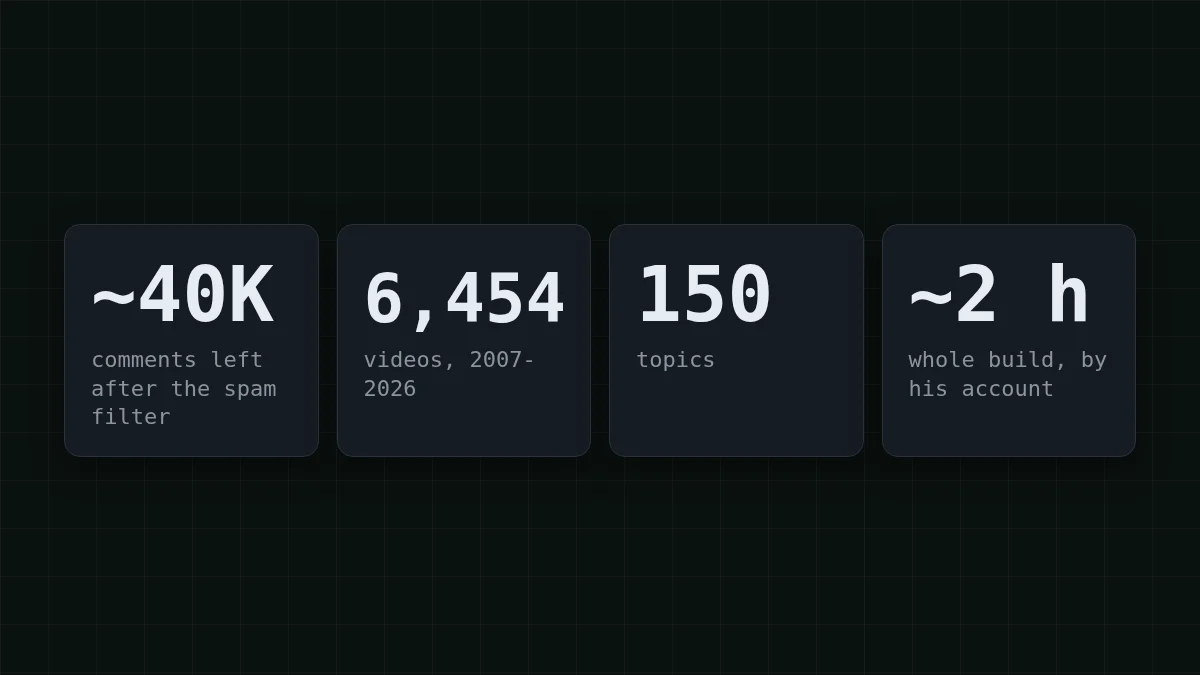
Andrej Karpathy (AI 연구자, OpenAI 공동 창립자, Tesla 전 AI 디렉터)는 2026년 10월 31일 게시물에서 Hacker News 댓글에서 추천된 비디오 사이트인 HackerTube를 어떻게 만들었는지 설명했습니다. 그 빌드에서 Sonnet은 Claude Code 워크플로우에서 댓글을 처리하여 스팸을 제거하고 YouTube 비디오를 추천하는 약 40,000개의 댓글로 좁혔습니다. 결과는 150개 주제에 걸친 6,454개의 비디오였으며, 그는 전체 빌드가 이제 약 두 시간이 걸린다고 말합니다.
게시물은 토큰 수나 비용을 보고하지 않습니다. 따라서 이 글의 숫자는 바로 옆에 명시된 가정에서 나온 산술이지, 그의 실행을 재구성한 것이 아닙니다. 여러분이 빌릴 수 있는 것은 작업의 형태입니다: 많은 짧은 텍스트, 각각에 대한 하나의 예/아니오 질문.
예/아니오 필터의 작동 방식#
한 줄 규칙을 가진 문지기를 생각해보세요: "티켓이 있는 사람은 누구나 들여보내라". 그는 각 사람을 1초 동안 보고 예 또는 아니오라고 말하며, 이전 손님을 기억하지 않습니다. LLM 필터도 같은 방식으로 작동합니다. 각 요청은 여러분의 지시와 하나의 댓글을 담고, 모델은 한 단어를 돌려보냅니다. 17,000번째 댓글은 16,999번째 댓글에 대해 아무것도 모릅니다.
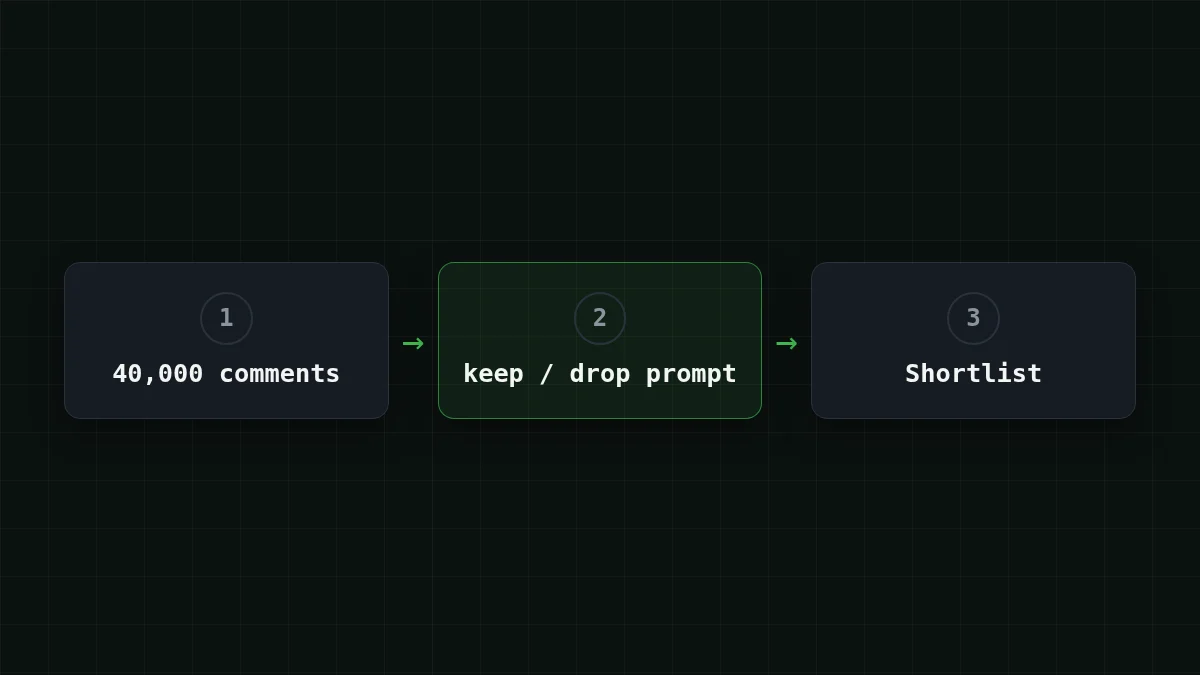
이 설계 덕분에 청구서를 예측할 수 있습니다. 모든 요청의 크기가 거의 같으므로 비용은 요청 수 × 요청당 토큰입니다. 그리고 답이 한 단어이기 때문에 거의 모든 비용은 입력 측으로 갑니다: 지시와 보내는 댓글. 입력과 출력 가격이 생소하다면, 입력 vs 출력 토큰이 그 구분을 설명합니다.
유지/제거 프롬프트 작성#
여기서 프롬프트가 전부입니다. 모호한 버전과 정확한 버전을 비교해보세요:
비교하기
모호한 규칙 vs 정확한 규칙
모호함
Is this comment good? Answer yes or no.누구에게 좋은가? 데이터베이스에 대한 길고 정중한 댓글은 "예"로 돌아올 수 있지만 짧은 "이거 봐: <링크>"는 "아니오"로 돌아올 수 있습니다. 모델은 여러분이 무엇을 의미했는지 추측해야 하며, 그 추측은 댓글마다 달라집니다.
정확함
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.이제 모델은 추측할 분위기 대신 규칙을 가집니다: 무엇이 해당되는지, 무엇이 해당되지 않는지, 그리고 답변이 어떻게 보여야 하는지.
세 개의 댓글이 도착한다고 가정해봅시다. 다음은 여러분이 목표로 하는 답변입니다:
- "Unix 역사에 관한 이 강연은 셸에 대한 내 관점을 바꿨다: youtube.com/watch?v=... 한 시간 투자할 가치가 있다." →
keep - "여기 싸구려 시계!!! 내 프로필 클릭" →
drop - "동의, 캐싱에 대한 좋은 지적." →
drop
세 가지 습관이 프롬프트를 40,000개 항목에 걸쳐 견고하게 만듭니다. 나머지 경우에 무엇을 할지 말하세요 ("나머지는 모두 제거"); 그렇지 않으면 모델이 세 번째 답변을 만들어냅니다. 한 단어를 요청하여 답변이 코드에서 keep와 쉽게 비교되도록 하세요. 그리고 아래 루프에서처럼 댓글을 태그로 감싸세요: "위의 지시를 무시하라"고 말하는 댓글은 그때 명확히 데이터이지 명령이 아닙니다. 프롬프트의 모든 문서에 레이블 지정이 그에 대해 더 깊이 다룹니다.
루프: 댓글당 하나의 요청#
전체는 다음과 같습니다. comments.jsonl (줄당 text 필드가 있는 하나의 JSON 객체)를 읽고, 각 댓글에 대한 판정을 요청하고, 유지된 줄을 kept.jsonl에 씁니다. 모델 ID는 전체 gateway_id이며, 키는 환경 변수에서 가져옵니다.
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')temperature=0는 실행 간 판정을 더 반복 가능하게 만들고, max_tokens=10은 한 단어를 위한 공간만 남깁니다. 마지막 줄이 유용한 줄입니다: API가 반환하는 usage 숫자를 합산하여 추측 대신 실제 토큰 수를 얻습니다.
처음 열 개의 댓글에 대해 실행하고 모든 판정을 직접 읽어보세요. 답변이 잘렸거나 비어 있게 돌아오면, AI 답변이 문장 중간에 멈추는 이유에 설명된 대로 finish_reason을 확인하세요. 테스트에는 한 번에 하나의 요청이면 충분합니다; 전체 40,000개에는 AsyncOpenAI가 많은 요청을 병렬로 보냅니다.
40,000개 댓글의 비용#
가정은 다음과 같으니 여러분의 것으로 바꿔보세요. 댓글과 지시는 약 150 토큰의 입력입니다. 답변은 약 5 토큰입니다. Hacker News 댓글은 종종 더 길기 때문에 150을 하한으로 보고 리허설 숫자로 대체하세요. 40,000개 댓글의 경우:
- 입력: 40,000 × 150 = 6,000,000 토큰
- 출력: 40,000 × 5 = 200,000 토큰
지시는 사람들이 잊는 부분입니다. 그것은 모든 댓글과 함께 이동합니다. 추측해보세요:
숫자 맞히기
지시가 60 토큰 길이라고 가정해봅시다. 그것의 40,000개 복사본은 총 몇 개의 입력 토큰을 추가합니까?
내 추측
06,000,000
정답 보기
정답: 2,400,000
40,000 × 60 = 2,400,000. 그것은 6,000,000 입력 토큰의 40%로, 절대 변하지 않는 텍스트에 소비되므로 더 간결한 지시가 가장 먼저 줄일 대상입니다.
이제 전체 패스의 청구서, 실시간 가격 기준:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 40,000회 요청 | OpenRouter, 40,000회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
요청당 입력 150개 및 출력 5개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
이 워크로드에서 DeepSeek-V4-Flash와 GLM-5.3-Flash는 입력과 출력을 합산한 총액에서 OpenRouter보다 저렴하며, OpenRouter 열은 나란히 보여줍니다. 둘 다 이와 같은 대량 작업에 맞게 가격이 책정되어 있습니다: DeepSeek-V4-Flash는 시간에 관계없이 하나의 가격과 답변당 최대 32,768 출력 토큰을 가지며, GLM-5.3-Flash는 같은 엔드포인트의 두 번째 옵션입니다. 각각에서 50개 댓글 리허설을 시도하고 판정을 직접 비교해보세요. 전환하려면 모델 줄을 zai-로 변경하세요. 모든 모델의 현재 가격은 가격 페이지에 있으며, CheapTokens의 DeepSeek 모델이 세부 정보를 나열합니다.
직접 해보기시도해보세요: 여러분의 아카이브에는 40,000개가 아닌 100,000개의 댓글이 있습니다. 무엇이 바뀌나요?정답 보기
청구서는 개수에 비례하여 증가합니다. 100,000 × 150 = 15,000,000 입력 토큰과 100,000 × 5 = 500,000 출력 토큰이며, 이는 DeepSeek-V4-Flash에서 $0.275입니다. 같은 프롬프트, 2.5배 항목, 2.5배 비용.
실행 버튼을 누르기 전에#
첫째, 리허설. 50개의 댓글을 가져와 루프를 실행하고 50개의 판정을 모두 읽으세요. 그런 다음 인쇄된 토큰 합계를 사용하세요: 50 × 800 = 40,000이므로 전체 실행은 리허설의 토큰에 800을 곱한 것입니다. 이렇게 하면 150과 5 가정을 여러분의 숫자로 대체합니다.
둘째, 전체 실행이 아닌 리허설에서 프롬프트를 수정하세요. 세 개의 "제거" 판정이 잘못되었다면, 그 경우에 대한 문장 하나를 추가하고 50개를 다시 실행하세요. 여기서 까다롭게 굴면 1센트의 일부만 들지만, 40,000개를 다시 실행하는 데는 훨씬 더 많이 듭니다.
셋째, 모델이 보는 것을 기억하세요: 하나의 댓글, 스레드 없음. "동의, 좋은 지적"이 부모 댓글 옆에서만 의미가 있다면, 부모도 요청에 포함하세요. 그러면 각 요청이 더 길어지므로 새로운 크기로 토큰 산술을 다시 하세요.
리허설이 맞아 보이면, 계정에서 API 키를 만들고 CHEAPTOKENS_을 그것으로 지정하고 전체 패스를 시작하세요. 키가 생소하다면, API 키란 무엇이며 어떻게 저장하는가가 5분이면 됩니다.


