LLM से 40K कमेंट्स फ़िल्टर करें: रखें/हटाएँ प्रॉम्प्ट और लागत
कुछ भी चलाने से पहले, एक सस्ते LLM से 40,000 कमेंट्स फ़िल्टर करने के लिए रखें/हटाएँ प्रॉम्प्ट, एक छोटा Python लूप और टोकन अनुमान।
इस पृष्ठ पर
आपके आर्काइव में 40,000 कमेंट्स हैं, और उनमें से ज़्यादातर शोर हैं: स्पैम, "+1", चुटकुले, ऐसे जवाब जिनका आपकी मंशा से कोई लेना-देना नहीं है। एक सस्ता LLM हर एक को पढ़कर एक शब्द में जवाब दे सकता है, keep या drop। हर कमेंट को उसके अलग छोटे अनुरोध के रूप में भेजें और पूरा पास लगभग 6 मिलियन इनपुट टोकन और 200 हज़ार आउटपुट टोकन का हो जाता है (मान लीजिए प्रति कमेंट लगभग 150 टोकन इन और 5 आउट)। DeepSeek-V4-Flash पर वह रन मौजूदा कीमत पर $0.11 का पड़ता है।
नीचे: प्रॉम्प्ट, एक छोटा Python लूप, और वह गणित जिसे आप अपने आर्काइव के लिए दोबारा कर सकते हैं। सब कुछ CheapTokens डॉक्स में वर्णित OpenAI-संगत एंडपॉइंट से होकर जाता है।
यह विचार कहाँ से आया#
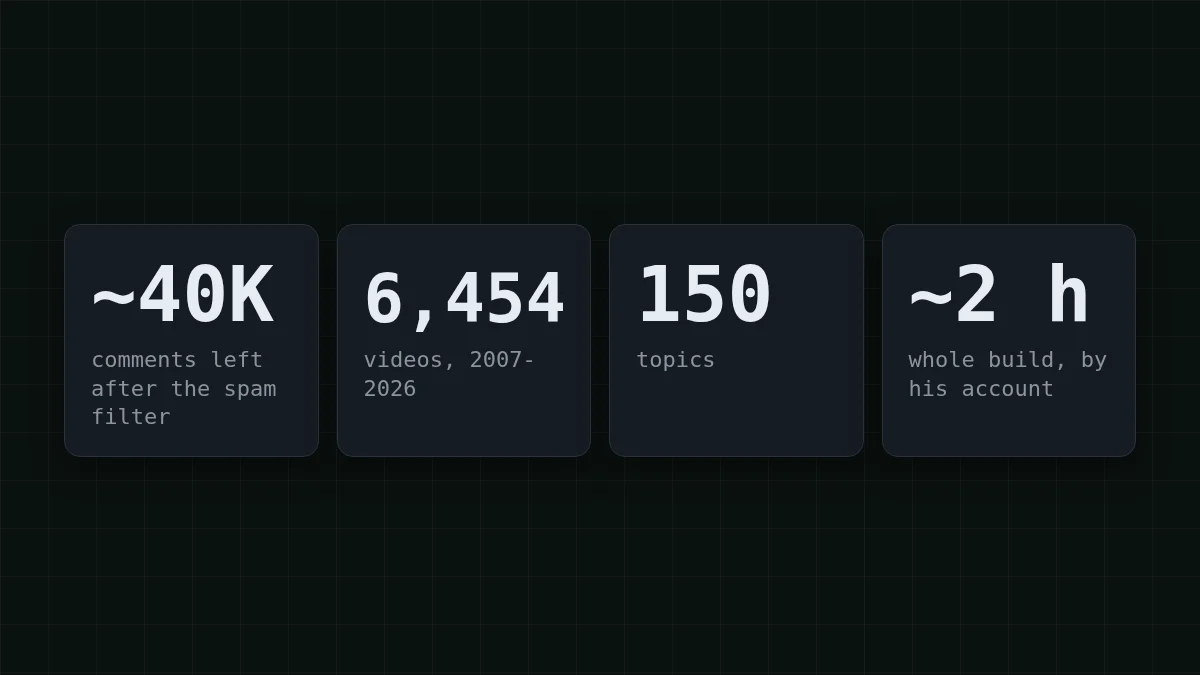
आंद्रेज कारपैथी (AI शोधकर्ता, OpenAI के सह-संस्थापक, टेस्ला में पूर्व AI निदेशक) ने 31 अक्टूबर 2026 की अपनी पोस्ट में बताया कि उन्होंने HackerTube कैसे बनाया, जो Hacker News कमेंट्स में सुझाए गए वीडियो की साइट है। उस बिल्ड में, Sonnet ने Claude Code वर्कफ़्लो में कमेंट्स पर चलकर स्पैम हटाया और उन्हें लगभग 40,000 कमेंट्स तक सीमित किया जो YouTube वीडियो सुझाते हैं। नतीजा 150 विषयों में 6,454 वीडियो था, और वे कहते हैं कि पूरा बिल्ड अब लगभग दो घंटे लेता है।
पोस्ट में टोकन गिनती या लागत नहीं बताई गई है। इसलिए इस लेख के आंकड़े उनके रन का पुनर्निर्माण नहीं, बल्कि ठीक उनके बगल में बताई गई मान्यताओं से निकला गणित हैं। आप जो उधार ले सकते हैं वह काम का स्वरूप है: बहुत सारे छोटे टेक्स्ट, हर एक के बारे में एक हाँ/नहीं प्रश्न।
हाँ/नहीं फ़िल्टर कैसे काम करता है#
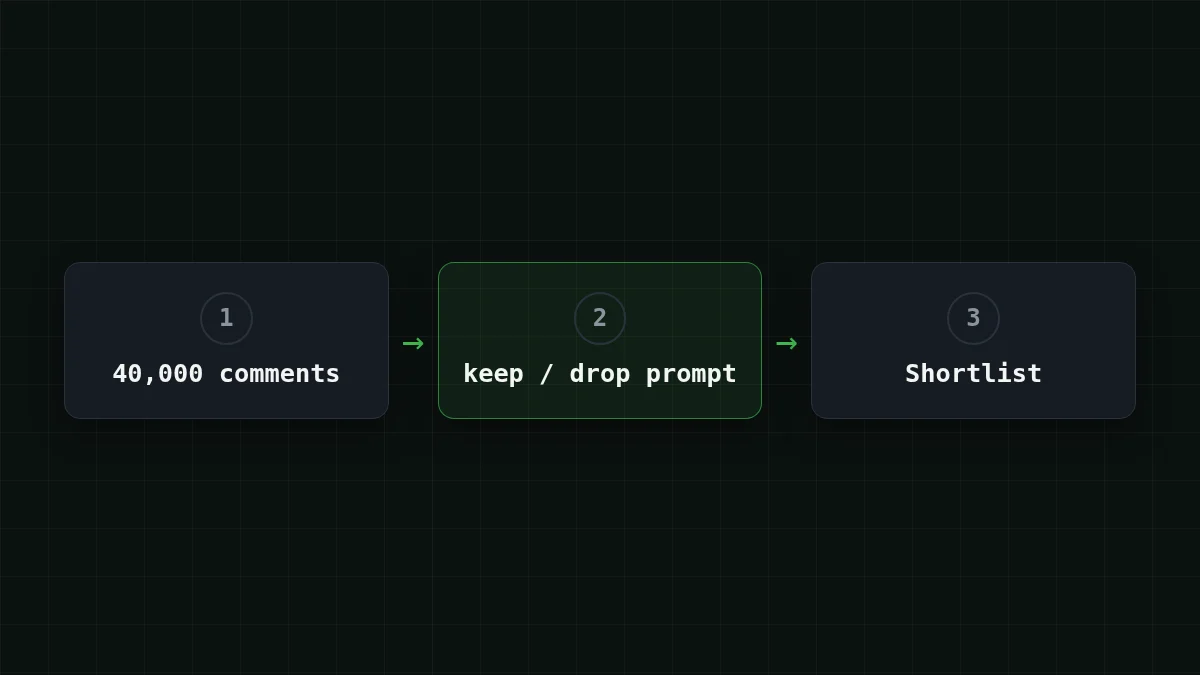
एक दरवाज़ेदार की कल्पना करें जिसके पास एक पंक्ति का नियम है: "टिकट वाले किसी को भी अंदर आने दो"। वह हर व्यक्ति को एक सेकंड देखता है, हाँ या नहीं कहता है, और पिछले मेहमान को कभी याद नहीं रखता। LLM फ़िल्टर भी वैसे ही काम करता है। हर अनुरोध में आपका निर्देश और एक कमेंट होता है, और मॉडल एक शब्द लौटाता है। कमेंट 17,000 को कमेंट 16,999 के बारे में कुछ पता नहीं होता।
इसी डिज़ाइन की वजह से बिल अनुमानित होता है। हर अनुरोध का आकार लगभग एक जैसा होता है, इसलिए लागत = अनुरोध × प्रति अनुरोध टोकन। और चूँकि जवाब एक शब्द है, लगभग सारा पैसा इनपुट पक्ष में जाता है: निर्देश और वह कमेंट जो आप भेजते हैं। अगर इनपुट और आउटपुट प्राइसिंग आपके लिए नई है, तो इनपुट बनाम आउटपुट टोकन इस विभाजन को समझाता है।
रखें/हटाएँ प्रॉम्प्ट लिखें#
यहाँ प्रॉम्प्ट ही पूरा उत्पाद है। एक अस्पष्ट संस्करण की तुलना सटीक संस्करण से करें:
तुलना करें
अस्पष्ट नियम बनाम सटीक नियम
अस्पष्ट
Is this comment good? Answer yes or no.किसके लिए अच्छा? डेटाबेस के बारे में एक लंबा, विनम्र कमेंट "हाँ" लौटा सकता है जबकि एक छोटा "यह देखें: <लिंक>" "नहीं" लौटा सकता है। मॉडल को अनुमान लगाना पड़ता है कि आपका मतलब क्या था, और उसका अनुमान हर कमेंट पर बदलता रहता है।
सटीक
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.अब मॉडल के पास अनुमान लगाने के लिए मूड नहीं, बल्कि एक नियम है: क्या गिना जाता है, क्या नहीं, और जवाब कैसा दिखता है।
मान लें तीन कमेंट आते हैं। ये वे जवाब हैं जिनका आप लक्ष्य कर रहे हैं:
- "यूनिक्स के इतिहास पर यह टॉक ने शेल्स के बारे में मेरा नज़रिया बदल दिया: youtube.com/watch?v=... घंटे भर के लायक है।" →
keep - "यहाँ सस्ती घड़ियाँ!!! मेरी प्रोफ़ाइल पर क्लिक करें" →
drop - "सहमत, कैशिंग पर अच्छी बात।" →
drop
तीन आदतें प्रॉम्प्ट को 40,000 आइटम्स पर टिकाऊ बनाती हैं। बचे हुए मामलों के साथ क्या करना है बताएं ("बाकी सब हटाएँ"); वरना मॉडल एक तीसरा जवाब गढ़ लेता है। एक शब्द माँगें, ताकि जवाब को कोड में keep से तुलना करना आसान हो। और कमेंट को टैग में लपेटें, जैसा नीचे लूप में है: तब "ऊपर के निर्देशों को अनदेखा करें" कहने वाला कमेंट स्पष्ट रूप से डेटा है, आदेश नहीं। प्रॉम्प्ट में हर दस्तावेज़ को लेबल करें इस पर और गहराई से बताता है।
लूप: प्रति कमेंट एक अनुरोध#
यहाँ पूरी बात है। यह comments.jsonl पढ़ता है (प्रति पंक्ति एक text फ़ील्ड वाला एक JSON ऑब्जेक्ट), हर कमेंट पर फ़ैसला माँगता है, और रखी गई पंक्तियों को kept.jsonl में लिखता है। मॉडल आईडी पूरा gateway_id है; कुंजी एक एनवायरनमेंट वेरिएबल से आती है।
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 फ़ैसलों को रनों के बीच अधिक दोहराने योग्य बनाता है, और max_tokens=10 एक शब्द के लिए जगह छोड़ता है और उससे ज़्यादा नहीं। आखिरी पंक्ति उपयोगी है: यह API द्वारा लौटाए गए usage संख्याओं को जोड़ती है, ताकि आपको अनुमान के बजाय अपनी असली टोकन गिनती मिले।
पहले दस कमेंट्स पर इसे चलाएँ और हर फ़ैसला खुद पढ़ें। अगर कोई जवाब कटा हुआ लगे या खाली आए, तो finish_reason जाँचें जैसा AI का जवाब वाक्य के बीच में क्यों रुक जाता है में बताया गया है। परीक्षण के लिए एक बार में एक अनुरोध ठीक है; पूरे 40,000 के लिए, AsyncOpenAI कई अनुरोध समानांतर भेजता है।
40,000 कमेंट्स की लागत#
यहाँ मान्यताएँ हैं, ताकि आप अपनी डाल सकें। एक कमेंट और निर्देश मिलाकर लगभग 150 टोकन इनपुट है। जवाब लगभग 5 टोकन है। Hacker News कमेंट्स अक्सर लंबे होते हैं, इसलिए 150 को न्यूनतम मानें और इसे रिहर्सल के आंकड़ों से बदलें। 40,000 कमेंट्स के लिए:
- इनपुट: 40,000 × 150 = 6,000,000 टोकन
- आउटपुट: 40,000 × 5 = 200,000 टोकन
निर्देश वह हिस्सा है जिसे लोग भूल जाते हैं। यह हर एक कमेंट के साथ जाता है। एक अनुमान लगाएँ:
संख्या का अनुमान लगाएँ
मान लें आपका निर्देश 60 टोकन लंबा है। इसकी 40,000 प्रतियाँ कुल कितने इनपुट टोकन जोड़ती हैं?
आपका अनुमान
060,00,000
उत्तर दिखाएँ
उत्तर: 24,00,000
40,000 × 60 = 2,400,000। यह 6,000,000 इनपुट टोकन का 40% है, जो ऐसे टेक्स्ट पर खर्च होता है जो कभी नहीं बदलता, इसलिए छोटा निर्देश सबसे पहले घटाने वाली चीज़ है।
अब पूरे पास का बिल, लाइव कीमतों पर:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 40,000 अनुरोध | OpenRouter, 40,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
प्रति अनुरोध 150 इनपुट और 5 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
इस वर्कलोड पर, DeepSeek-V4-Flash और GLM-5.3-Flash दोनों कुल मिलाकर OpenRouter से सस्ते पड़ते हैं, इनपुट और आउटपुट को एक साथ गिनकर; OpenRouter कॉलम इसे साथ-साथ दिखाता है। दोनों इस जैसे उच्च-मात्रा वाले काम के लिए कीमत पर हैं: DeepSeek-V4-Flash की किसी भी घंटे एक ही कीमत है और प्रति जवाब 32,768 आउटपुट टोकन तक, GLM-5.3-Flash उसी एंडपॉइंट पर दूसरा विकल्प है। अपना 50-कमेंट रिहर्सल दोनों पर चलाएँ और फ़ैसलों की खुद तुलना करें। बदलने के लिए, मॉडल लाइन को zai- में बदलें। हर मॉडल की मौजूदा कीमतें प्राइसिंग पेज पर हैं, और CheapTokens पर DeepSeek मॉडल विवरण सूचीबद्ध करता है।
स्वयं आज़माएँइसे आज़माएँ: आपके आर्काइव में 40,000 नहीं, 100,000 कमेंट्स हैं। क्या बदलता है?उत्तर दिखाएँ
बिल गिनती के साथ बढ़ता है। 100,000 × 150 = 15,000,000 इनपुट टोकन और 100,000 × 5 = 500,000 आउटपुट टोकन, जो DeepSeek-V4-Flash पर $0.275 है। वही प्रॉम्प्ट, 2.5 गुना आइटम, 2.5 गुना लागत।
रन दबाने से पहले#
पहले, एक रिहर्सल। 50 कमेंट लें, लूप चलाएँ, और सभी 50 फ़ैसले पढ़ें। फिर प्रिंट किए गए टोकन योग का उपयोग करें: 50 × 800 = 40,000, इसलिए पूरा रन रिहर्सल के टोकन का 800 गुना है। यह 150-और-5 की मान्यता को आपके अपने आंकड़ों से बदल देता है।
दूसरा, प्रॉम्प्ट को रिहर्सल पर ठीक करें, पूरे रन पर नहीं। अगर तीन "हटाएँ" फ़ैसले गलत हैं, तो उस मामले के बारे में एक वाक्य जोड़ें और 50 दोबारा चलाएँ। यहाँ नखरा करने में एक पैसे का अंश लगता है, और 40,000 दोबारा चलाने में बहुत ज़्यादा।
तीसरा, याद रखें कि मॉडल क्या देखता है: एक कमेंट, कोई थ्रेड नहीं। अगर "सहमत, अच्छी बात" केवल पैरेंट कमेंट के साथ ही अर्थपूर्ण है, तो पैरेंट को भी अनुरोध में डालें। इससे हर अनुरोध लंबा हो जाता है, इसलिए नए आकार के साथ टोकन गणित दोबारा करें।
जब रिहर्सल सही लगे, तो अपने खाते में एक API कुंजी बनाएँ, CHEAPTOKENS_ को उस पर इंगित करें और पूरा पास शुरू करें। अगर कुंजी आपके लिए नई है, तो API कुंजी क्या है और इसे कैसे संग्रहीत करें पाँच मिनट लेता है।


