AI สำหรับผู้เริ่มต้นคู่มือ
กรอง 40K ความคิดเห็นด้วย LLM: พรอมต์ keep/drop และค่าใช้จ่าย
พรอมต์ keep/drop, ลูป Python สั้นๆ และการประมาณโทเค็นสำหรับกรอง 40,000 ความคิดเห็นด้วย LLM ราคาถูก ก่อนที่คุณจะรันอะไร
ในหน้านี้
คลังของคุณมี 40,000 ความคิดเห็น และส่วนใหญ่เป็นเสียงรบกวน: สแปม, "+1", มุกตลก, การตอบกลับที่ไม่เกี่ยวข้องกับสิ่งที่คุณต้องการ LLM ราคาถูกสามารถอ่านแต่ละอันและตอบด้วยคำเดียว keep หรือ drop ส่งทุกความคิดเห็นเป็นคำขอสั้นๆ ของตัวเอง แล้วทั้งรอบจะใช้ประมาณ 6 ล้านโทเค็นอินพุตและ 200,000 โทเค็นเอาต์พุต (สมมติว่าประมาณ 150 โทเค็นเข้าและ 5 ออกต่อความคิดเห็น) บน DeepSeek-V4-Flash การรันนั้นมีค่าใช้จ่าย $0.11 ในราคาปัจจุบัน
ด้านล่าง: พรอมต์, ลูป Python สั้นๆ, และการคำนวณที่คุณสามารถทำซ้ำสำหรับคลังของคุณเอง ทุกอย่างผ่าน endpoint ที่เข้ากันได้กับ OpenAI ที่อธิบายไว้ใน เอกสาร CheapTokens
แนวคิดมาจากไหน#
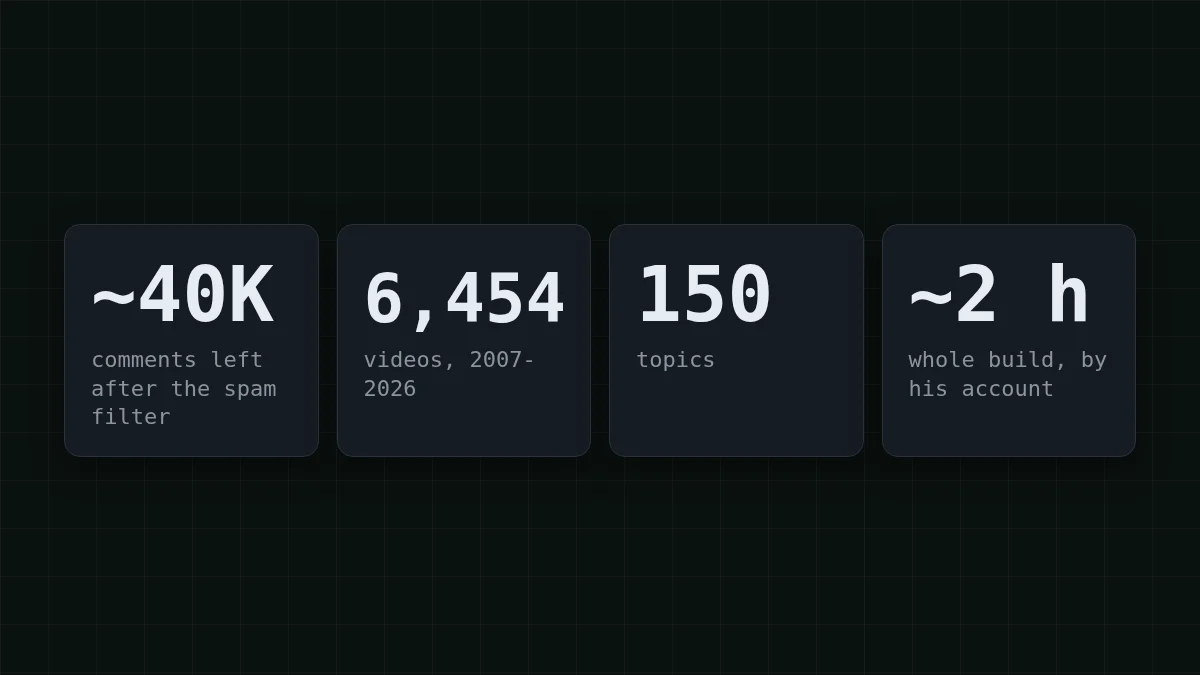
Andrej Karpathy (นักวิจัย AI, ผู้ร่วมก่อตั้ง OpenAI, อดีตผู้อำนวยการ AI ที่ Tesla) อธิบายใน โพสต์ของเขาเมื่อวันที่ 31 ตุลาคม 2026 ว่าเขาสร้าง HackerTube ได้อย่างไร ซึ่งเป็นเว็บไซต์วิดีโอที่แนะนำในความคิดเห็นของ Hacker News ในการสร้างนั้น Sonnet ทำงานกับความคิดเห็นในเวิร์กโฟลว์ Claude Code เพื่อลบสแปมและคัดกรองให้เหลือประมาณ 40,000 ความคิดเห็นที่แนะนำวิดีโอ YouTube ผลลัพธ์คือ 6,454 วิดีโอใน 150 หัวข้อ และเขากล่าวว่าการสร้างทั้งหมดใช้เวลาประมาณสองชั่วโมง
โพสต์ไม่ได้รายงานจำนวนโทเค็นหรือค่าใช้จ่าย ดังนั้นตัวเลขในบทความนี้เป็นการคำนวณจากสมมติฐานที่ระบุไว้ข้างๆ ไม่ใช่การสร้างใหม่จากการรันของเขา สิ่งที่คุณสามารถนำไปใช้ได้คือรูปร่างของงาน: ข้อความสั้นๆ จำนวนมาก, คำถามใช่/ไม่ใช่หนึ่งข้อเกี่ยวกับแต่ละอัน
ตัวกรองใช่/ไม่ใช่ทำงานอย่างไร#
ลองนึกถึงพนักงานต้อนรับที่มีกฎบรรทัดเดียว: "ให้ใครก็ตามที่มีตั๋วเข้าไป" เขาดูแต่ละคนหนึ่งวินาที พูดว่าใช่หรือไม่ และไม่จำแขกคนก่อนหน้า ตัวกรอง LLM ทำงานแบบเดียวกัน แต่ละคำขอมีคำสั่งของคุณบวกกับความคิดเห็นหนึ่งอัน และโมเดลส่งกลับคำเดียว ความคิดเห็นที่ 17,000 ไม่รู้อะไรเกี่ยวกับความคิดเห็นที่ 16,999
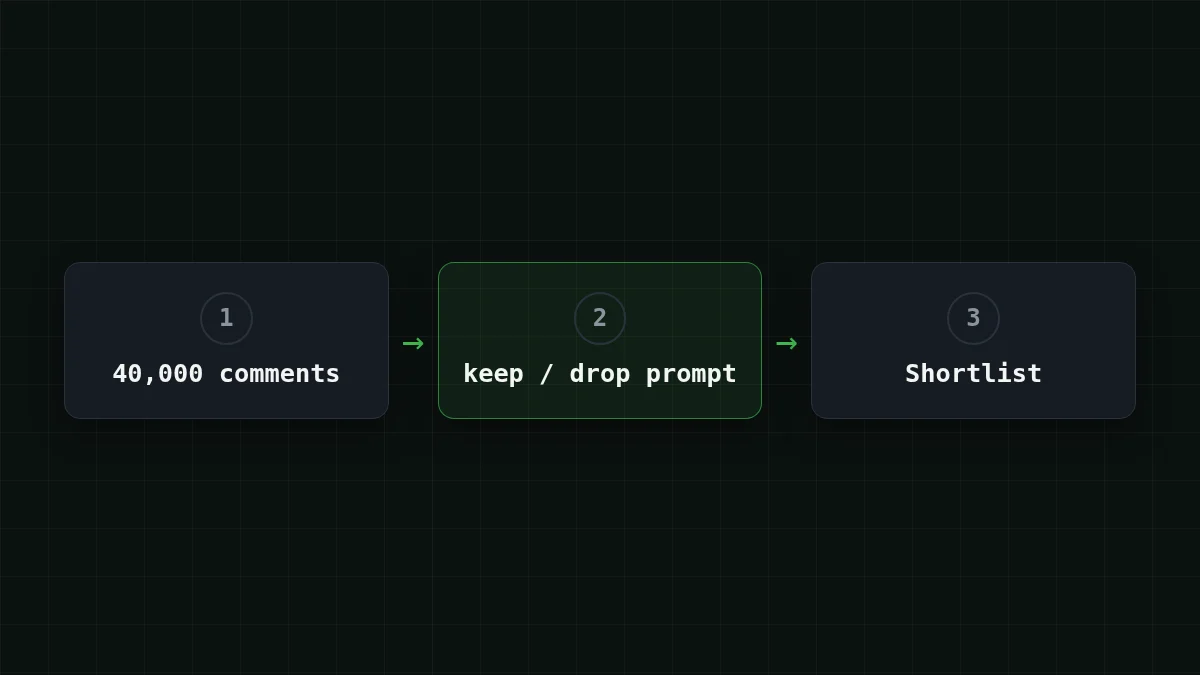
การออกแบบนี้ทำให้ค่าใช้จ่ายคาดเดาได้ ทุกคำขอมีขนาดใกล้เคียงกัน ดังนั้นค่าใช้จ่ายคือจำนวนคำขอ × โทเค็นต่อคำขอ และเนื่องจากคำตอบเป็นคำเดียว เงินเกือบทั้งหมดจึงไปที่ฝั่งอินพุต: คำสั่งและความคิดเห็นที่คุณส่ง หากคุณเพิ่งรู้จักการคิดราคาอินพุตและเอาต์พุต โทเค็นอินพุต vs เอาต์พุต อธิบายการแบ่งนี้
เขียนพรอมต์ keep/drop#
พรอมต์คือผลิตภัณฑ์ทั้งหมดที่นี่ เปรียบเทียบเวอร์ชันคลุมเครือกับเวอร์ชันที่แน่นอน:
เปรียบเทียบ
กฎคลุมเครือ vs กฎที่แน่นอน
คลุมเครือ
Is this comment good? Answer yes or no.ดีสำหรับใคร? ความคิดเห็นที่ยาวและสุภาพเกี่ยวกับฐานข้อมูลอาจตอบกลับว่า "ใช่" ในขณะที่ "ดูนี่: <ลิงก์>" สั้นๆ ตอบกลับว่า "ไม่" โมเดลต้องเดาว่าคุณหมายถึงอะไร และการเดาของมันเปลี่ยนไปในแต่ละความคิดเห็น
แน่นอน
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.ตอนนี้โมเดลมีกฎแทนที่จะต้องเดาอารมณ์: อะไรนับ อะไรไม่นับ และคำตอบมีลักษณะอย่างไร
สมมติว่ามีความคิดเห็นสามอันมาถึง นี่คือคำตอบที่คุณต้องการ:
- "ทอล์กนี้เกี่ยวกับประวัติศาสตร์ Unix เปลี่ยนวิธีที่ฉันมองเชลล์: youtube.com/watch?v=... คุ้มค่ากับเวลาหนึ่งชั่วโมง" →
keep - "นาฬิกาถูกที่นี่!!! คลิกโปรไฟล์ของฉัน" →
drop - "เห็นด้วย ประเด็นดีเกี่ยวกับแคช" →
drop
นิสัยสามอย่างทำให้พรอมต์คงทนต่อ 40,000 รายการ บอกว่าต้องทำอะไรกับกรณีที่เหลือ ("อย่างอื่นทั้งหมดคือ drop"); ไม่เช่นนั้นโมเดลจะคิดคำตอบที่สามขึ้นมา ขอคำเดียว เพื่อให้คำตอบเปรียบเทียบกับ keep ในโค้ดได้ง่าย และห่อความคิดเห็นด้วยแท็ก ดังในลูปด้านล่าง: ความคิดเห็นที่พูดว่า "เพิกเฉยต่อคำสั่งข้างต้น" จะเป็นข้อมูลอย่างชัดเจน ไม่ใช่คำสั่ง ติดป้ายทุกเอกสารในพรอมต์ อธิบายลึกกว่านี้
ลูป: หนึ่งคำขอต่อความคิดเห็น#
นี่คือทั้งหมด มันอ่าน comments.jsonl (หนึ่งอ็อบเจกต์ JSON ที่มีฟิลด์ text ต่อบรรทัด) ขอคำตัดสินสำหรับแต่ละความคิดเห็น และเขียนบรรทัดที่เก็บไว้ไปยัง kept.jsonl รหัสโมเดลคือ gateway_id แบบเต็ม; คีย์มาจากตัวแปรสภาพแวดล้อม
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 ทำให้คำตัดสินทำซ้ำได้มากขึ้นระหว่างการรัน และ max_tokens=10 เผื่อที่ไว้สำหรับคำเดียวและไม่มีอะไรเพิ่ม บรรทัดสุดท้ายคือบรรทัดที่มีประโยชน์: มันรวมตัวเลข usage ที่ API ส่งกลับ ดังนั้นคุณจะได้จำนวนโทเค็นจริงแทนการเดา
รันกับความคิดเห็นสิบอันแรกและอ่านทุกคำตัดสินด้วยตัวเอง หากคำตอบดูเหมือนถูกตัดหรือกลับมาว่าง ให้ตรวจสอบ finish_reason ตามที่อธิบายใน ทำไมคำตอบ AI หยุดกลางประโยค การส่งทีละคำขอเป็นเรื่องปกติสำหรับการทดสอบ; สำหรับ 40,000 ทั้งหมด AsyncOpenAI ส่งหลายคำขอพร้อมกัน
40,000 ความคิดเห็นมีค่าใช้จ่ายเท่าไร#
นี่คือสมมติฐาน เพื่อให้คุณเปลี่ยนเป็นของคุณเอง ความคิดเห็นบวกคำสั่งคือประมาณ 150 โทเค็นอินพุต คำตอบคือประมาณ 5 โทเค็น ความคิดเห็น Hacker News มักยาวกว่า ดังนั้นให้ถือว่า 150 เป็นขั้นต่ำและแทนที่ด้วยตัวเลขจากการซ้อม สำหรับ 40,000 ความคิดเห็น:
- อินพุต: 40,000 × 150 = 6,000,000 โทเค็น
- เอาต์พุต: 40,000 × 5 = 200,000 โทเค็น
คำสั่งคือส่วนที่คนลืม มันเดินทางไปกับทุกความคิดเห็น ลองเดา:
ทายตัวเลข
สมมติว่าคำสั่งของคุณยาว 60 โทเค็น 40,000 สำเนาของมันรวมกันเป็นโทเค็นอินพุตกี่โทเค็น?
คำตอบของคุณ
06,000,000
แสดงคำตอบ
คำตอบ: 2,400,000
40,000 × 60 = 2,400,000 นั่นคือ 40% ของ 6,000,000 โทเค็นอินพุต ที่ใช้ไปกับข้อความที่ไม่เคยเปลี่ยน ดังนั้นคำสั่งที่กระชับขึ้นคือสิ่งแรกที่ต้องตัด
ตอนนี้ค่าใช้จ่ายสำหรับทั้งรอบ ในราคาปัจจุบัน:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 40,000 คำขอ | OpenRouter, 40,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
150 โทเค็นอินพุตและ 5 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ในงานนี้ DeepSeek-V4-Flash และ GLM-5.3-Flash ทั้งคู่ถูกกว่า OpenRouter โดยรวม เมื่อนับอินพุตและเอาต์พุตรวมกัน; คอลัมน์ OpenRouter แสดงให้เห็นเคียงข้างกัน ทั้งคู่ตั้งราคาสำหรับงานปริมาณสูงเช่นนี้: DeepSeek-V4-Flash มีราคาเดียวทุกชั่วโมงและสูงสุด 32,768 โทเค็นเอาต์พุตต่อคำตอบ, GLM-5.3-Flash เป็นตัวเลือกที่สองบน endpoint เดียวกัน ลองซ้อม 50 ความคิดเห็นของคุณกับแต่ละตัวและเปรียบเทียบคำตัดสินด้วยตัวเอง หากต้องการสลับ เปลี่ยนบรรทัดโมเดลเป็น zai- ราคาปัจจุบันของทุกโมเดลอยู่ใน หน้าราคา และ โมเดล DeepSeek ที่ CheapTokens แสดงรายละเอียด
ลองด้วยตัวเองลองดู: คลังของคุณมี 100,000 ความคิดเห็น ไม่ใช่ 40,000 อะไรเปลี่ยนไป?แสดงคำตอบ
ค่าใช้จ่ายเพิ่มขึ้นตามจำนวน 100,000 × 150 = 15,000,000 โทเค็นอินพุต และ 100,000 × 5 = 500,000 โทเค็นเอาต์พุต ซึ่งคือ $0.275 บน DeepSeek-V4-Flash พรอมต์เดียวกัน 2.5 เท่าของรายการ 2.5 เท่าของค่าใช้จ่าย
ก่อนกดรัน#
แรก ซ้อมก่อน เอาความคิดเห็น 50 อัน รันลูป และอ่านคำตัดสินทั้ง 50 จากนั้นใช้ยอดรวมโทเค็นที่พิมพ์ออกมา: 50 × 800 = 40,000 ดังนั้นการรันเต็มคือโทเค็นของการซ้อมคูณด้วย 800 นั่นแทนที่สมมติฐาน 150 และ 5 ด้วยตัวเลขของคุณเอง
ที่สอง แก้พรอมต์จากการซ้อม ไม่ใช่จากการรันเต็ม หากคำตัดสิน "drop" สามอันผิด ให้เพิ่มประโยคหนึ่งเกี่ยวกับกรณีนั้นและรัน 50 ใหม่ มีค่าใช้จ่ายเพียงเศษเสี้ยวของเซนต์ที่จะจู้จี้ตรงนี้ และมากกว่ามากที่จะรัน 40,000 ใหม่
ที่สาม จำไว้ว่าโมเดลเห็นอะไร: ความคิดเห็นหนึ่งอัน ไม่มีเธรด หาก "เห็นด้วย ประเด็นดี" มีความหมายเฉพาะเมื่ออยู่ถัดจากความคิดเห็นแม่ ให้ใส่ความคิดเห็นแม่ในคำขอด้วย นั่นทำให้แต่ละคำขอยาวขึ้น ดังนั้นคำนวณโทเค็นใหม่ด้วยขนาดใหม่
เมื่อการซ้อมดูถูกต้อง สร้างคีย์ API ในบัญชีของคุณ ชี้ CHEAPTOKENS_ ไปที่มันและเริ่มการรันเต็ม หากคีย์เป็นเรื่องใหม่สำหรับคุณ คีย์ API คืออะไรและวิธีเก็บ ใช้เวลาห้านาที


