نئے سیکھنے والوں کے لیے AIگائیڈ
LLM سے 40K تبصروں کو فلٹر کریں: رکھیں/چھوڑیں پرامپٹ اور لاگت
ایک رکھیں/چھوڑیں پرامپٹ، ایک مختصر Python لوپ اور 40,000 تبصروں کو سستے LLM سے فلٹر کرنے کا ٹوکن تخمینہ، کچھ چلانے سے پہلے۔
اس صفحہ پر
آپ کے آرکائیو میں 40,000 تبصرے ہیں، اور ان میں سے زیادہ تر شور ہیں: اسپام، "+1"، لطیفے، ایسے جوابات جن کا آپ کی مطلوبہ چیز سے کوئی تعلق نہیں۔ ایک سستا LLM ہر ایک کو پڑھ کر ایک لفظ میں جواب دے سکتا ہے، keep یا drop۔ ہر تبصرے کو اس کی اپنی مختصر درخواست کے طور پر بھیجیں تو پورا پاس تقریباً 6 ملین ان پٹ ٹوکنز اور 200 ہزار آؤٹ پٹ ٹوکنز بنتا ہے (فرض کرتے ہوئے کہ فی تبصرہ تقریباً 150 ٹوکنز اندر اور 5 باہر)۔ DeepSeek-V4-Flash پر یہ رن موجودہ قیمت پر $0.11 لاگت کرتا ہے۔
نیچے: پرامپٹ، ایک مختصر Python لوپ، اور وہ حساب جو آپ اپنے آرکائیو کے لیے دوبارہ کر سکتے ہیں۔ سب کچھ CheapTokens docs میں بیان کردہ OpenAI-compatible endpoint کے ذریعے جاتا ہے۔
یہ خیال کہاں سے آیا#
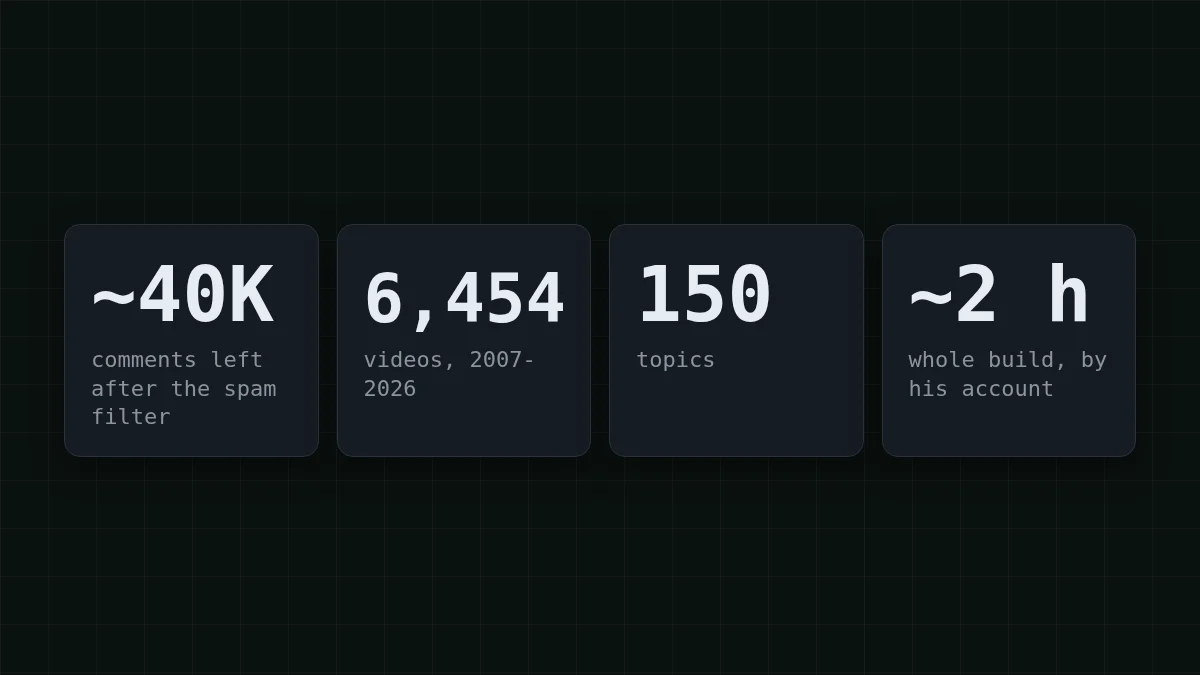
Andrej Karpathy (AI محقق، OpenAI کے شریک بانی، Tesla میں سابق AI ڈائریکٹر) نے 31 اکتوبر 2026 کی اپنی پوسٹ میں بتایا کہ انہوں نے HackerTube کیسے بنایا، جو Hacker News کے تبصروں میں تجویز کردہ ویڈیوز کی سائٹ ہے۔ اس بلڈ میں، Sonnet نے Claude Code ورک فلو میں تبصروں پر رن کیا تاکہ اسپام ہٹایا جائے اور انہیں تقریباً 40,000 تبصروں تک محدود کیا جائے جو YouTube ویڈیوز تجویز کرتے ہیں۔ نتیجہ 150 موضوعات میں 6,454 ویڈیوز تھا، اور وہ کہتے ہیں کہ پورا بلڈ اب تقریباً دو گھنٹے لیتا ہے۔
پوسٹ میں ٹوکن کی گنتی یا لاگت نہیں بتائی گئی۔ لہٰذا اس مضمون کے اعداد و شمار ان مفروضوں سے کیے گئے حساب ہیں جو ان کے ساتھ ہی بیان کیے گئے ہیں، ان کے رن کی تعمیر نو نہیں۔ آپ جو چیز مستعار لے سکتے ہیں وہ کام کی شکل ہے: بہت سے مختصر متن، ہر ایک کے بارے میں ایک ہاں/نہیں سوال۔
ہاں/نہیں فلٹر کیسے کام کرتا ہے#
ایک دربان کا تصور کریں جس کا ایک سطری اصول ہے: "ٹکٹ والے کو اندر آنے دو"۔ وہ ہر شخص کو ایک سیکنڈ دیکھتا ہے، ہاں یا نہیں کہتا ہے، اور پچھلے مہمان کو کبھی یاد نہیں رکھتا۔ LLM فلٹر اسی طرح کام کرتا ہے۔ ہر درخواست میں آپ کی ہدایت اور ایک تبصرہ ہوتا ہے، اور ماڈل ایک لفظ واپس بھیجتا ہے۔ تبصرہ 17,000 کو تبصرہ 16,999 کے بارے میں کچھ نہیں معلوم۔
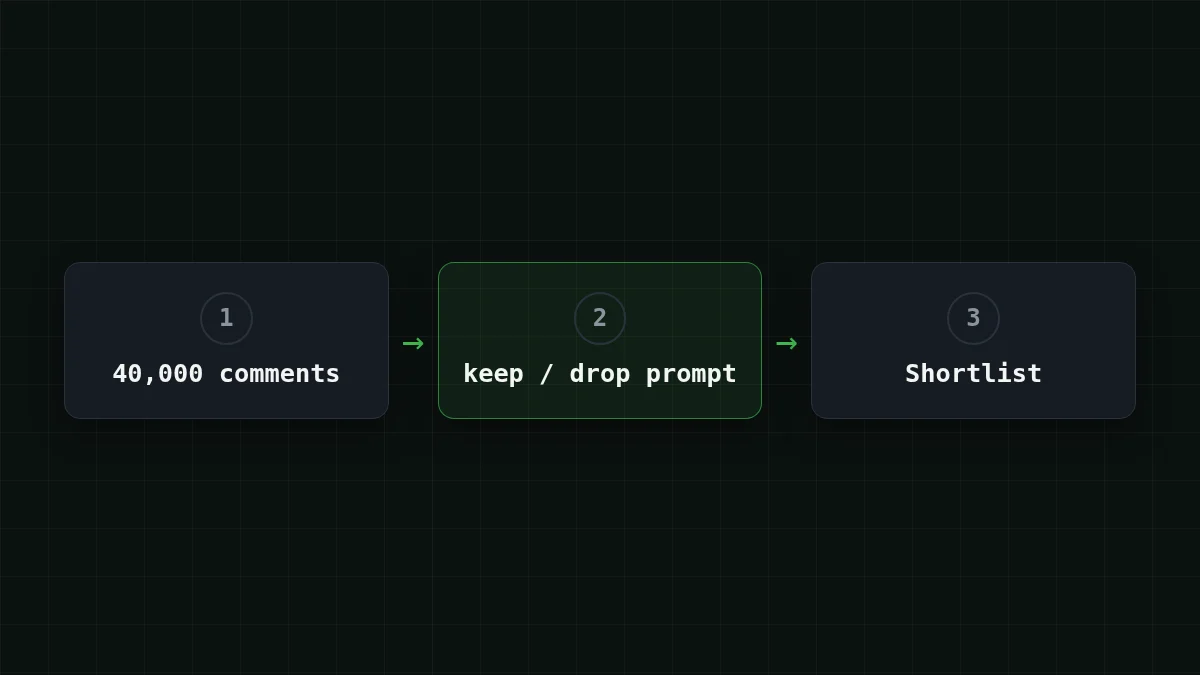
یہی ڈیزائن وجہ ہے کہ بل قابلِ پیش گوئی ہے۔ ہر درخواست کا سائز تقریباً یکساں ہوتا ہے، لہٰذا لاگت = درخواستیں × فی درخواست ٹوکنز۔ اور چونکہ جواب ایک لفظ ہے، تقریباً سارا پیسہ ان پٹ کی طرف جاتا ہے: ہدایت اور تبصرہ جو آپ بھیجتے ہیں۔ اگر ان پٹ اور آؤٹ پٹ کی قیمت آپ کے لیے نئی ہے، تو input vs output tokens اس تقسیم کی وضاحت کرتا ہے۔
رکھیں/چھوڑیں پرامپٹ لکھیں#
یہاں پرامپٹ ہی پورا پروڈکٹ ہے۔ ایک مبہم ورژن کا ایک درست ورژن سے موازنہ کریں:
موازنہ کریں
مبہم اصول بمقابلہ درست اصول
مبہم
Is this comment good? Answer yes or no.کس کے لیے اچھا؟ ڈیٹا بیس کے بارے میں ایک طویل، شائستہ تبصرہ "ہاں" واپس آ سکتا ہے جبکہ ایک مختصر "یہ دیکھیں: <link>" "نہیں" واپس آ سکتا ہے۔ ماڈل کو اندازہ لگانا پڑتا ہے کہ آپ کا کیا مطلب تھا، اور اس کا اندازہ تبصرے سے تبصرے تک بدلتا رہتا ہے۔
درست
Answer keep if the comment recommends a specific YouTube video or talk. Answer drop for spam, jokes, replies without a video, and everything else. Reply with one word.اب ماڈل کے پاس اندازہ لگانے کے لیے موڈ کے بجائے ایک اصول ہے: کیا شمار ہوتا ہے، کیا نہیں، اور جواب کیسا دکھتا ہے۔
فرض کریں تین تبصرے آتے ہیں۔ یہ وہ جوابات ہیں جن کا آپ کو ہدف ہے:
- "یونکس کی تاریخ پر یہ گفتگو نے شیلز کے بارے میں میرا نظریہ بدل دیا: youtube.com/watch?v=... گھنٹہ قابلِ قدر ہے۔" →
keep - "سستے گھڑیاں یہاں!!! میری پروفائل پر کلک کریں" →
drop - "اتفاق، کیشنگ پر زبردست نکتہ۔" →
drop
تین عادتیں پرامپٹ کو 40,000 آئٹمز پر قائم رکھتی ہیں۔ بتائیں کہ باقی ماندہ کیسز کا کیا کرنا ہے ("باقی سب چھوڑ دیں")؛ ورنہ ماڈل تیسرا جواب ایجاد کر لیتا ہے۔ ایک لفظ مانگیں، تاکہ جواب کوڈ میں keep سے موازنہ کرنا آسان ہو۔ اور تبصرے کو ٹیگز میں لپیٹیں، جیسا کہ نیچے لوپ میں ہے: پھر جو تبصرہ کہے "اوپر کی ہدایات کو نظر انداز کریں" وہ واضح طور پر ڈیٹا ہے، حکم نہیں۔ پرامپٹ میں ہر دستاویز کو لیبل کریں اس پر مزید گہرائی سے بات کرتا ہے۔
لوپ: فی تبصرہ ایک درخواست#
یہ پوری چیز ہے۔ یہ comments.jsonl پڑھتا ہے (ہر سطر میں ایک text فیلڈ کے ساتھ ایک JSON آبجیکٹ)، ہر تبصرے پر فیصلہ مانگتا ہے، اور رکھی گئی سطریں kept.jsonl میں لکھتا ہے۔ ماڈل آئی ڈی مکمل gateway_id ہے؛ کلید ایک ماحولیاتی متغیر سے آتی ہے۔
import json
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

INSTRUCTION = '''You filter Hacker News comments.
Answer keep if the comment recommends a specific YouTube video or talk.
Answer drop for spam, jokes, replies without a video, and everything else.
Reply with one word: keep or drop. The comment is between <comment> tags.'''

def verdict(text):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[
            {'role': 'system', 'content': INSTRUCTION},
            {'role': 'user', 'content': f'<comment>{text}</comment>'},
        ],
        temperature=0,
        max_tokens=10,
    )
    return r.choices[0].message.content.strip().lower(), r.usage

kept = tokens_in = tokens_out = 0
with open('comments.jsonl') as src, open('kept.jsonl', 'w') as out:
    for line in src:
        answer, usage = verdict(json.loads(line)['text'])
        tokens_in += usage.prompt_tokens
        tokens_out += usage.completion_tokens
        if answer.startswith('keep'):
            out.write(line)
            kept += 1

print(kept, 'kept;', tokens_in, 'tokens in,', tokens_out, 'tokens out')
temperature=0 فیصلوں کو رنز کے درمیان زیادہ قابلِ تکرار بناتا ہے، اور max_tokens=10 ایک لفظ اور اس سے زیادہ کچھ نہیں کے لیے جگہ چھوڑتا ہے۔ آخری سطر مفید ہے: یہ API کے واپس کردہ usage نمبروں کو جمع کرتی ہے، تاکہ آپ کو اندازے کے بجائے اپنے حقیقی ٹوکن کی گنتی ملے۔
پہلے دس تبصروں پر اسے چلائیں اور ہر فیصلہ خود پڑھیں۔ اگر کوئی جواب کٹا ہوا لگے یا خالی واپس آئے، تو finish_reason چیک کریں جیسا کہ AI جواب درمیان جملے میں کیوں رک جاتا ہے میں بیان کیا گیا ہے۔ ٹیسٹ کے لیے ایک وقت میں ایک درخواست ٹھیک ہے؛ پورے 40,000 کے لیے، AsyncOpenAI بہت سے متوازی بھیجتا ہے۔
40,000 تبصروں کی لاگت#
یہاں مفروضے ہیں، تاکہ آپ اپنے شامل کر سکیں۔ ایک تبصرہ اور ہدایت مل کر تقریباً 150 ٹوکنز ان پٹ ہیں۔ جواب تقریباً 5 ٹوکنز ہے۔ Hacker News کے تبصرے اکثر لمبے ہوتے ہیں، لہٰذا 150 کو کم از کم سمجھیں اور اسے ریہرسل کے نمبروں سے بدل دیں۔ 40,000 تبصروں کے لیے:
- ان پٹ: 40,000 × 150 = 6,000,000 ٹوکنز
- آؤٹ پٹ: 40,000 × 5 = 200,000 ٹوکنز
ہدایت وہ حصہ ہے جو لوگ بھول جاتے ہیں۔ یہ ہر ایک تبصرے کے ساتھ سفر کرتی ہے۔ ایک اندازہ لگائیں:
نمبر کا اندازہ لگائیں
فرض کریں آپ کی ہدایت 60 ٹوکنز لمبی ہے۔ اس کی 40,000 کاپیاں مل کر کتنے ان پٹ ٹوکنز بناتی ہیں؟
آپ کا اندازہ
06,000,000
جواب دکھائیں
جواب: 2,400,000
40,000 × 60 = 2,400,000۔ یہ 6,000,000 ان پٹ ٹوکنز کا 40% ہے، جو ایسے متن پر خرچ ہوتا ہے جو کبھی نہیں بدلتا، لہٰذا زیادہ مختصر ہدایت پہلی چیز ہے جسے کم کرنا ہے۔
اب پورے پاس کا بل، لائیو قیمتوں پر:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 40,000 درخواستیں | OpenRouter، 40,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0000032 | $0.128 | $0.218 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0000028 | $0.11 | $0.448 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0000083 | $0.33 | $3.96 |
فی درخواست 150 ان پٹ اور 5 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
اس کام کے بوجھ پر، DeepSeek-V4-Flash اور GLM-5.3-Flash دونوں مجموعی طور پر OpenRouter سے سستے نکلتے ہیں، ان پٹ اور آؤٹ پٹ کو ملا کر شمار کیا جائے؛ OpenRouter کالم اسے ساتھ ساتھ دکھاتا ہے۔ دونوں اس طرح کے زیادہ حجم والے کام کے لیے قیمت شدہ ہیں: DeepSeek-V4-Flash کی کسی بھی وقت ایک قیمت ہے اور فی جواب 32,768 آؤٹ پٹ ٹوکنز تک، GLM-5.3-Flash اسی endpoint پر دوسرا آپشن ہے۔ اپنی 50-تبصرہ ریہرسل ہر ایک پر آزمائیں اور فیصلوں کا خود موازنہ کریں۔ تبدیل کرنے کے لیے، ماڈل لائن کو zai- میں بدلیں۔ ہر ماڈل کی موجودہ قیمتیں pricing page پر ہیں، اور DeepSeek models at CheapTokens تفصیلات کی فہرست دیتا ہے۔
خود آزمائیںآزمائیں: آپ کے آرکائیو میں 40,000 نہیں بلکہ 100,000 تبصرے ہیں۔ کیا بدلتا ہے؟جواب دکھائیں
بل گنتی کے ساتھ ساتھ بڑھتا ہے۔ 100,000 × 150 = 15,000,000 ان پٹ ٹوکنز اور 100,000 × 5 = 500,000 آؤٹ پٹ ٹوکنز، جو DeepSeek-V4-Flash پر $0.275 ہے۔ وہی پرامپٹ، 2.5 گنا آئٹمز، 2.5 گنا لاگت۔
رن دبانے سے پہلے#
پہلے، ایک ریہرسل۔ 50 تبصرے لیں، لوپ چلائیں، اور تمام 50 فیصلے پڑھیں۔ پھر پرنٹ شدہ ٹوکن کے مجموعے استعمال کریں: 50 × 800 = 40,000، لہٰذا پورا رن ریہرسل کے ٹوکنز کو 800 سے ضرب دے کر ہے۔ یہ 150-اور-5 کے مفروضے کو آپ کے اپنے نمبروں سے بدل دیتا ہے۔
دوسرا، پرامپٹ کو ریہرسل پر درست کریں، پورے رن پر نہیں۔ اگر تین "چھوڑیں" فیصلے غلط ہیں، تو اس کیس کے بارے میں ایک جملہ شامل کریں اور 50 دوبارہ چلائیں۔ یہاں نکتہ چینی کرنے میں ایک سینٹ کا حصہ لگتا ہے، اور 40,000 دوبارہ چلانے میں بہت زیادہ۔
تیسرا، یاد رکھیں کہ ماڈل کیا دیکھتا ہے: ایک تبصرہ، کوئی تھریڈ نہیں۔ اگر "اتفاق، زبردست نکتہ" صرف والدین تبصرے کے ساتھ معنی رکھتا ہے، تو والدین کو بھی درخواست میں شامل کریں۔ اس سے ہر درخواست لمبی ہو جاتی ہے، لہٰذا نئے سائز کے ساتھ ٹوکن کا حساب دوبارہ کریں۔
جب ریہرسل درست لگے، تو اپنے اکاؤنٹ میں API کلید بنائیں، CHEAPTOKENS_ کو اس کی طرف اشارہ کریں اور پورا پاس شروع کریں۔ اگر کلید آپ کے لیے نئی ہے، تو API کلید کیا ہے اور اسے کیسے محفوظ کریں پانچ منٹ لیتا ہے۔


